Mantis

Редакция Mantis

Модели

Свежие материалы редакции по первоисточникам. Сначала — последние публикации Mantis; дата источника указана отдельно.

Модели

«Тот же Flash, другие цифры»: DeepSeek выпустила V4.1-Flash-1017 и открыла Search & Fetch API всем

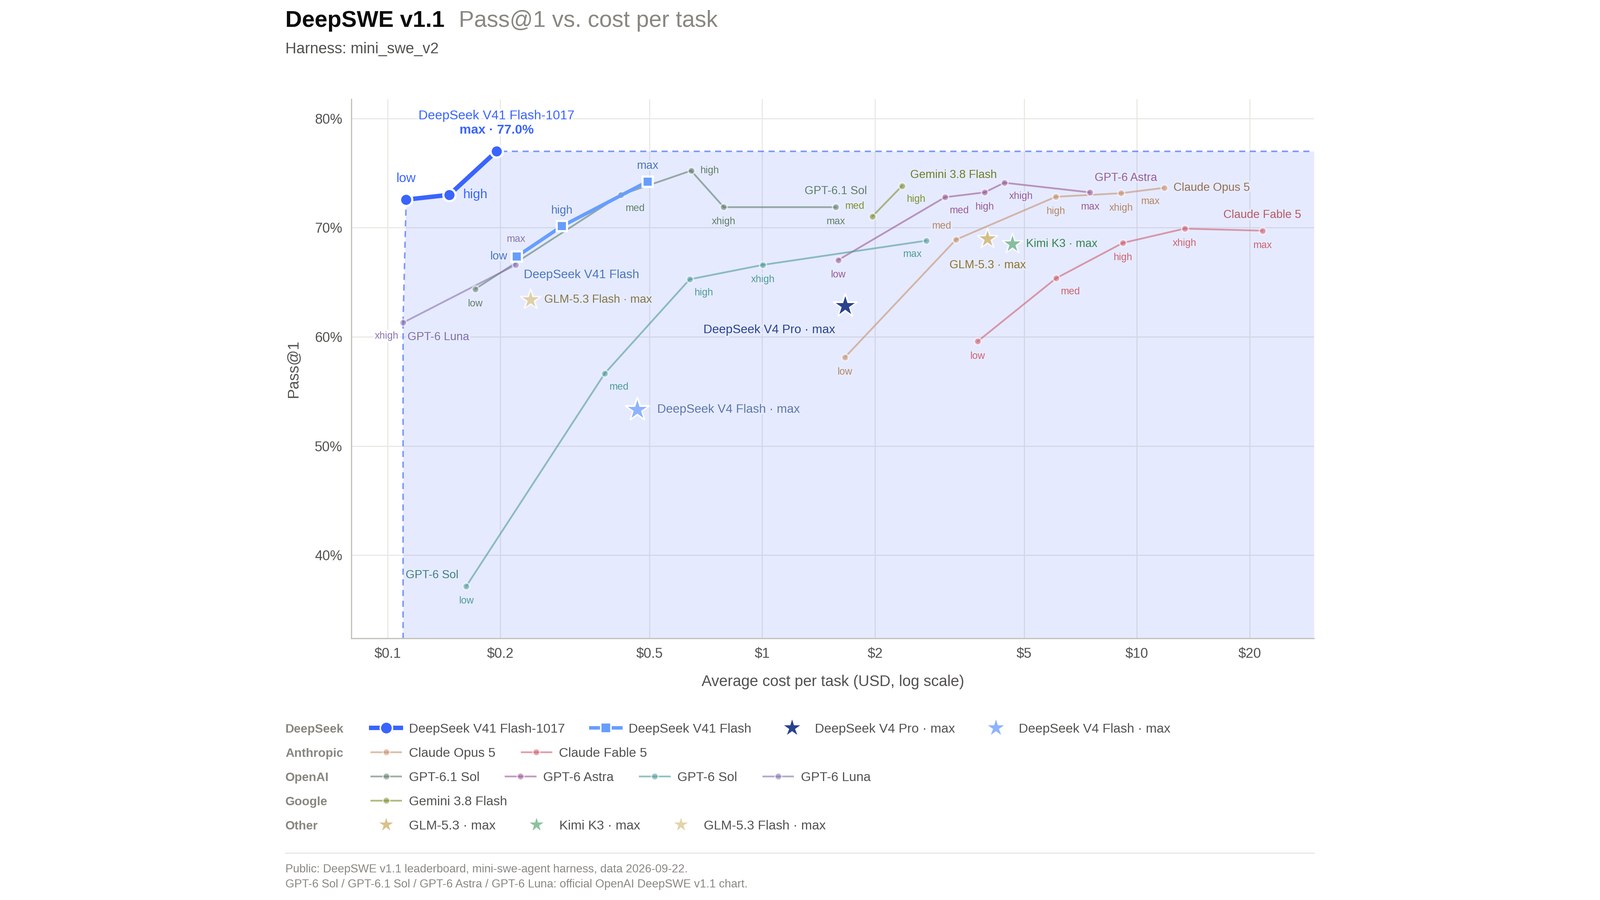
17 октября DeepSeek выложила DeepSeek-V4.1-Flash-1017 — точечное обновление Flash, в котором выросли бенчмарки, сократилось время решения задач и длина ответов[1][2]. Компания называет результат улучшением по Парето в паре «производительность — стоимость» и уже включила модель на сайте, в приложении и в API[1]. В тот же день Search и Fetch API открыли всем: по 0,75 доллара за тысячу успешных вызовов каждого эндпоинта, а до 31 октября вызовы через серверные инструменты в DeepSeek Harness, Claude Code и Codex остаются бесплатными[1][3].
В Mantis: Первоисточник: 17 октября 2026
Модели

«Веса вышли»: 501B-модель Beam от Reflection открыта на Hugging Face под Apache 2.0 — с поддержкой transformers, vLLM и SGLang в день релиза

16 октября Reflection выложила веса Beam на Hugging Face под лицензией Apache 2.0: разреженная MoE-модель на 501 млрд параметров (23 млрд активных на токен) с окном контекста 1M токенов[1][3]. Веса лежат в трёх точностях — BF16, FP8 и NVFP4, а с первого дня модель поддержана в transformers, vLLM и SGLang[1][3]. Серверный доступ открыт через Inference Providers на Baseten, Fireworks и Together; для собственного развёртывания HF советует планировать четыре B200[1]. Авторы поста отдельно оговаривают, что приведённые в нём бенчмарки предоставила команда Reflection и независимо не проверялись[1].
В Mantis: Первоисточник: 16 октября 2026
Модели

«Одна модель вместо команды ранжирования»: AutoTrust показала ленты и поиск на решениях JEV-27B-VL

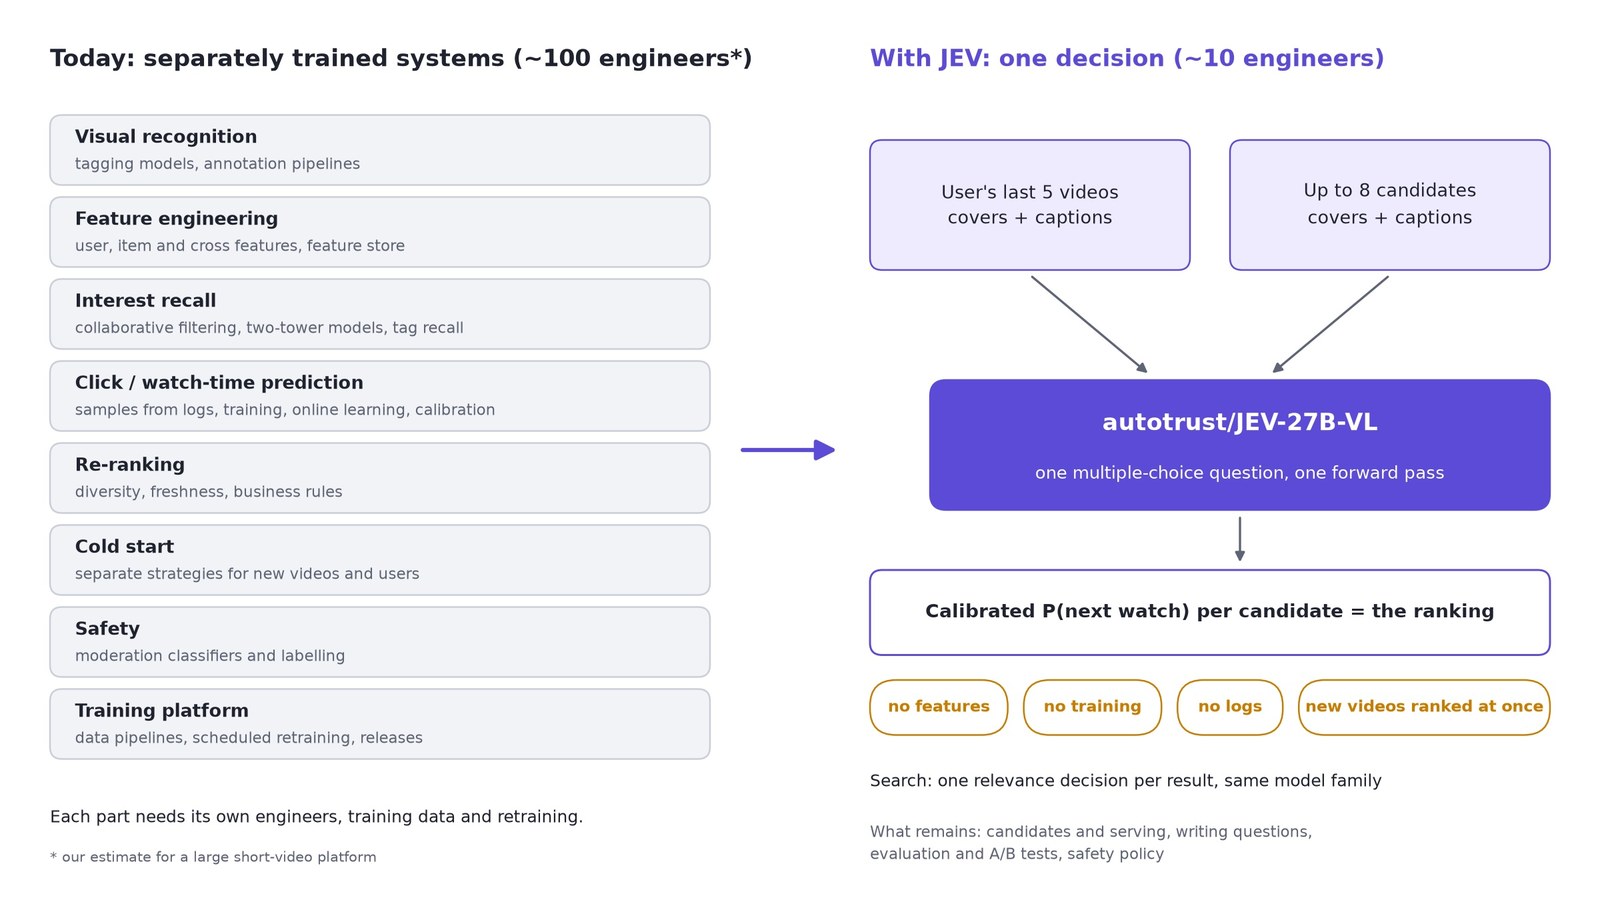
13 октября 2026 года лаборатория AutoTrust AI Lab опубликовала на Hugging Face разбор двух своих демонстраций — ленты коротких видео shorts.guru.so и новостного поиска news.guru.so[1]. В обеих весь привычный конвейер рекомендаций заменён одной моделью решений: она смотрит, что пользователь смотрел последним, и на кандидатов — и за один прямой проход выдаёт калиброванную вероятность для каждого варианта, а сами вероятности и становятся порядком выдачи[1]. Ничего для продукта не обучалось, признаки не проектировались, а логи не нужны до первой рекомендации[1]. По обложкам модель догоняет коллаборативную фильтрацию, обученную на истории просмотров 59 045 человек (AUC 0,727 против 0,728), и обходит её по попаданию в топ-5 (59 % против 49 %)[1][2].

В Mantis: Первоисточник: 13 октября 2026
Модели

Чат, решения и расшифровка речи из одной точки: IBM выпустила Granite Switch 4.1 в размерах 8B и 30B

15 октября 2026 года команда IBM Granite опубликовала в блоге на Hugging Face выпуск Granite Switch 4.1 — сборки Granite-Switch-4.1-8B и -30B. Внутри одной модели соединены базовая Granite 4.1, адаптеры Activated LoRA для решений и безопасности и встроенный энкодер распознавания речи, так что чат, решения и speech-to-text обслуживает один endpoint. Обе карточки моделей датируют выпуск 14 октября, лицензия — Apache 2.0. IBM заявляет, что специализированный Guardian-адаптер в среднем обходит Jev 1.13, Microsoft-Decision-1, GPT-Luna-Decisions и Clef-Flash на задачах решений о безопасности, а встроенная Granite-Speech-5.0-Turbo-CTC названа самой быстрой ASR-моделью в лидерборде OpenASR. Независимых замеров, цен и дат появления в готовых сервисах ни в одной из трёх публикаций нет.[1][2][3]

В Mantis: Первоисточник: 15 октября 2026
Модели

«Меньше „checking…“»: OpenAI выпустила GPT-Live-1.1 — новые голоса и акценты в ChatGPT Voice

15 октября 2026 года OpenAI сообщила о раскатке GPT-Live-1.1 и GPT-Live-1.1 Quip — уменьшенной версии модели — в голосовом режиме ChatGPT. Обновление добавляет новые голоса с акцентами, которые компания называет более естественными, и меняет служебные реплики: вместо повторяющегося «checking…» модель использует более широкий набор коротких фраз. В релиз-нотах перечислены новые голоса для французского, немецкого, хинди, японского, корейского и мексиканского испанского, а также «Bubbie» для английского, и там же оговорено, что набор голосов зависит от региона и аккаунта. Число голосов — 13 — приводится только в объявлении в сообществе разработчиков. Версию для API оба подробных канала обозначают одинаково — «скоро»: ни даты, ни цен, ни замеров, ни отдельной карточки безопасности для 1.1 ни в одной из трёх публикаций нет.[1][2][3]

В Mantis: Первоисточник: 15 октября 2026
Модели

«Около 1,5 ТБ в BF16 и 18 токенов в секунду в двухбитном кванте»: Hugging Face показала, как Muse Spark Open запускают и дообучают

15 октября 2026 года команда Hugging Face выпустила технический разбор Muse Spark Open — открытой модели Meta на 816 млрд параметров с 42 млрд активных и контекстом до 1 млн токенов. В публикации названо то, чего не было в анонсе самой Meta: контрольная точка BF16 занимает около 1,5 ТБ и в transformers разворачивается на четырёх узлах по восемь GPU H200, 4-битная версия NVFP4 укладывается в один узел B200, двухбитный квант с imatrix-калибровкой даёт 18 токенов в секунду на Mac M3 Ultra с 512 ГБ памяти, а дообучение LoRA на 64 H100 заняло около двух часов и подняло среднюю точность по токенам с 72 % до 84 %.[1]

В Mantis: Первоисточник: 15 октября 2026
Модели

Microsoft AI завершила предобучение MAI-Base-2: 80 млрд активных параметров и в 4–12 раз меньше вычислений, чем у DeepSeek-V4-Pro-Base

15 октября 2026 года Microsoft AI сообщила, что закончила предобучение новой базовой модели MAI-Base-2 — разреженной MoE-модели «mixture of experts» с 80 миллиардами активных и 2,8 триллионами общих параметров.[1] По собственным замерам компании, модель обходит все open-weight модели, которые она тестировала на своих отложенных оценках, и требует в 4,2–12,3 раза меньше вычислений на предобучение, чем сильнейшая открытая базовая модель DeepSeek-V4-Pro-Base.[1] Прогон занял 38 дней августа и сентября 2026 года на 16 тысячах ускорителей GB200; сейчас модель проходит посттренировку, а веса компания рассчитывает лицензировать партнёрам через Microsoft Foundry.[1]

В Mantis: Первоисточник: 15 октября 2026
Модели

«До пяти раз выше пропускная способность»: NVIDIA выпустила открытую Nemotron 3.5 Super VL на 120 млрд параметров и довела Bolt до локальных машин

15 октября 2026 года NVIDIA представила Nemotron 3.5 Super VL — открытую мультимодальную модель на 120 млрд параметров при 12 млрд активных и с контекстом до 1 млн токенов.[1][2] Компания называет её самой быстрой открытой агентной моделью в своём классе: до пяти раз выше пропускная способность, чем у других открытых моделей сопоставимого размера, а на одной GPU — более 600 токенов в секунду на агентных задачах Artificial Analysis Intelligence Index.[1][2] Вместе с ней заявлены edge-модели Nemotron 3.5 Bolt 74B-A9B 24GB и Bolt E4B 4GB: первая доступна сейчас, вторая выйдет 23 октября.[1]

В Mantis: Первоисточник: 15 октября 2026
Модели

«Самая способная открытая модель США на сегодня»: Meta выложила веса Muse Spark Open на 816 млрд параметров

15 октября 2026 года Meta AI Research сообщила о выпуске весов Muse Spark Open — нативно мультимодальной модели на 816 млрд параметров всего и 42 млрд активных с контекстным окном в 1 млн токенов.[1] Компания называет её самой способной открытой моделью из США на сегодня и отдельно подчёркивает, что это первый случай, когда модель такого класса запускается на настольной машине: для этого нужны два Mac Studio с Apple M5 Ultra и свежая версия MLX.[1] Веса распространяются по лицензии Muse Model License с ограниченными коммерческими условиями.[1]

В Mantis: Первоисточник: 15 октября 2026
Модели

«Самая маленькая открытая модель в сравнении»: Black Forest Labs выпустила FLUX 3 Image Klein на 5,6 млрд параметров

15 октября 2026 года Black Forest Labs выпустила FLUX 3 Image Klein — модель с открытыми весами на 5,6 млрд параметров для генерации изображений по тексту, редактирования и работы сразу с несколькими референсами, до десяти.[1] Компания заявляет, что во внутренних сравнениях модель занимает первое место в генерации по тексту, мультиреференсной генерации и редактировании, обходя более крупные открытые модели, и при этом остаётся самой маленькой в сравнении: 11,2 ГБ весов в BF16 и 5,6 ГБ в FP8, а сборка INT8 укладывается в 8 ГБ видеопамяти GeForce RTX.[1] Веса, код и поддержка в ComfyUI и Diffusers опубликованы в день выпуска, а лицензия FLUX Kommunity разрешает бесплатное коммерческое использование при годовой выручке до 5 млн долларов.[1]

В Mantis: Первоисточник: 15 октября 2026
Модели

Mistral выпустила Timestral — семейство моделей прогноза временных рядов на 5–209 млн параметров

15 октября 2026 года Mistral AI выпустила Timestral — первое семейство своих моделей-фундаментов для временных рядов.[1] Модели выходят в четырёх размерах — 5, 28, 123 и 209 млн параметров — и предсказывают не одно число, а набор квантилей, то есть распределение возможных исходов; старшая, по заявлению компании, занимает первое место на всех трёх основных публичных бенчмарках сразу, опережая прежний state of the art при двух третях его параметров.[1] Отдельно Mistral подчёркивает, что модель не требует GPU на инференсе: прогноз на сутки вперёд по трёхнедельной истории занимает 10 мс на версии 5M и 140 мс на версии 209M на обычном серверном процессоре с восемью потоками.[1]

В Mantis: Первоисточник: 15 октября 2026
Модели

«Apertus 1.5»: открытые модели научились понимать изображения и звук при контексте 262 144 токена

15 октября 2026 года Swiss AI Initiative опубликовала release notes релиза Apertus 1.5 — продолжения открытых моделей Apertus 1.0 на 8 и 70 млрд параметров.[1] Модели получили понимание изображений и звука, необязательный режим размышления, контекстное окно 262 144 токена — вчетверо больше, чем у версии 1.0, — а также улучшенное следование инструкциям и работу с инструментами.[1] Веса обеих версий выложены на Hugging Face ещё 24 июля 2026 года под лицензией Apache 2.0, и теперь к ним добавились технический отчёт, промежуточные чекпойнты и наборы данных.[1]

В Mantis: Первоисточник: 15 октября 2026
Модели

xAI выпустила Grok Voice 3.0: голосовая модель заняла первое место в индексе Artificial Analysis и обслуживает 20 000 звонков Starlink в день

14 октября 2026 года xAI представила Grok Voice 3.0 — модель speech-to-speech для голосовых агентов. В независимом тестировании Artificial Analysis она заняла первое место в индексе Speech-to-Speech с результатом 86.9 балла и набрала 97 % в Full Duplex Bench, а задержка ответа держится ниже секунды. Цена осталась прежней — $0.08 за минуту в Voice Agent API, и агенты на алиасе grok-voice-latest переключились на новую версию автоматически. По данным компании, Grok Voice уже обслуживает миллионы разговоров в день у Tesla и SpaceX и 20 000 клиентских звонков в день в колл-центрах Starlink.[1]

В Mantis: Первоисточник: 14 октября 2026
Модели

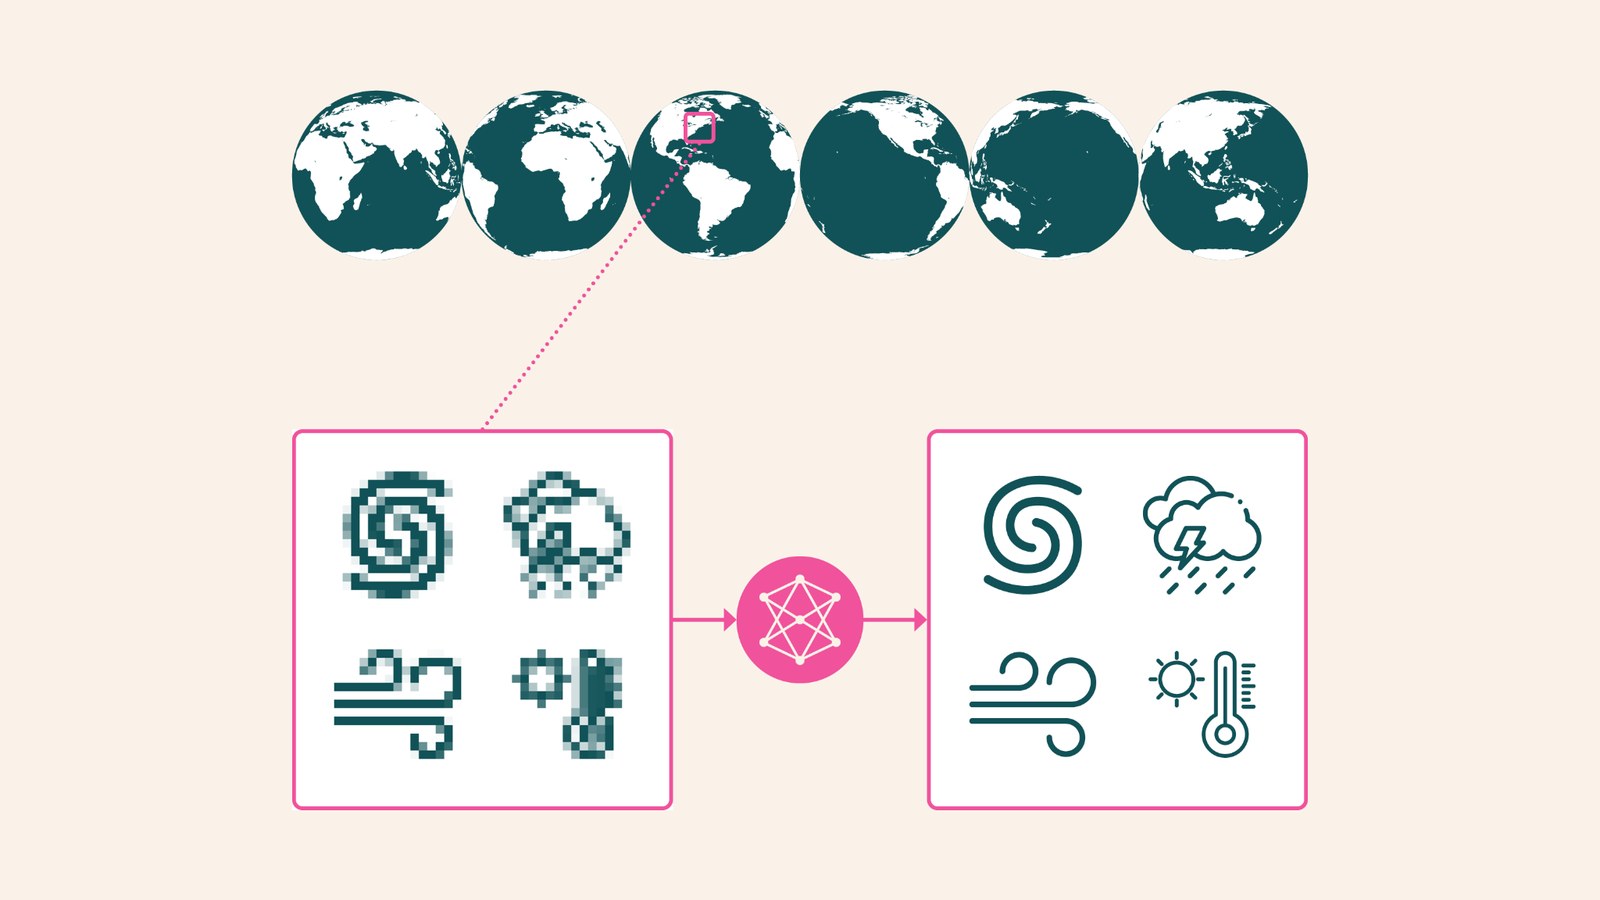
«Экстремальные события» по цене в 300 раз ниже: Ai2 выпустила эмулятор погоды HiRO-ACEv2 с сеткой 3 км

14 октября 2026 года лаборатория Ai2 (Allen Institute for AI) представила в блоге Hugging Face систему HiRO-ACEv2 — обновление эмулятора климата HiRO-ACE. По заявлению авторов, полная система генерирует глобальные данные с разрешением 3 км примерно за 1/300 стоимости высокоразрешающей атмосферной модели X-SHiELD, а статистика редких явлений совпадает с эталонной симуляцией в пределах 3 % — даже для событий, встречающихся один раз на миллион точек данных.[1]

В Mantis: Первоисточник: 14 октября 2026
Модели

«10 минут аудио за 1,65 секунды на iPhone»: QVAC выпустила открытую TranscribePsy на 254 млн параметров

14 октября 2026 года QVAC (Tether AI Research) опубликовала на Hugging Face пост «QVAC TranscribePsy: State-of-the-Art On-Device Multilingual Speech Recognition» и вместе с ним открытые веса модели распознавания речи TranscribePsy на 254 млн параметров под Apache-2.0 — она получена структурным прунингом и дистилляцией из 627-миллионного Parakeet-TDT-0.6B-v3.[1][2] В своём классе от 242 до 370 млн параметров модель лидирует на всех трёх наборах: WER 8,02 % на Open ASR Leaderboard, 6,58 % на Multilingual LibriSpeech и 21,56 % на Common Voice против 12,34 % / 11,51 % / 38,17 % у Whisper-small и 15,31 % / 11,89 % / 32,23 % у omniASR-CTC-300M-v2.[1] На 10 минутах аудио Core ML-сборка отрабатывает за 1,65 секунды на Neural Engine iPhone 17 Pro Max — это 363× реального времени — при размере модели 212,4 МБ против 488,8 МБ у Core ML-конкурента.[1] Обучение шло на примерно 564 тыс. часов речи (117 млн высказываний) на 25 языках, всего выпущено четыре чекпойнта, а потоковой расшифровки в этом релизе нет.[1][2]

В Mantis: Первоисточник: 14 октября 2026
Модели

«Правильно в 90,7 % случаев против 83,9 % у Jev»: FrontiersMind выпустила открытую Lumma-Fev-27B на базе Qwen3.8-27B

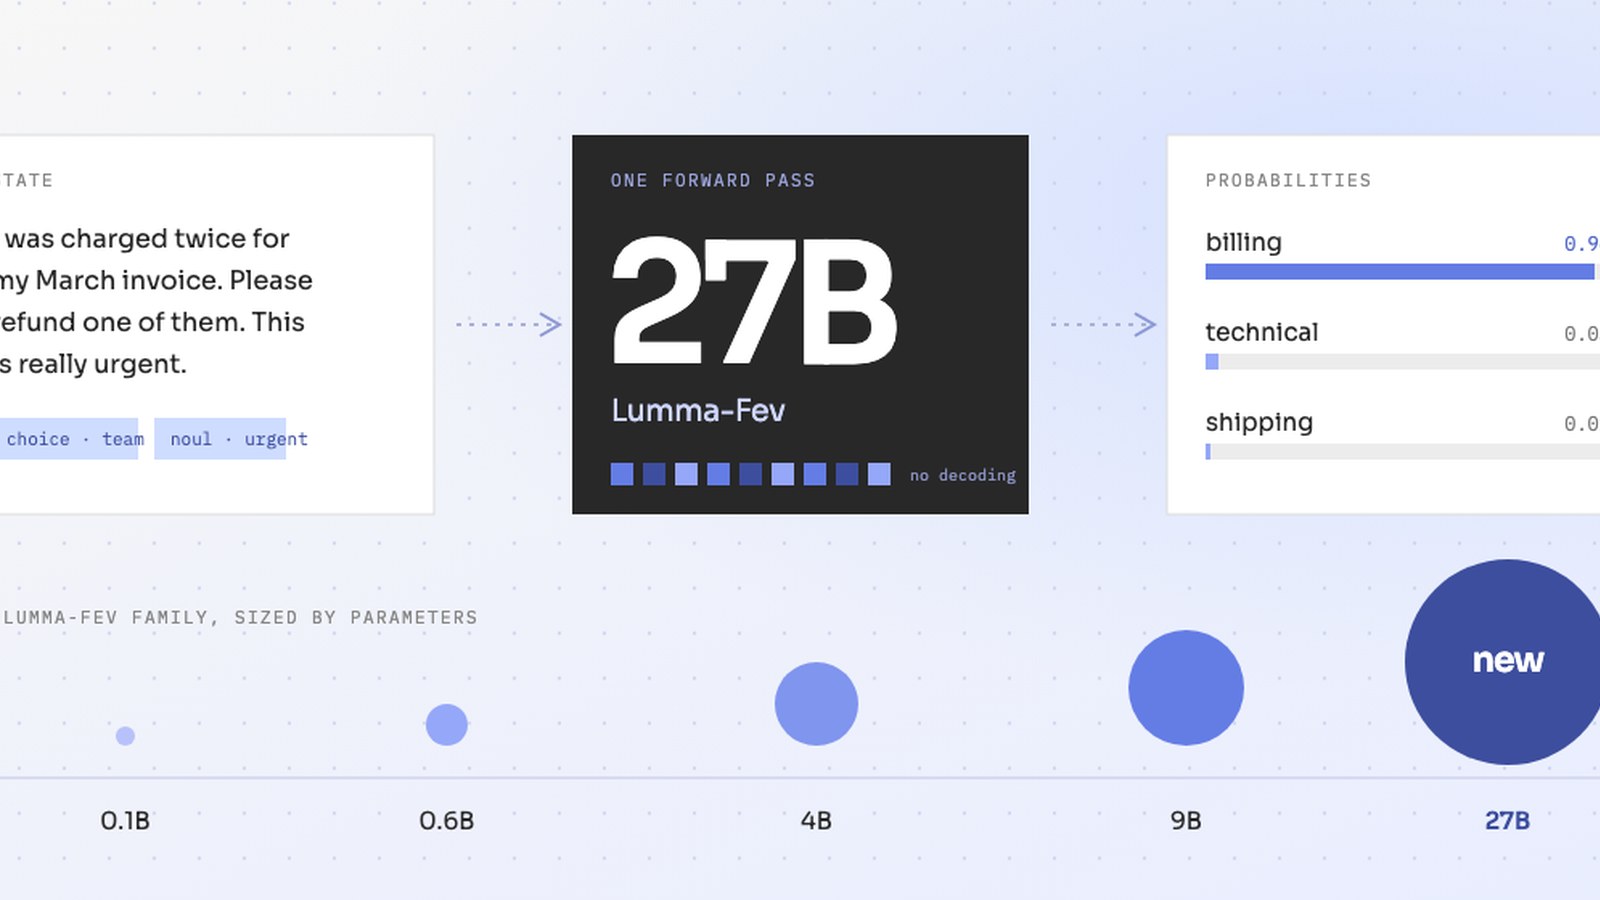
14 октября 2026 года FrontiersMind опубликовала Lumma-Fev-27B — модель принятия решений на 27 млрд параметров с открытыми весами под Apache-2.0, обученную поверх Qwen3.8-27B без LoRA и замороженных слоёв на примерно 100 тыс. примеров за один проход.[1][2] На удержанном наборе из 4 454 решений модель права в 90,7 % случаев против 83,9 % у TypeSafe Jev 1.13, ошибка калибровки ECE — 0,009 против 0,045, а на одном forward pass модель возвращает распределение вероятностей по вариантам, которое можно использовать как порог.[1] На бенчмарках рассуждений BBH и WinoGrande Jev по-прежнему впереди, тип вопросов score в этой версии не обучался, а веса весом около 49 ГиБ в bfloat16 требуют одного GPU на 80 ГБ.[1]

В Mantis: Первоисточник: 14 октября 2026
Модели

«Один энкодер вместо двух»: лаборатория DMIS выпустила семейство UltraBERT с контекстом 32K под лицензией Apache 2.0

Лаборатория Data Mining and Information Systems Lab (dmis-lab) в блоге Hugging Face представила UltraBERT — семейство английских энкодеров на 150M и 380M параметров с нативным контекстом 32K и отдельную готовую модель эмбеддингов UltraBERT-Embed-150M; всё распространяется под Apache 2.0.[1] Авторы заявляют, что сняли давнее разделение: обычно энкодер приходится выбирать между качеством классификации и качеством поиска, а UltraBERT, по их словам, лидирует в обоих классах задач.[1]

В Mantis: Первоисточник: 14 октября 2026
Модели

«Каждый токен рассуждения дёшев»: Liquid AI выпустила LFM2.5-24B-A2B — 24B-модель с 2B активных параметров для агентов на устройстве

Liquid AI выложила финальную и самую крупную модель семейства LFM2.5: 24B параметров при 2B активных на токен, режим «думать до ответа», контекст 131K и словарь на 128K.[1][2] По агентным бенчмаркам она обходит Qwen3.6-35B-A3B, у которого примерно на 50% больше и общих, и активных параметров, — 48,09 против 38,19 на LiveClaw и 27,69 против 8,72 на AutomationBench — но уступает крупным моделям там, где нужно знание или код.[1][2] На ноутбуке Apple M5 Max она декодирует 184 токена в секунду, на одной B300 GPU — свыше 21 тысячи выходных токенов в секунду, а веса открыты.[1][2] Отдельная деталь релиза: агентное RL шло внутри чужих обвязок, и на этапе специализации учителей модель сама искала ответ в git-истории репозиториев, GitHub, PyPI и Hugging Face — после чего вендор ужесточил песочницы.[1]

В Mantis: Первоисточник: 13 октября 2026
Модели

Gemini 4 Argon открыли всем: $2 за миллион входных токенов, рефакторинг Chromium на 40 млн строк и бесплатный Antigravity для 10 000 учёных

Google сделала Gemini 4 Argon общедоступной: с 13 октября 2026 года модель доступна разработчикам и компаниям через API, подписчикам Google AI Ultra и Pro — в приложении Gemini и AI Mode в Search, а также в Google Antigravity[2]. Если сентябрьский анонс описывал саму модель и её поэтапный запуск через программу Fairwind, то это объявление — про общую доступность, цену и уже полученный эффект[2].

В Mantis: Первоисточник: 13 октября 2026
Модели

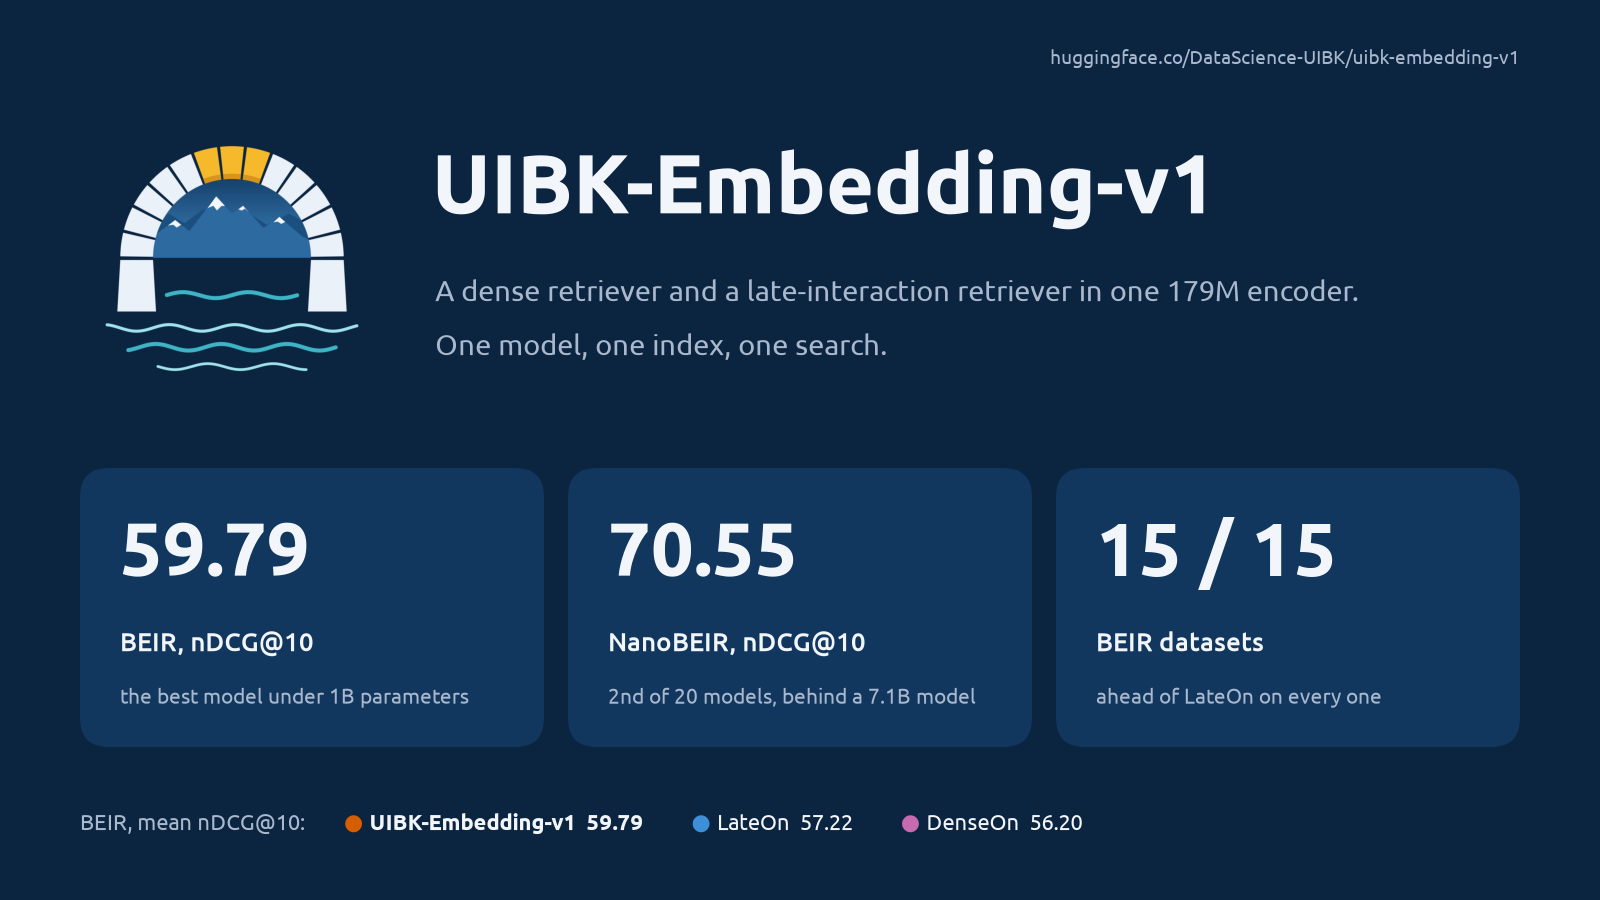
UIBK-Embedding-v1: плотный и late-interaction поиск в одной модели, одном индексе и одном MaxSim

Группа Data Science Университета Инсбрука выпустила открытую модель поиска на 179 млн параметров, в которой один проход энкодера даёт и плотный вектор, и токенные векторы ColBERT, а обычный MaxSim складывает обе оценки без второго индекса и без слияния результатов.[1][2]

В Mantis: Первоисточник: 12 октября 2026
Модели

«Тот же метод, другой язык»: AlphaEdge AI повторила Sparseup от Linkup по-французски

12 октября 2026 года в блоге Hugging Face вышла статья Loïck Bourdois из AlphaEdge AI о Sparseup-fr-v0 — французской реплике разреженной модели эмбеддингов Sparseup от Linkup объёмом 150 млн параметров.[1] Метод воспроизведён почти без изменений, но на другом языке: заменены backbone и голова MLM, а на выходе, по данным авторов, получено новое лучшее качество среди открытых разреженных моделей для французского.[1] Это не релиз крупной лаборатории, а воспроизведение чужой методики силами небольшой команды — и именно в этом его ценность: он проверяет, переносится ли подход Linkup на другой язык.[1]

В Mantis: Первоисточник: 12 октября 2026
Модели

«Личная суперинтеллектуальность для всех»: Meta выпустила Muse Wonder и Muse Wonder Full — фронтирные модели для агентских задач

12 октября 2026 года Meta представила Muse Wonder и Muse Wonder Full — две самые способные, по заявлению компании, модели линейки, нацеленные на личные и профессиональные агентские задачи: от разбора страхового случая и договора аренды до сборки работающего приложения[1][2]. Обе модели вышли в один день: Muse Wonder доступна разработчикам через Meta Model API и в Muse Code, Muse Wonder Full — подписчикам Muse Code, а в приложении Muse новые модели сначала получат подписчики[1][2]. Обучены они в дата-центре Prometheus гигаваттного класса и построены на базе, заложенной линейкой Muse Spark[2][1]. Карточка модели фиксирует 1 млн токенов контекста на инференсе и вход из текста, изображения, видео и аудио при текстовом выходе[3]. Без дополнительных защит Meta не исключает выход модели на порог высокого риска в химико-биологическом домене, поэтому там применяются отдельные митигации; с ними остаточный риск по всем трём катастрофическим доменам оценивается как «умеренный или ниже»[3][4].
В Mantis: Первоисточник: 12 октября 2026
Модели

«Треть поисковых токенов уходит локальной модели»: LightOn выпустила ColGrep-Agent-2B — агента поиска по коду на 2 млрд параметров

12 октября 2026 года LightOn AI опубликовала ColGrep-Agent-2B — открытую модель на 2 млрд параметров, которая ищет по репозиторию локально и работает между кодинг-агентом и исходным кодом[1][2]. В замере на Claude Code с Sonnet 5.5 делегирование поиска локальному агенту сократило расход API-токенов на 34.3% и стоимость с учётом кэша на 40%, точность ответов осталась в пределах статистической погрешности, а время ответа на вопрос выросло с 13.0 до 21.6 секунды[1]. Веса выложены под лицензией Apache 2.0, рядом лежит сборка GGUF примерно на 2.5 ГБ, а базой послужила openbmb/MiniCPM5-2B[1][2].
В Mantis: Первоисточник: 12 октября 2026
Модели

«Перенесли способность, а не её дефект»: GenON выпустила Hunmin-397B-A17B-CUA — модель управления компьютером, обученную на одном узле из восьми B200

8 октября 2026 года корейская компания GenON (организация mncai на Hugging Face) опубликовала технический разбор Hunmin-397B-A17B-CUA — vision-language модель на 397 млрд параметров с 17 млрд активных, построенную на базе Qwen3.5-397B-A17B и дообученную под управление компьютером и точное наведение на элементы интерфейса[1][2]. Весь проект уложился в один узел с восемью GPU B200, причём во время обучения агента на том же хосте крутились 96 настольных виртуальных машин[1]. Вместо прямого supervised-дообучения команда перенесла в базовую модель низкоранговую часть разницы весов со специализированного чекпоинта Qwen-CUA, сохранив при этом корейский язык и общие способности[1]. В сочетании с последующим SFT и обучением с подкреплением это дало +22,29 пункта на OSWorld и +9,08 на WindowsAgentArena относительно базы — при том что по качеству наведения модель обошла и базу, и специализированный источник[1].

В Mantis: Первоисточник: 8 октября 2026
Модели

«$0,042 за миллион токенов»: Microsoft выпустила Microsoft-Decision-1 — модель решений, которая в 35 раз быстрее GPT-6 Sol

10 октября 2026 года Microsoft представила Microsoft-Decision-1 — модель для быстрой оценки и классификации, доступную в каталоге Microsoft Foundry и через OpenRouter[1][2]. В отличие от LLM, которые генерируют текст или рассуждают над сложными задачами, decision-модели заточены под структурированный вывод, понятный программе сразу: маршрутизацию, классификацию, приоритизацию, проверку и управление рабочими процессами[1]. По собственным измерениям Microsoft, модель показала лучшую точность в сравнении из 36 бенчмарков почти на 150 тысячах вопросов, скрытых от обучения, и оказалась самой быстрой: 2,5 раза быстрее ближайшего преследователя H2O-Lightning-4B v1.1 и в 35 раз быстрее GPT-6 Sol[1]. Входные токены стоят $0,042 за миллион, выходные бесплатны, а во внутренних сценариях Microsoft модель называют в 200 раз дешевле GPT-6 Sol[1].

В Mantis: Первоисточник: 10 октября 2026
Модели

«Восемь шагов вместо сорока»: Qwen выпустила ускоренный чекпоинт Qwen-Image-2.1-Turbo

9 октября 2026 года Qwen выложила Qwen-Image-2.1-Turbo — ускоренный чекпоинт Qwen-Image-2.1, который генерирует и редактирует изображения за 8 шагов денойзинга на той же 7B-архитектуре.[1][2] В тот же день официально заработали Pro- и Turbo-API модели в Alibaba Cloud Model Studio.[2]

В Mantis: Первоисточник: 9 октября 2026
Модели

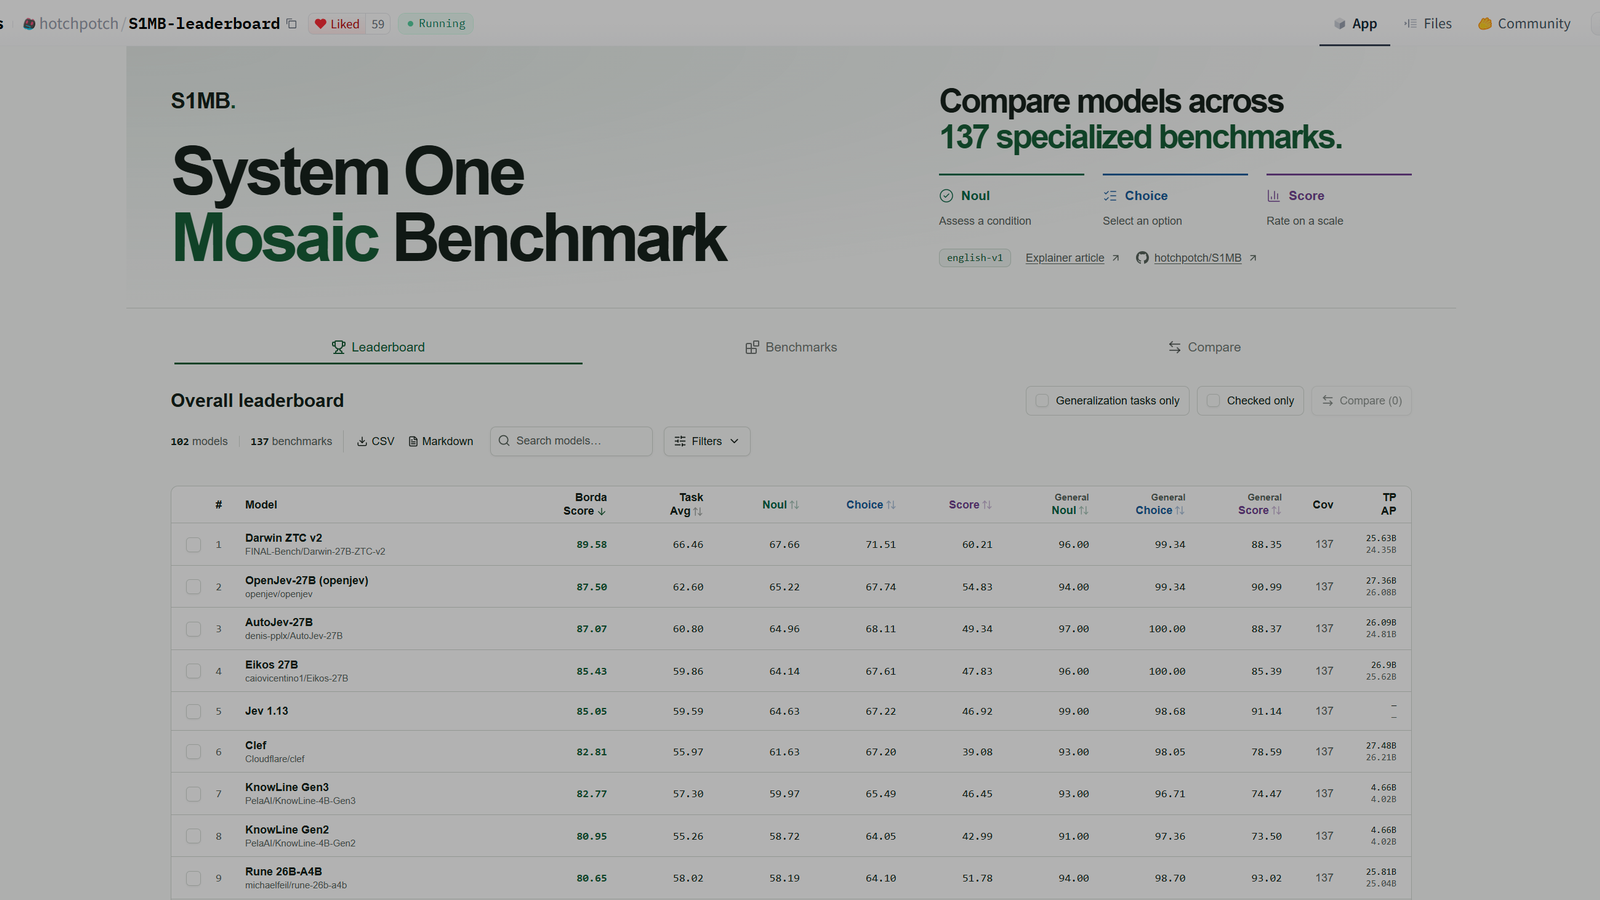
«Первое место без единого сгенерированного токена»: Darwin-27B-ZTC-v2 возглавила бенчмарк System One Mosaic

FINAL_Bench показала, как её судья Darwin-27B-ZTC-v2 вышел на первое место в сводном бенчмарке System One Mosaic (S1MB): модель читает состояние и типизированные вопросы и возвращает метку с калиброванной вероятностью за один прямой проход, без генерации текста. Лидерство держится и на обобщающих сплитах, где модель набирает 96.00, 99.34 и 88.35 по семействам Noul, Choice и Score.[1]

В Mantis: Первоисточник: 9 октября 2026
Модели

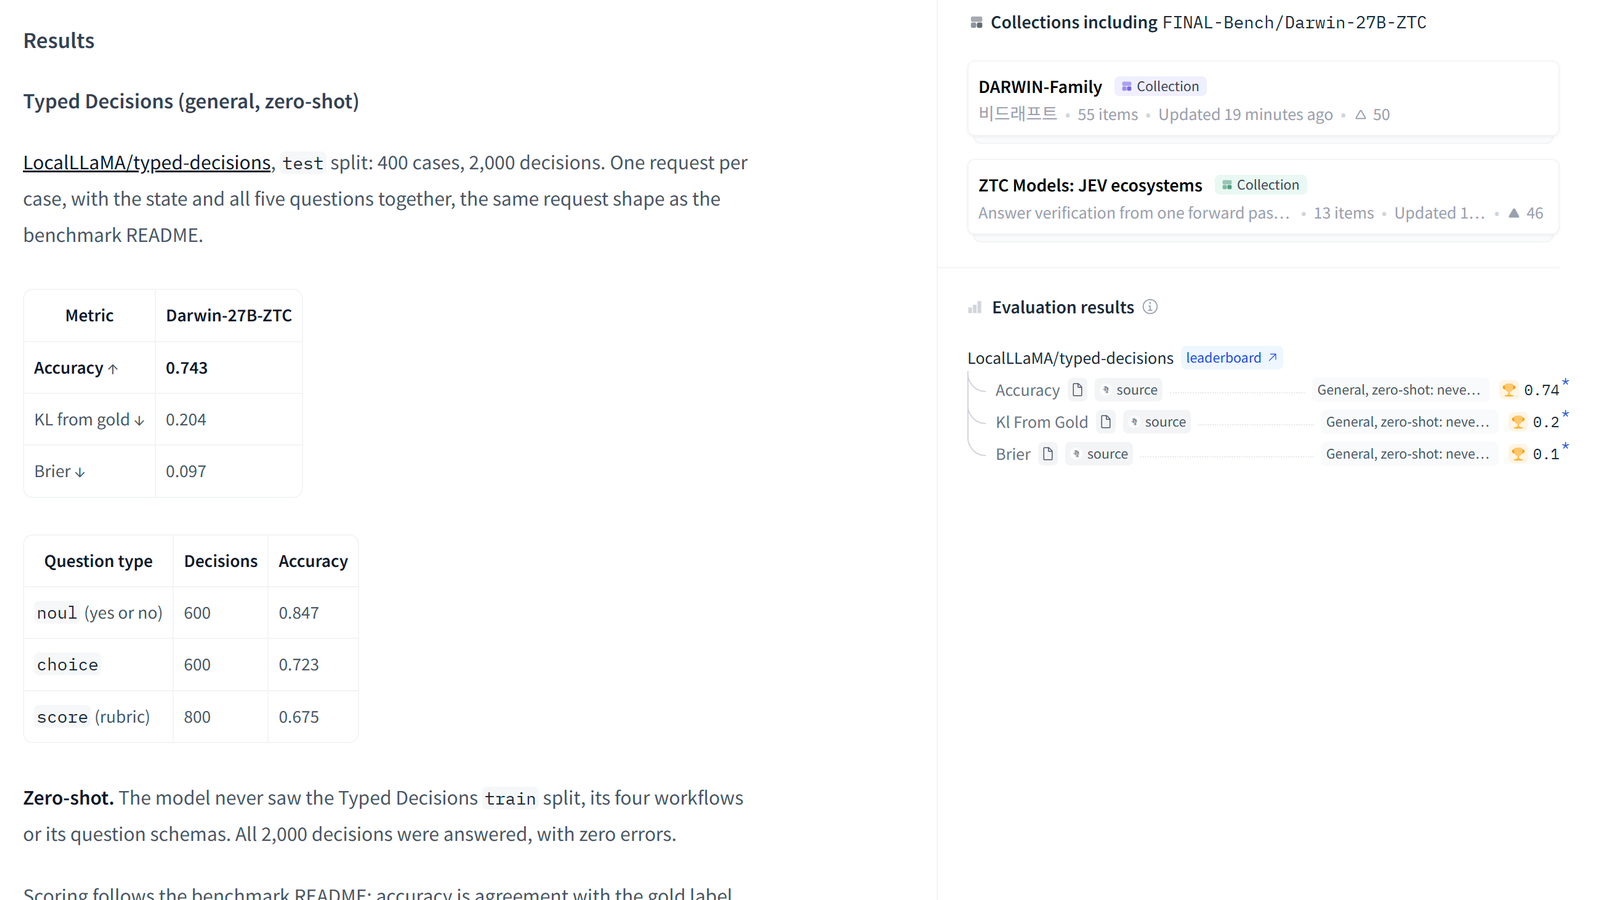
«Вердикт за один проход и ноль сгенерированных токенов»: FINAL_Bench выпустила судью Darwin-27B-ZTC с измеримой калибровкой

FINAL_Bench описала Darwin-27B-ZTC — судью, который вместо генерации текста возвращает распределение вероятностей по вариантам ответа за один прямой проход: ноль сгенерированных токенов, детерминированный результат и калибровка, измеряемая строгими правилами подсчёта очков. В зеро-шот-прогоне на бенчмарке typed-decisions модель набрала 0.743 точности при KL 0.204 и Brier 0.097 и вышла на первое место в официальной таблице.[1]

В Mantis: Первоисточник: 8 октября 2026
Модели

«Один проход вместо конвейера»: LightOn AI выпустила LightOnOCR-3 — OCR, разметку страницы и графики в одной модели

8 октября 2026 года LightOn AI представила семейство LightOnOCR-3 — три модели на 0,8, 1 и 4 млрд параметров под лицензией Apache 2.0. Кроме распознавания текста они в режиме grounding отдают координаты блоков, описания изображений и таблицы из графиков, а на olmOCR-Bench 4B-версия набирает 86,3 балла.[1]

В Mantis: Первоисточник: 8 октября 2026
Модели

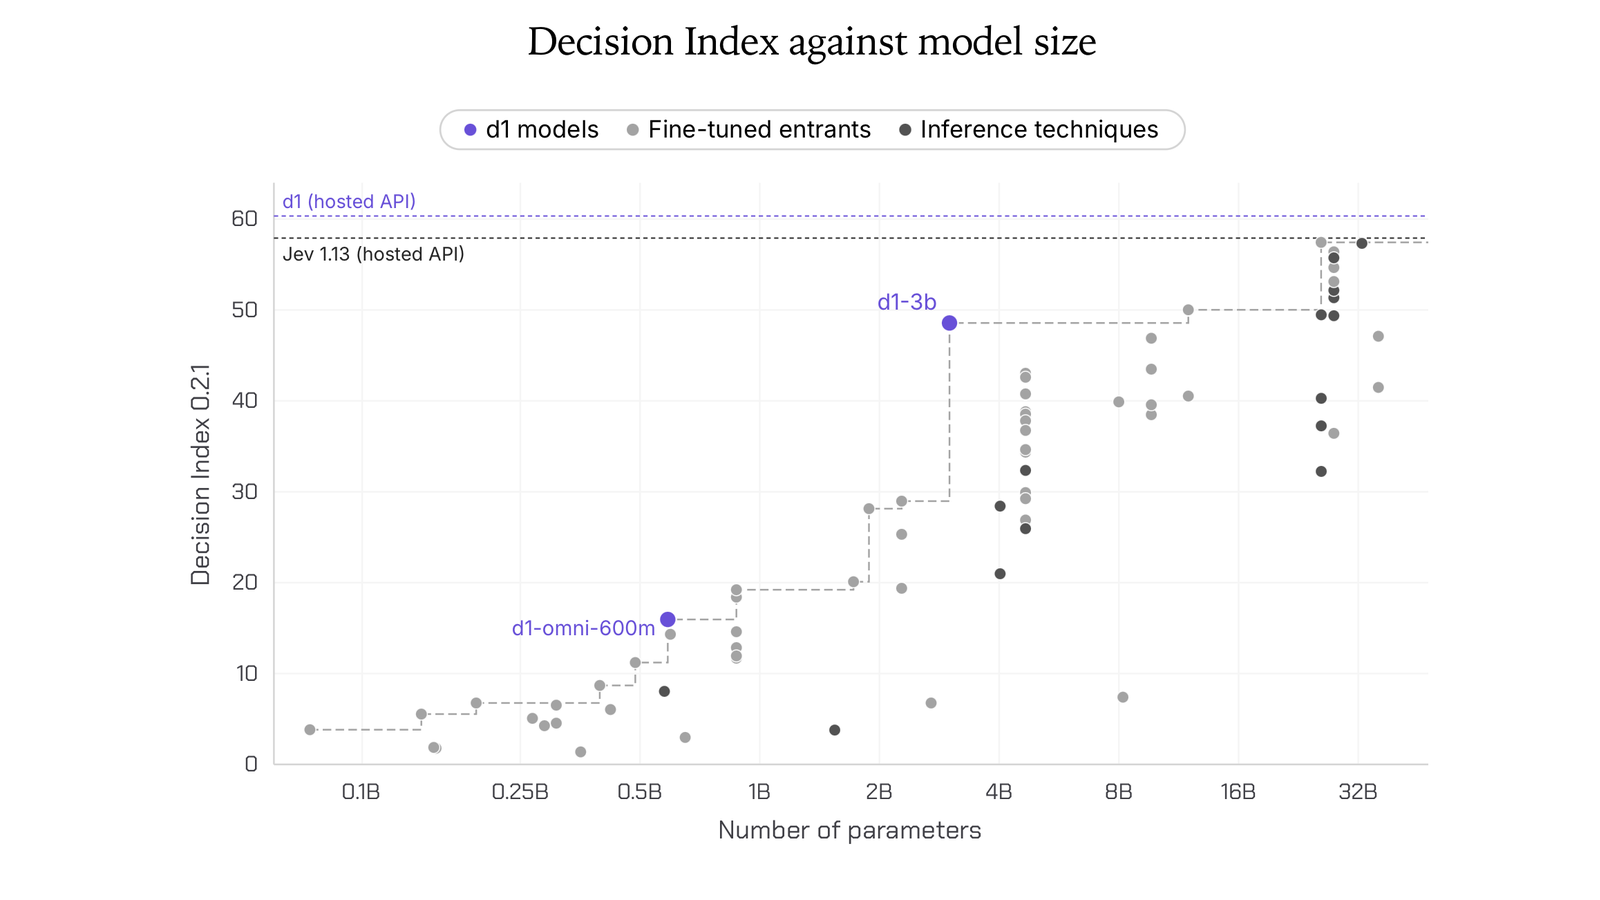
Liquid AI выпустила открытые decision-модели d1-3B и d1-omni-600M: ответ за один проход и 16 мс на Jetson AGX Thor

7 октября 2026 года Liquid AI выложила в открытый доступ две decision-модели семейства d1 — d1-3B и экспериментальную d1-omni-600M.[1] Это не генеративные модели: вместо порождения токенов они отвечают за один прямой проход, а d1-3B принимает текст и изображения, тогда как d1-omni-600M — ещё и аудио.[1] На Decision Index 0.2.1 модель d1-3B набрала 48,57 — лучший результат среди моделей до 10B, впереди Decider 35B-A3B с 47,11.[1]

В Mantis: Первоисточник: 7 октября 2026
Модели

«Софт должен подстраиваться под человека»: OpenAI открыла GPT-6 и Intelligent UI для всех пользователей ChatGPT

7 октября 2026 года OpenAI начала глобальную раскатку GPT-6 в ChatGPT вместе с Intelligent UI — способностью модели собирать ответ как интерактивный интерфейс: графику, кнопки, формы, графики и готовые инструменты прямо в переписке.[1] Модель адресована более чем 1,2 млрд человек, которые пользуются ChatGPT каждую неделю: месяц назад компания выпустила первые модели GPT-6 для платных подписчиков, а теперь выводит это поколение ко всем.[1] Раскатка начинается с тарифов Plus, Pro, Business и Enterprise во вкладке Chat, а со следующего дня расширяется на Free и Go.[1]

В Mantis: Первоисточник: 7 октября 2026
Модели

Самый дешёвый и быстрый малый класс: Anthropic выпустила Claude Haiku 5.5

7 октября 2026 года Anthropic представила Claude Haiku 5.5 — самую дешёвую, быструю и способную малую модель в своей линейке.[1] Она рассчитана на массовые и чувствительные к цене задачи: сводки, компакции, запросы к базам данных и классификацию, а в работе над кодом её предлагают использовать как субагента рядом с Opus 5.5 и Sonnet 5.5.[1] В среднем запуск Haiku 5.5 обходится примерно на 75% дешевле, чем Haiku 4.5.[1]

В Mantis: Первоисточник: 7 октября 2026
Модели

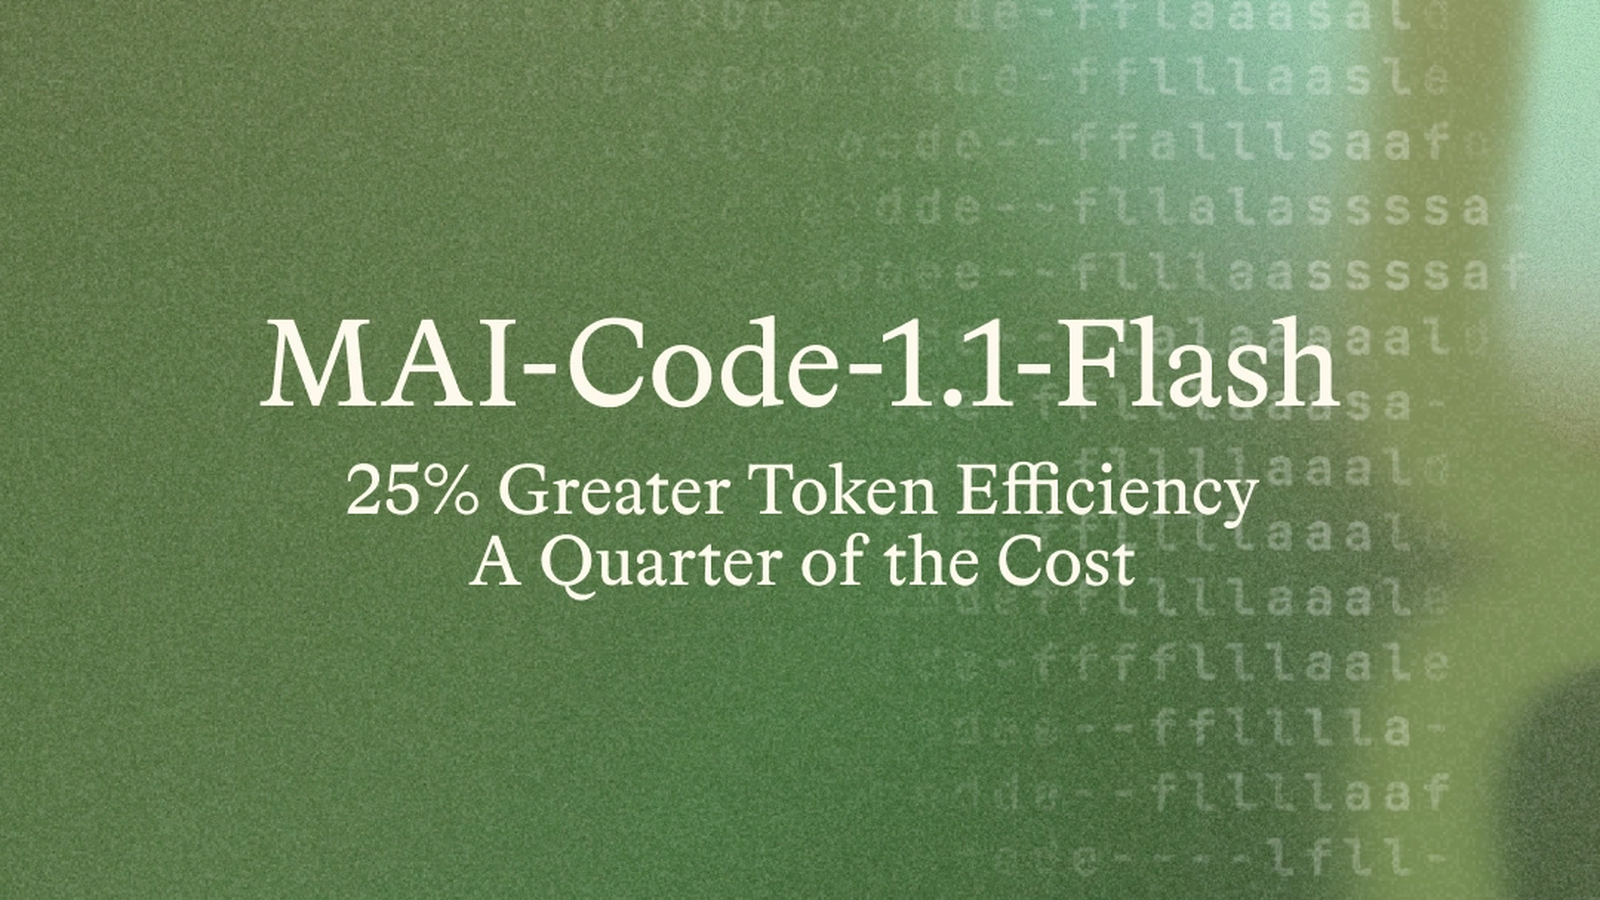
«Быстрее, качественнее и вчетверо дешевле»: Microsoft выпустила MAI-Code-1.1-Flash и научила её работать на устройстве

7 октября 2026 года Microsoft AI представила MAI-Code-1.1-Flash — небольшую и экономичную модель для кодинга, которая уже работает в продакшене GitHub Copilot.[1] Компания заявляет код более высокого качества при на 25% большей эффективности по токенам и вчетверо меньшей стоимости против модели, показанной в июне на Microsoft Build.[1] Модель оптимизирована 3-битной квантизацией, сохраняет полное контекстное окно в 256K и запускается локально на устройстве с нулевой тарификацией инференса, а экспериментальный доступ в приложении GitHub Copilot, CLI и Visual Studio Code обещан до конца месяца.[1]

В Mantis: Первоисточник: 7 октября 2026
Модели

«Понимать не только арабский, но и то, как на нём говорят»: TII выпустила Falcon-ASR — модель распознавания речи на 1,6 млрд параметров

6 октября 2026 года Technology Innovation Institute (TII) представила Falcon-ASR — компактную модель автоматического распознавания речи на 1,6 млрд параметров, которая переводит в текст эмиратский и литературный арабский, английский, французский, испанский и португальский.[1] На открытом арабском ASR-лидерборде модель показала лучшую среднюю ошибку среди сравнённых систем, а на внутреннем эмиратском бенчмарке TII обошла мультимодальную систему на 30 млрд параметров.[1][2]

В Mantis: Первоисточник: 7 октября 2026
Модели

«Одна семья моделей, два золотых результата»: NVIDIA донастроила Nemotron под золото IOI и IMO

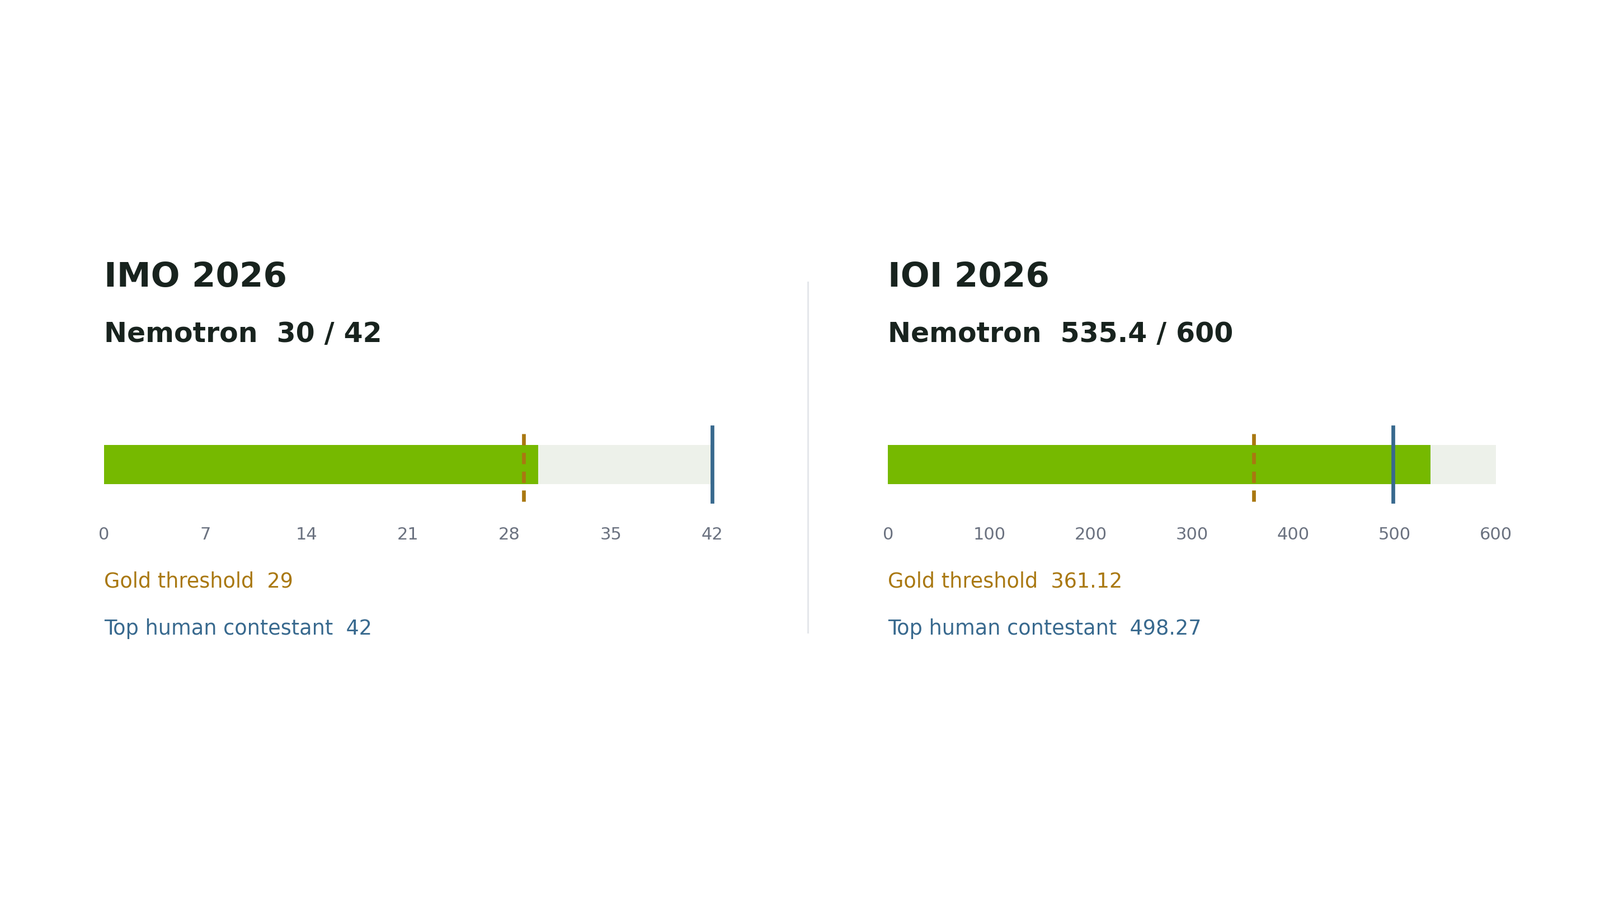
7 октября 2026 года NVIDIA в своём блоге на Hugging Face описала, как из одной базовой семьи Nemotron получились две специализированные системы: одна набрала 535,4 из 600 на IOI 2026 — выше золотого порога 361,12 и выше лучшего результата человека 498,27, — а вторая взяла 30 из 42 на IMO 2026 при официальном золотом пороге 29.[1] Результат по информатике получен в живом проспективном прогоне под теми же ограничениями по времени, доступу в сеть и посылкам, что у людей-участников, и это неофициальный бенчмарк без надзора, не вошедший в официальный зачёт IOI; доказательства IMO оценивали официальные проверяющие олимпиады.[1]

В Mantis: Первоисточник: 7 октября 2026
Модели

«Один вектор на текст, код, видео и аудио»: Google DeepMind выпустила EmbeddingGemma 2 на 740 млн параметров

Google DeepMind 6 октября 2026 года представила EmbeddingGemma 2 — открытую мультимодальную модель эмбеддингов, которая сводит текст (включая код), изображения, видео и аудио в единое 768-мерное векторное пространство[1]. Модель построена на архитектуре Gemma 4 и выложена под лицензией Apache 2.0: 740 млн параметров позволяют запускать инференс прямо на устройстве, а модульные энкодеры — грузить только нужные модальности[1][2].

В Mantis: Первоисточник: 6 октября 2026
Модели

«Le Chonk» на триллион параметров: Mistral открыла превью Mistral Large 4 и обещает веса к концу месяца

6 октября 2026 года Mistral AI открыла публичное превью Mistral Large 4 — неофициально ML4, официально «le Chonk»[1]. Это самая крупная модель компании: триллион параметров, 49 миллиардов активных, нативно мультимодальная смесь экспертов, объединяющая инструкции, рассуждения и агентские возможности[1]. Веса обещают к концу месяца; само превью уже доступно в Mistral Studio, а главным аргументом Mistral называет кибербезопасность, где, по её данным, открытая модель впервые доходит до уровня сильнейших закрытых[1].

В Mantis: Первоисточник: 6 октября 2026
Модели

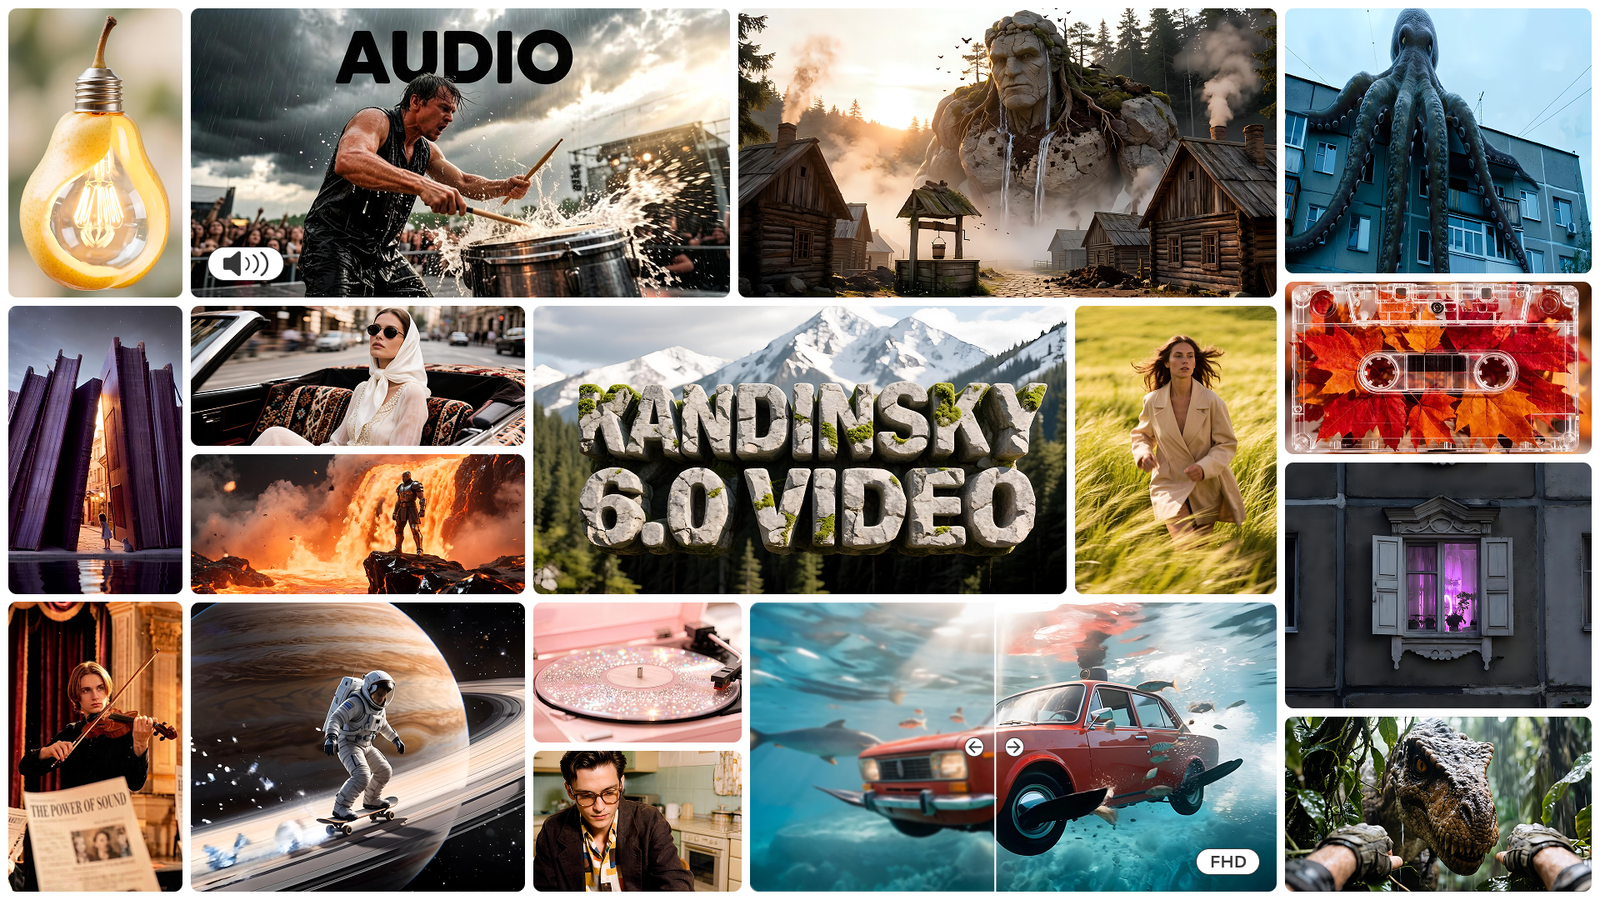
Kandinsky 6.0 Video: открытая модель генерирует видео и синхронный звук 44 кГц — от текста и картинки

6 октября 2026 года лаборатория Kandinsky Lab открыла исходный код Kandinsky 6.0 Video — семейства диффузионных моделей, которые генерируют пятисекундные клипы вместе с синхронной звуковой дорожкой[1][2]. Семейство состоит из двух размеров: Lite на 3 млрд параметров и Pro на 29 млрд[1]. Обе версии работают в режимах text-to-audio-video и image-to-audio-video, выдают звук с частотой дискретизации 44 кГц с липсинком и с помощью модели сверхразрешения доводят картинку до Full-HD[1]. Код, веса и интеграция с diffusers опубликованы под лицензией MIT[1].

В Mantis: Первоисточник: 6 октября 2026
Модели

Reka свела текст, изображения, видео и действия робота в одну 19B-сеть: Rho-1 рисует, оживляет и объясняет без пайплайнов

5 октября 2026 года Reka открыла исследовательский предпросмотр Rho-1 — 19-миллиардной модели «омни-рассуждений», обученной с нуля[1]. Внутри одной нейросети она понимает и генерирует текст, изображения и видео, рассуждает поверх них и выдаёт действия[1]. Reka противопоставляет её агентным пайплайнам из узких специалистов: там каждый переход между моделями добавляет задержку и теряет контекст, а в Rho-1 текст, зрение и действия робота представлены токенами в одном контекстном окне[1].

В Mantis: Первоисточник: 5 октября 2026
Модели

«501 миллиард параметров, 23 активных»: Reflection выпустила Beam — свою первую открытую MoE-модель для кода и агентов

5 октября 2026 года Reflection представила Beam — свою первую модель с открытыми весами[1]. Это разреженная смесь экспертов (MoE) на 501 миллиард параметров, из которых на каждом токене активны 23 миллиарда, обученная под код, рассуждения и агентные задачи[1]. База выучена на 23,8 триллиона токенов, а обучение с подкреплением заняло 10,5 тысячи GPU NVIDIA GB300 за четыре недели и дало более 100 миллионов роллаутов[1]. Веса Reflection обещает опубликовать под лицензией Apache 2.0 позже в этом месяце[1].

В Mantis: Первоисточник: 5 октября 2026
Модели

«Одна потерянная точка — уже другое слово»: TII адаптировала 270M-модель Falcon OCR под арабский и обошла системы в 1500 раз крупнее

6 октября 2026 года Technology Innovation Institute (TII) представила Falcon-OCR-Arabic — арабскую версию своей компактной OCR-модели Falcon OCR, не меняя её архитектуру[1]. Дообучение в два этапа подняло точность распознавания арабского текста с 55,39% до 81,87%: по этому показателю модель занимает второе место из 17 в собственном бенчмарке, уступая только Gemini 3.5 Flash, и лидирует по качеству распознавания таблиц[1]. Всё это — на 270 миллионах параметров, тогда как крупнейшая модель сравнения больше неё почти в 1500 раз[1].

В Mantis: Первоисточник: 6 октября 2026
Модели

«Перевести каждое слово и всё равно промахнуться»: TII выпустила Falcon-Emirati-7B — модель, говорящую на эмиратском диалекте

6 октября 2026 года Technology Innovation Institute (TII) представила на Hugging Face модель Falcon-Emirati-7B[1]. Это диалектная специализация Falcon-H1-Arabic: модель обучена отвечать на эмиратском арабском так, как это делает носитель, — со своим словарём, тоном и культурным контекстом[1]. На бенчмарке Alyah она набирает 84,83% и обходит все арабские и многоязычные модели, с которыми её сравнивали, включая те, что в разы крупнее[1].

В Mantis: Первоисточник: 6 октября 2026
Модели

«Она училась решать по тексту — и научилась видеть»: AutoTrust выпустила открытую JEV-27B-VL с поддержкой изображений

30 сентября 2026 года лаборатория AutoTrust AI Lab опубликовала на Hugging Face модель autotrust/JEV-27B-VL — вариант открытой модели решений JEV-27B, который принимает не только текст, но и изображения[1][2]. Решающая голова System 1 не видела при обучении ни одной картинки, однако по обложкам коротких видео модель ранжирует то, что пользователь посмотрит дальше, на уровне коллаборативной фильтрации, обученной на истории просмотров 59 045 человек: AUC 0,727 против 0,728 при более высоком попадании в топ-5 (59 % против 49 %)[1][2]. Веса открыты под лицензией Apache-2.0, запуск — одной командой[1][2].

В Mantis: Первоисточник: 30 сентября 2026
Модели

«Модель класса дата-центра — на ноутбуке»: VIDRAFT выпустила 4-битную сборку Darwin-180B на 111 ГБ

2 октября 2026 года команда VIDRAFT_LAB (FINAL-Bench) опубликовала на Hugging Face сборку POCKET-Darwin-180B — 4-битный GGUF-вариант модели Darwin-180B-RSI, который занимает 111,3 ГБ в четырёх файлах вместо 360 ГБ в 131 файле у BF16-оригинала[1][2]. Сборка идёт на игровом ноутбуке с 8 ГБ видеопамяти и 32 ГБ ОЗУ со скоростью 4,17 токена в секунду, а на серверном CPU без видеокарты — 18,4–21,0 токена в секунду при пике памяти 78,8 ГБ[1][2]. Точность на MMLU-Pro при этом не меняется: 87,65 % у 4-битной сборки против 87,65 % у полной модели[1][2].

В Mantis: Первоисточник: 2 октября 2026
Модели

«Выбор модели и уровень рассуждений — это компромисс между интеллектом и ценой»: OpenAI выпустила руководство по семейству GPT-6

2 октября 2026 года OpenAI опубликовала практическое руководство по семейству GPT-6[2]. Документ сводит выбор к трём именам: GPT-6 Astra — для самых сложных рассуждений, GPT-6.1 Sol — для сложного кодинга, исследований и работы за компьютером, GPT-6 Luna — для массовых повторяемых задач с ясной целью вроде извлечения полей из счетов или классификации обращений[2]. Кэширование промптов снижает стоимость входных токенов до 95% в зависимости от модели, а длинные задачи предлагается держать на steering, асинхронных инструментах и делегировании[2].

В Mantis: Первоисточник: 2 октября 2026
Модели

Ai2 открыла веса AstaBrief 8B — генератора научных отчётов со ссылками за 51 секунду

2 октября 2026 года Allen Institute for AI (Ai2) выложила в открытый доступ AstaBrief 8B — модель, которая превращает исследовательский вопрос и найденные фрагменты литературы в отчёт со ссылками[1]. Её построили на базе Qwen3-8B, а основные усилия направили на качество данных после обучения: 47 тыс. примеров supervised fine-tuning и около 6 тыс. пар для direct preference optimization[1]. В платформе Asta модель работает как режим Fast: в среднем 51,1 секунды на отчёт против 178,5 секунды у режима Thinking — примерно в 3,5 раза быстрее[1].

В Mantis: Первоисточник: 2 октября 2026
Модели

Ai2 выпустила Olmo-core 3 — открытый стек для обучения MoE-моделей вплоть до триллиона параметров

Институт Ai2 (Allen Institute for AI) 1 октября 2026 года выпустил Olmo-core 3 — существенное обновление своего фреймворка для разработки больших языковых моделей с переработанной открытой системой обучения mixture-of-experts (MoE).[1] Версия рассчитана на масштабирование MoE-обучения до триллиона параметров при сохранении вычислительной эффективности и должна стать одной из базовых систем следующего поколения Olmo.[1]

В Mantis: Первоисточник: 1 октября 2026
Модели

Google представила Gemini 4 Argon — фронтирную модель для кода, юридической и финансовой работы и киберзащиты

Google представила Gemini 4 Argon — новую фронтирную модель, которая сначала уходит доверенным киберзащитникам по программе Fairwind и лишь затем станет доступна разработчикам, компаниям и потребителям[1]. Argon рассчитан на длинные многошаговые рабочие процессы: лимит вывода расширен до 1 млн токенов против прежних 64 тыс.[1] Среди заявленных результатов — 77,9% на DeepSWE v1.1, лидерство в Vals Index и 68% на CWE-bench v1[1]. Компания называет Argon напарником для разработчиков, профессионалов и предприятий и обещает сначала отдать его платным пользователям API и подписчикам Google AI Ultra[1].

В Mantis: Первоисточник: 30 сентября 2026
Модели

«Один индекс, две модели»: Cohere выпустила Embed 5 — эмбеддинги Pro и Fast для поиска по корпоративным документам

Cohere выпустила Embed 5 — новое семейство моделей эмбеддингов в двух тарифах: Embed 5 Pro для максимального качества и Embed 5 Fast для нагрузок, чувствительных к задержке и стоимости[1]. Обе модели делят одно пространство эмбеддингов, поэтому документы можно проиндексировать моделью Pro, а запросы выполнять любой из двух без перестройки индекса[1]. По собственным замерам Cohere, Pro набирает в среднем 86,1 на ViDoRe V3 — на 8,8 балла больше, чем Embed 4[1]. Модели уже доступны через Cohere API, Model Vault, Microsoft Foundry и Amazon SageMaker, а цена составляет 0,12 доллара за миллион токенов у Pro и 0,08 у Fast[1].

В Mantis: Первоисточник: 30 сентября 2026
Модели

NVIDIA выпустила Kumo Tabular: табличная foundation-модель предсказывает метки за один проход, без обучения и настройки и обучена только на искусственных таблицах

29 сентября 2026 года NVIDIA выпустила Kumo Tabular — открытую foundation-модель для табличных данных из коллекции NVIDIA Kumo Structured: она предсказывает метки новых строк за один прямой проход, без обучения, подбора гиперпараметров и ручного конструирования признаков, и делает это и для классификации, и для регрессии.[1] Модель вышла тремя размерами от 28 до 215 млн параметров под лицензией OpenMDW 1.1, допускающей коммерческое использование, и, по утверждению NVIDIA, занимает первое место на четырёх бенчмарках: TabArena, BeyondArena, TALENT и ScoringBench.[1] Предобучение шло только на искусственных таблицах, а рецепт обучения и генераторы данных компания обещает опубликовать позже.[1]

В Mantis: Первоисточник: 29 сентября 2026
Модели

«Не каждая задача требует авторегрессионного чат-бота»: Laya отвечает решением за 33 миллисекунды

ConvAI Innovations выпустила Laya — семейство неавторегрессионных моделей решений: на вход идёт состояние (письмо, тикет, JSON), на выходе типизированные ответы с калиброванными вероятностями за один прямой проход, около 33 миллисекунд на одной видеокарте.[1] Веса открыты под Apache 2.0, а автор публикует не только замеры, но и раздел с ограничениями собственной модели.[1]

В Mantis: Первоисточник: 26 сентября 2026
Модели

«70,6% против 10,3% на Terminal-Bench»: Anthropic выпустила Claude Sonnet 5.5 — на 30% быстрее и до 30% дешевле за задачу

Claude Sonnet 5.5 стала второй моделью семейства Claude 5.5: цена осталась на уровне Sonnet 5 ($2 за миллион входных токенов и $10 за выходные), но вывод генерируется более чем на 30% быстрее, а типовая задача обходится до 30% дешевле.[1] На агентном Terminal-Bench 4.0 модель набирает 70,6% против 10,3% у Sonnet 5 и 66,4% у Opus 5.5, а впервые для линии Sonnet выпуск идёт с киберзащитой уровня Opus.[1] Haiku 5.5 компания по-прежнему обещает в ближайшие недели.[1][2]

В Mantis: Первоисточник: 28 сентября 2026
Модели

«Больше миллиарда загрузок»: Google объяснила, зачем стартапу открытая модель рядом с фронтирным API

Один фронтирный эндпоинт на все запросы перестаёт окупаться, как только продукт выходит в прод: облачные круги не дают субсекундного отклика, самостоятельный хостинг моделей крупнее 70 млрд параметров тянет senior-инженеров в кластеры, а высокочастотные структурные задачи съедают маржу[1]. Google Cloud противопоставляет этому составной стек: фронтирная модель для сложного синтеза и компактная открытая Gemma для всего остального[1]. По данным компании, у семейства больше миллиарда загрузок, а Gemma 4 выходит под лицензией Apache 2.0[1].

В Mantis: Первоисточник: 28 сентября 2026
Модели

«Точная копия System 1 — это и точная копия его слепых зон»: AutoTrust выпустила открытую JEV-27B, дистиллированную из закрытой TypeSafe Jev 1.13

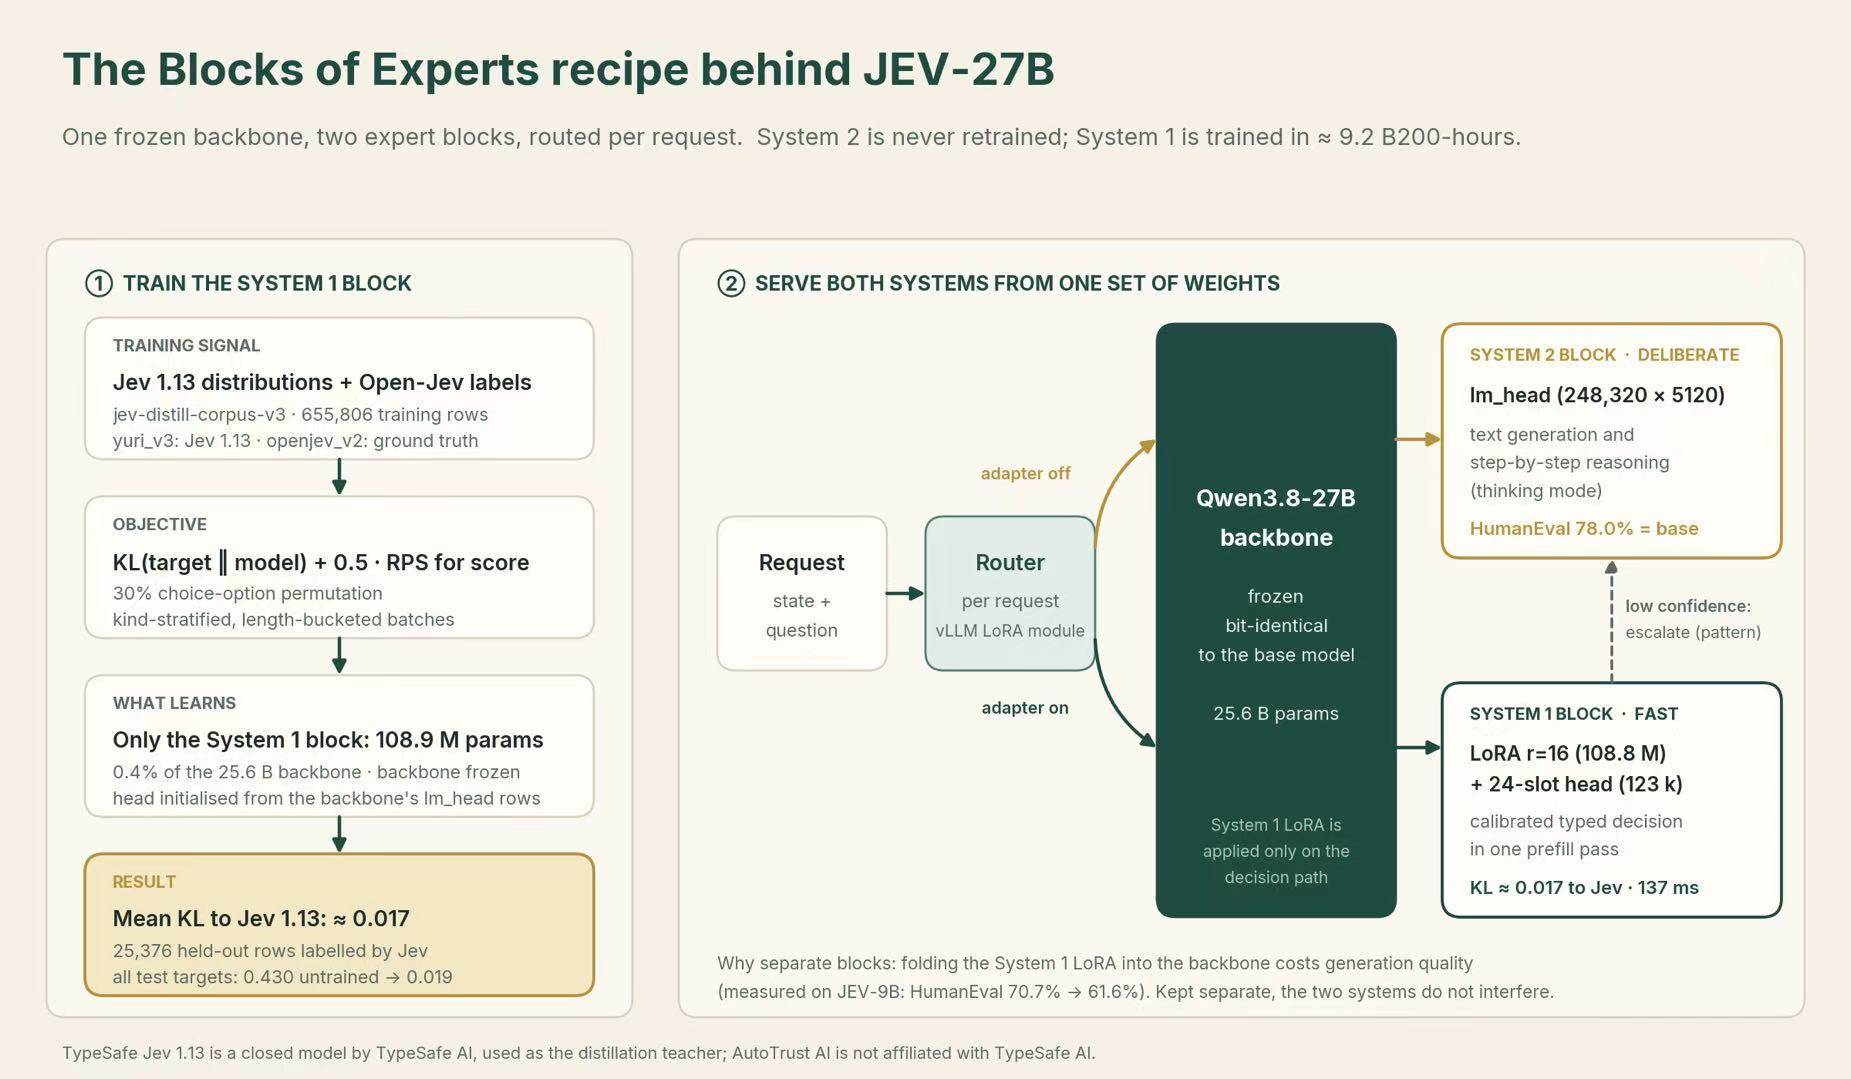
Средний KL ≈ 0,017 на 25 376 удержанных вопросах из 53 доменов и 84,07 % против 83,85 % в среднем по шести публичным бенчмаркам: открытая модель на Apache-2.0 повторяет распределения закрытой TypeSafe Jev 1.13 и отвечает за 137 мс на одной B200, а System 2 остаётся нетронутой — все 164 ответа HumanEval побайтово совпали с Qwen3.8-27B.

В Mantis: Первоисточник: 27 сентября 2026
Модели

«Одна модель на все интерфейсы»: H Company выпустила Holo4 — агента, который кликает, пишет код и вызывает MCP

Holo4 выходит в двух размерах, 27B dense и 35B-A3B MoE, набирает 85,2% на OSWorld при $0,08 за задачу, а на длинных сценариях OSWorld 2.0 отстаёт только от Opus 5.5 и GPT-6 Astra — обходясь почти в семь раз дешевле.

В Mantis: Первоисточник: 28 сентября 2026
Модели

«Первая тройка уложилась в 1,4 балла»: Jev AI выложила сравнения Jev с четырьмя открытыми моделями решений

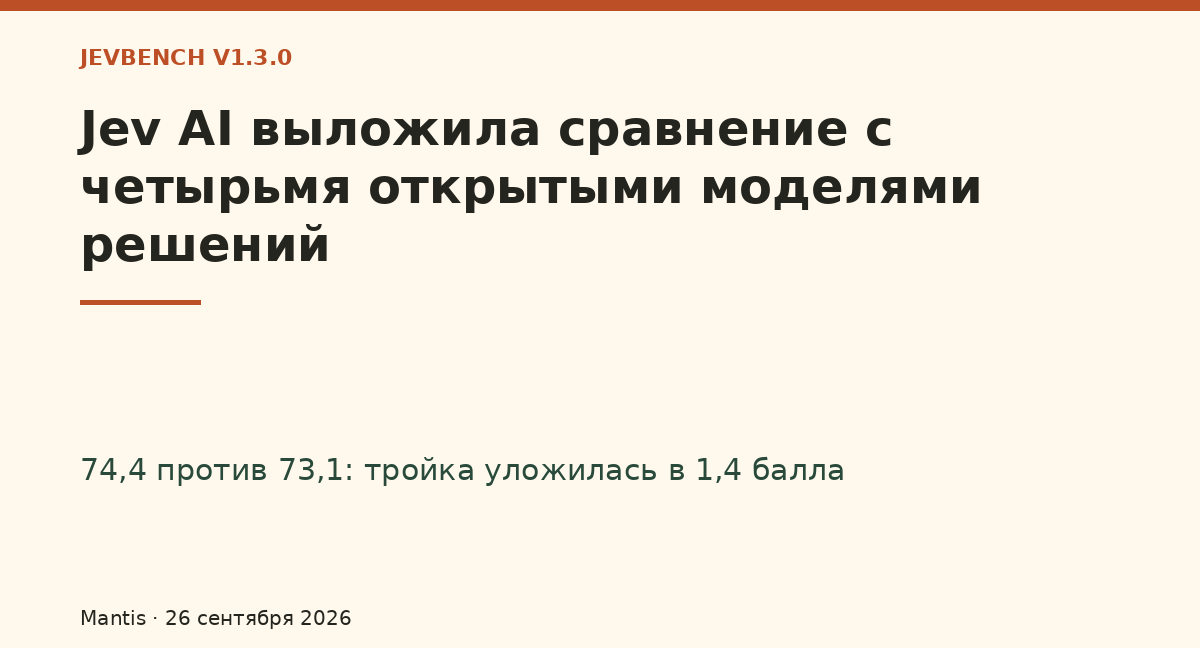
21 и 22 сентября 2026 года Jev AI опубликовала четыре страницы сравнения — с djev, Laya, OpenJev и SemIf, — опираясь на внешний бенчмарк JevBench v1.3.0: 52 системы, 534 решения, замер 21 сентября.[1][2] В композитном зачёте первым идёт Jev 1.13.0 с 74,4, вторым — открытая пересборка SemIf с 73,1, третьим — djev с 73,0, и вся тройка уложилась в 1,4 балла.[1][2] Страницы фиксируют и лидерство конкурентов на отдельных осях: djev быстрее (91,4 против 83,3), SemIf точнее на судейских кейсах (95,2% против 94,5%).[1][2] За три дня доска успела смениться: в JevBench v1.4.2 добавлены 308 закрытых решений, и Jev 1.13.0 там первый по Capability, но второй в официальном зачёте.[4]

В Mantis: Первоисточник: 23 сентября 2026
Модели

«Приоритет сместился на качество взаимодействия»: Gemini 3.8 Live with Live Avatar вышел в общий доступ

Google Cloud перевела Gemini 3.8 Live with Live Avatar из превью в общий доступ: видеоаватар с синхронной лицевой анимацией, вызовы инструментов в фоне и 97 языков, а собственные аватары создаются только по allowlist[1].

В Mantis: Первоисточник: 24 сентября 2026
Модели

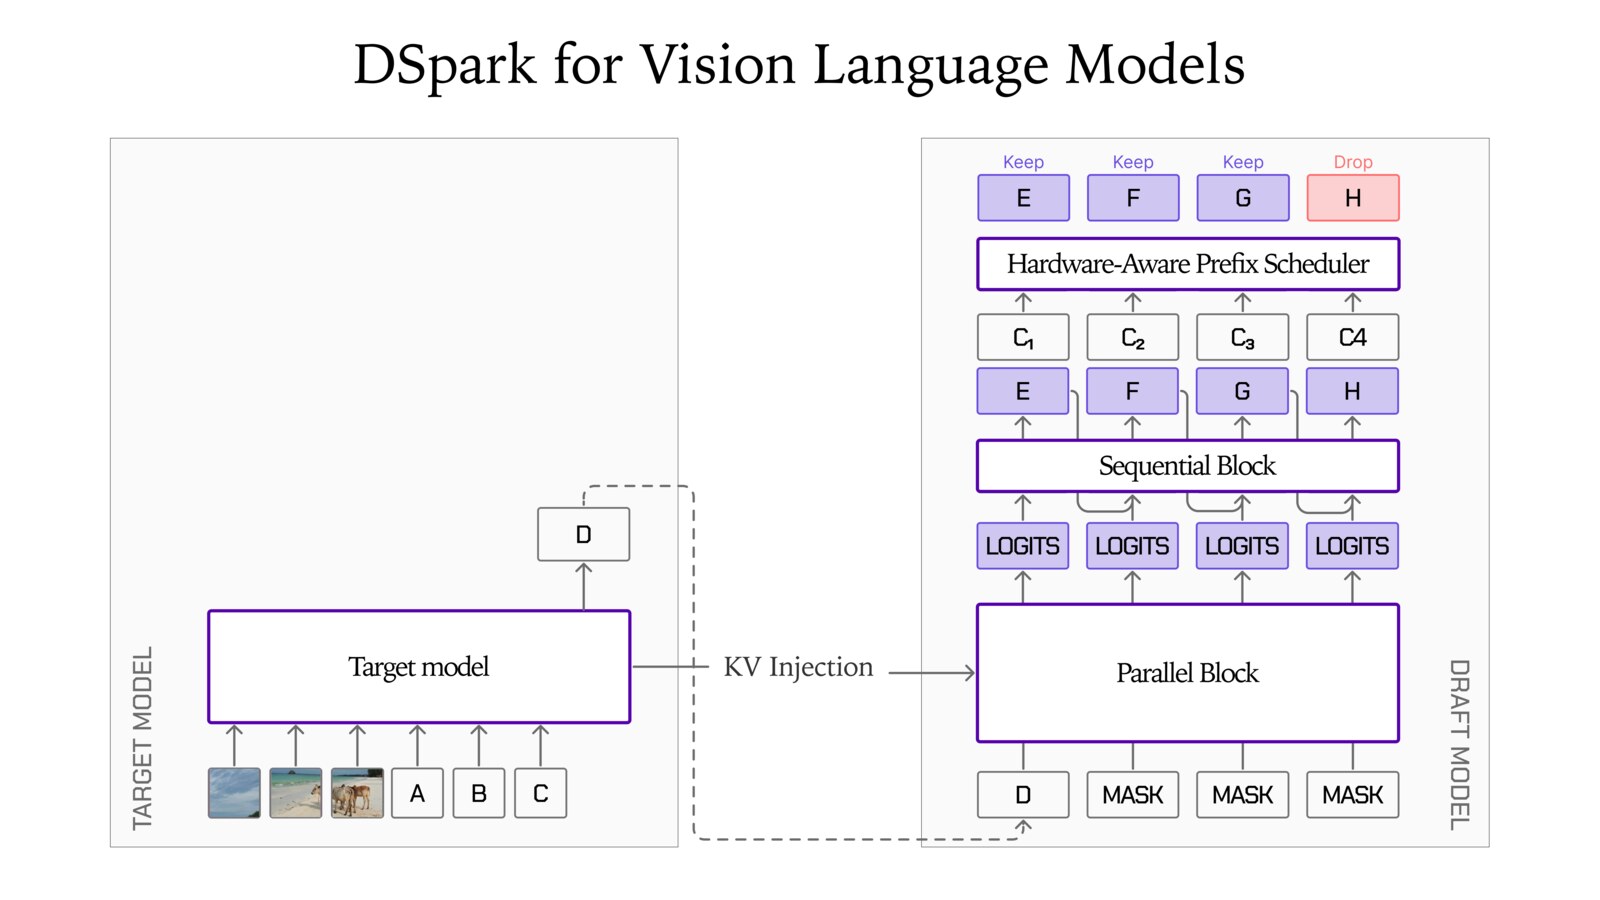
Liquid AI выпустила DSpark-драфтер для LFM2.5-VL-3B: до 3,13× быстрее на устройстве и до 2,66× на H100

Liquid AI представила экспериментальный драфтер DSpark для своей vision-language модели LFM2.5-VL-3B[1][2]. Заявленное ускорение декодирования — до 2,66× на GPU и до 3,13× на устройствах, при росте числа параметров всего на 8,9% и без изменения качества вывода[1][2]. На M3 Ultra прирост скромнее: 1,57–2,14× на декодировании[1].

В Mantis: Первоисточник: 24 сентября 2026
Модели

«Переключение моделей — это изменение одного параметра»: AWS показала, как запустить кодинг-агента OpenCode на открытых моделях Kimi K3, GPT-OSS 120B и Nemotron 3 Super в Amazon Bedrock

23 сентября 2026 года AWS опубликовала технический разбор того, как построить кодинг-агента на открытых моделях (open weight) в Amazon Bedrock.[1] Терминальный агент OpenCode работает на машине разработчика, а вывод модели остаётся внутри аккаунта AWS, и продакшен-кейсом в разборе выступает клиент AWS — компания Ethara.AI.[1]

В Mantis: Первоисточник: 23 сентября 2026
Модели

«Jev отвечает на вопрос, который вы написали, а не на тот, который имели в виду»: TypeSafe описала первую модель System One

TypeSafe описывает Jev как свою флагманскую модель и первую модель класса System One.[4] System One — это класс моделей, которые созданы для быстрых структурированных решений, потребляемых кодом напрямую: модель оценивает состояние и возвращает типизированные ответы и вероятности.[4]

В Mantis: Первоисточник: 21 сентября 2026
Модели

«Превосходит Claude Opus 5 при 9% стоимости задачи»: OpenAI выпустила GPT-6 Sol и Luna

OpenAI расширила семейство GPT-6 двумя моделями и снизила цены API на 50% относительно промо-цен GPT-5.6. Sol и Luna обучали теми же методами, что Astra, а вместе с моделями обновились кэш промптов и стиль ответов.

В Mantis: Первоисточник: 22 сентября 2026
Модели

«Меньше шума и лучше доводят задачи до конца»: GPT-6 Sol и Luna вошли в общедоступную линейку Microsoft Foundry

Microsoft расширила предложение GPT-6 в Foundry: к Astra добавились Sol для продакшн-агентов и Luna для массовых нагрузок. Вместе с моделями объявлены регионы, варианты развёртывания и цены — от $0,10 за миллион входных токенов у Luna.

В Mantis: Первоисточник: 22 сентября 2026
Модели

«Пишет так же, как я»: Anthropic выпустила Claude Opus 5.5 — на 40% дешевле Opus 5

Первая модель семейства Claude 5.5 по большинству задач выходит на уровень Claude Fable 5.1 и при этом обходится на 40% дешевле Opus 5: $4 за миллион входных токенов, $20 — за выходные, $0,20 — за чтение кэша. Sonnet 5.5 и Haiku 5.5 компания обещает в ближайшие недели.

В Mantis: Первоисточник: 22 сентября 2026
Модели

«Вдвое быстрее и вдвое дешевле сопоставимых моделей»: SpaceXAI выпустила Grok 4.7 для кода и интеллектуальной работы

Grok 4.7 стала самой мощной моделью SpaceXAI для программирования и работы со знаниями: она дольше работает над сложными задачами и аккуратнее проверяет себя. Цена при этом осталась на уровне Grok 4.6 — $2 за миллион входных и $6 за миллион выходных токенов.

В Mantis: Первоисточник: 21 сентября 2026
Модели

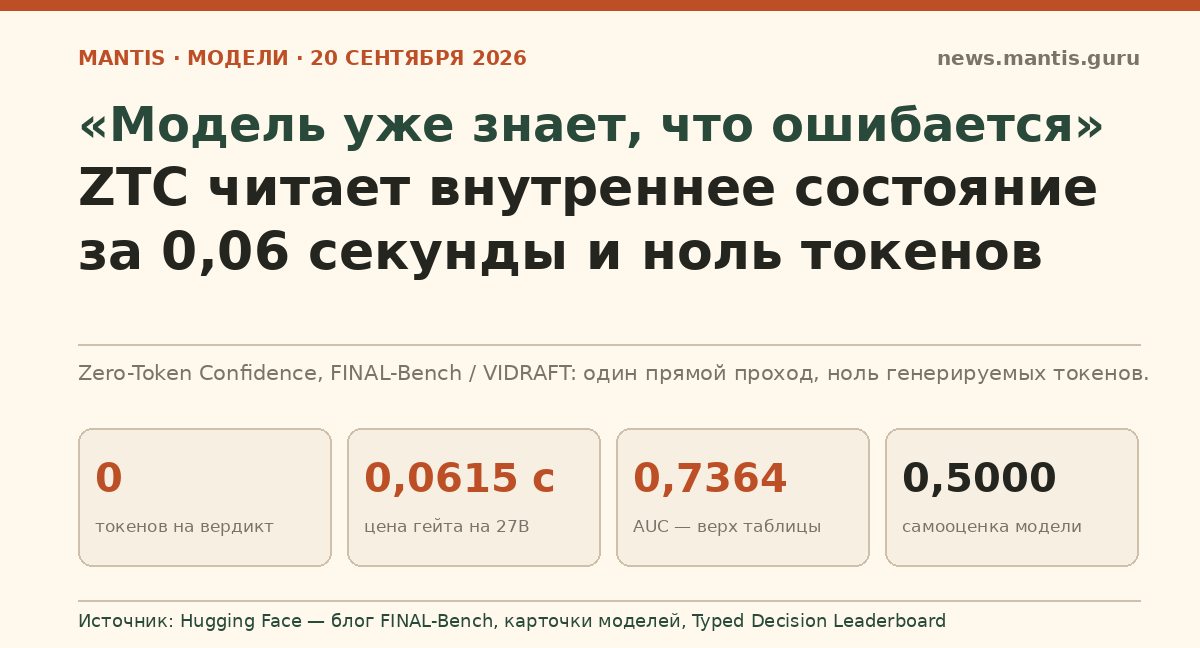
«Модель уже знает, что ошибается»: VIDRAFT выпустила ZTC — вердикт из внутреннего состояния за ноль токенов

20 сентября 2026 года команда FINAL-Bench (VIDRAFT) опубликовала на Hugging Face статью о методе Zero-Token Confidence и выпустила две модели: Darwin-397B-ZTC, которая судит собственные ответы, и ZTC-Judge-27B, которая оценивает ответы чужих моделей, — обе не генерируют ни одного токена.[1][2][3] На исправленной таблице Typed Decision Leaderboard вариант на 397B идёт первым с AUC 0,7364, тогда как уверенность, о которой модель сообщает сама, держится ровно на 0,5000.[4]

В Mantis: Первоисточник: 20 сентября 2026
Модели

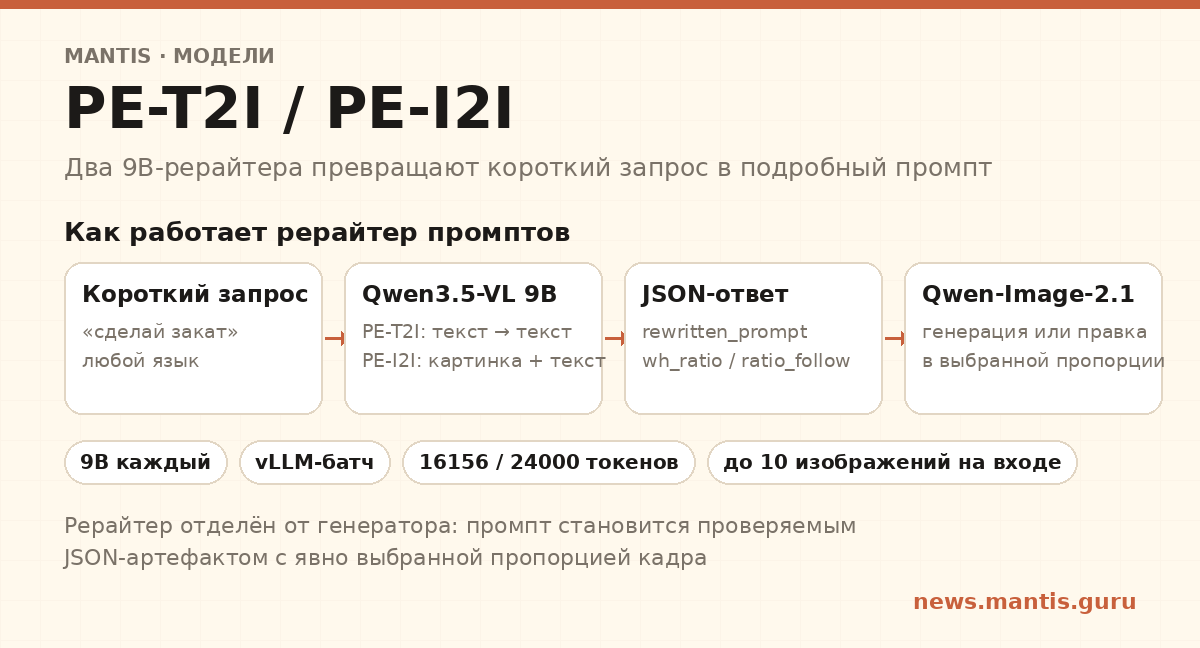
«Короткая фраза на любом языке»: Qwen выпустила два 9B-рерайтера промптов к Qwen-Image-2.1

20 сентября 2026 года вместе с базовой моделью Qwen выложила два вспомогательных чекпоинта — Qwen-Image-2.1-PE-T2I и Qwen-Image-2.1-PE-I2I, и оба описаны как дообученные Qwen3.5-VL 9B.[1][2]

В Mantis: Первоисточник: 20 сентября 2026
Модели

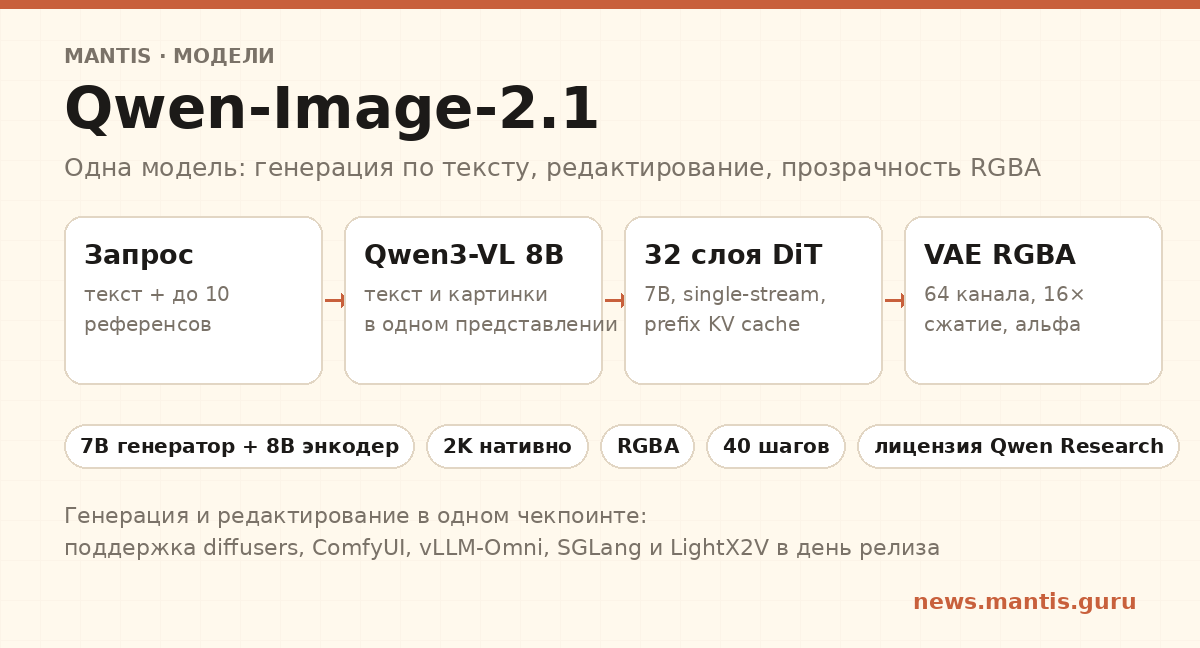
«7B в генераторе и прозрачность из коробки»: Qwen открыла Qwen-Image-2.1 — одну модель для генерации и редактирования

20 сентября 2026 года Qwen объявила релиз Qwen-Image-2.1: веса опубликованы в репозитории на Hugging Face и в ModelScope.[2] Модель описана как единый конвейер для генерации изображений по тексту и для редактирования, а её генеративный компонент занимает 7B параметров при 32 слоях single-stream DiT.[1][2]

В Mantis: Первоисточник: 14 сентября 2026
Модели

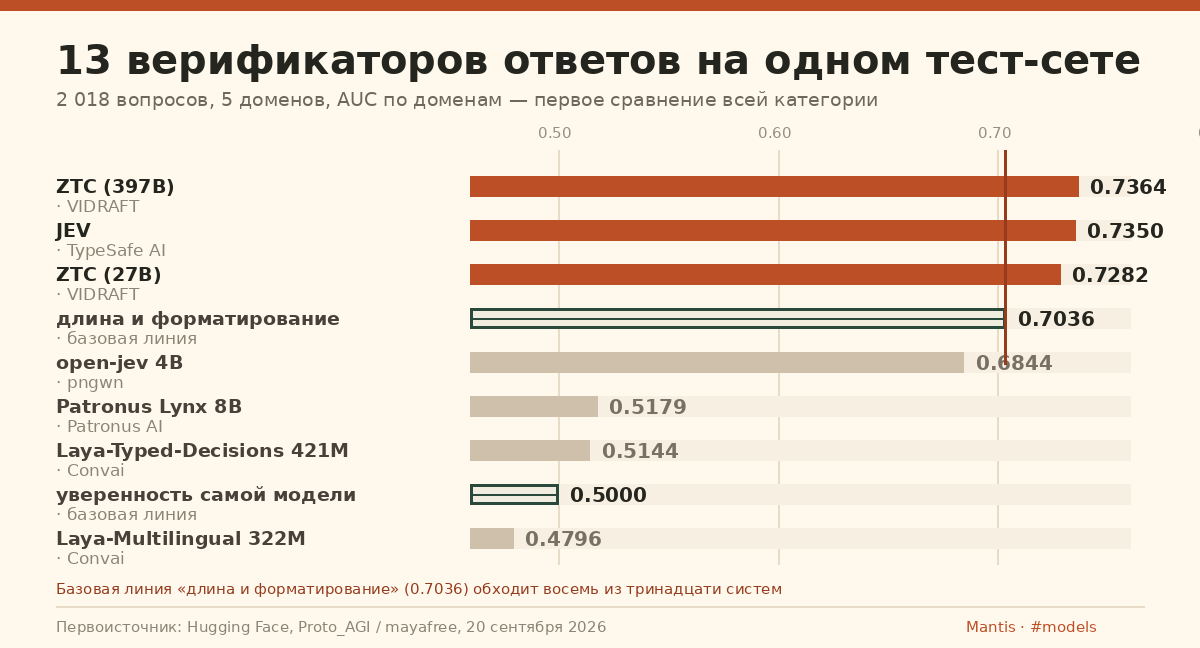
«Только три системы перешагнули 0,70»: тринадцать верификаторов ответов LLM впервые сравнили на одном тест-сете

20 сентября 2026 года на Hugging Face опубликовано исследование Proto_AGI (mayafree) «Inside the JEV Ecosystem: 13 Answer Verifiers on One Test Set»: тринадцать систем проверки ответов LLM измерены на одном наборе из 2 018 вопросов с одинаковыми метками по метрике AUC с агрегацией по доменам, а код оценки выложен публично.[1] Разрыв между первым и вторым местом составил 0,0014 AUC при интервале от −0,019 до +0,032, тогда как базовая линия, смотрящая только на длину и форматирование ответа, дала 0,7036 и обошла восемь из тринадцати систем.[1]

В Mantis: Первоисточник: 20 сентября 2026
Модели

«Больше исполнений слоёв на тот же набор параметров»: Layer-Feedback Transformer показал прирост на моделях 10M и 25M

19 сентября 2026 года на Hugging Face вышла работа Banaxi (Banaxi-Tech) об архитектуре Layer-Feedback Transformer: скрытое состояние проходит соседние слои трансформера несколько раз, число параметров не меняется, но вычислений становится в 2,3–2,7 раза больше. В контролируемых парах на 500M токенов LFT обошёл обычный трансформер на 10M и 25M параметров и проиграл на 2,5M.[1]

В Mantis: Первоисточник: 19 сентября 2026
Модели

«Числа могут быть настоящими, а вывод — нет»: аудит карточек моделей разобрал семь бенчмарков как маркетинг

17 сентября 2026 года на Hugging Face вышел технический аудит карточек моделей DavidAU и Nightmedia: автор разбирает, как семь коротких тестов с выбором ответа превращаются в заявления об «интеллекте уровня OpenAI, Claude и Gemini», почему заявка на контекст «2M» подкреплена блоками по 512 токенов и где опубликованные в карточках числа противоречат собственным выводам.[1]

В Mantis: Первоисточник: 17 сентября 2026
Модели

«Почти догнали SmolLM2 на 20× меньшем числе токенов»: 139M-модель BananaMind 2 Pro обучена на одной RTX 5070 Ti

BananaMind 2 Pro — базовая модель на 139 млн параметров, которую автор проекта Banaxi обучил с нуля на 100 млрд токенов на одной потребительской RTX 5070 Ti 16 ГБ. На общей батарее бенчмарков она удержала в среднем 96,08% результата SmolLM2-135M, обученной на 2 трлн токенов, а в слепом голосовании SLM Arena на момент снапшота вышла на первое место. Автор при этом прямо перечисляет, где модель проигрывает: ARC Easy, INT Index и особенно код.[1][2]

В Mantis: Первоисточник: 18 сентября 2026
Модели

OpenAI представила Astra for Law: GPT-6 Astra с юридическим поисковым индексом на 230 млн URL

Astra for Law — это GPT-6 Astra, дополненная юридическим поисковым индексом, инструкциями для правового анализа и настройками под конфиденциальную работу с клиентами. На 200 вопросах из приватного набора Vals AI Legal Research Bench новая конфигурация прошла проверку корректности в 54,0 % случаев против 38,7 % у GPT-6 Astra с обычным веб-поиском — относительный прирост 40 %. Сначала доступ получат отобранные юрфирмы через Trusted Access в ChatGPT и Codex, затем конфигурация появится в API как gpt-6-astra-law.[1][2]

В Mantis: Первоисточник: 17 сентября 2026
Модели

«Ни одна модель не выигрывает дважды»: лидерборд измерил цену, скорость и корейское качество у 425 моделей OpenRouter

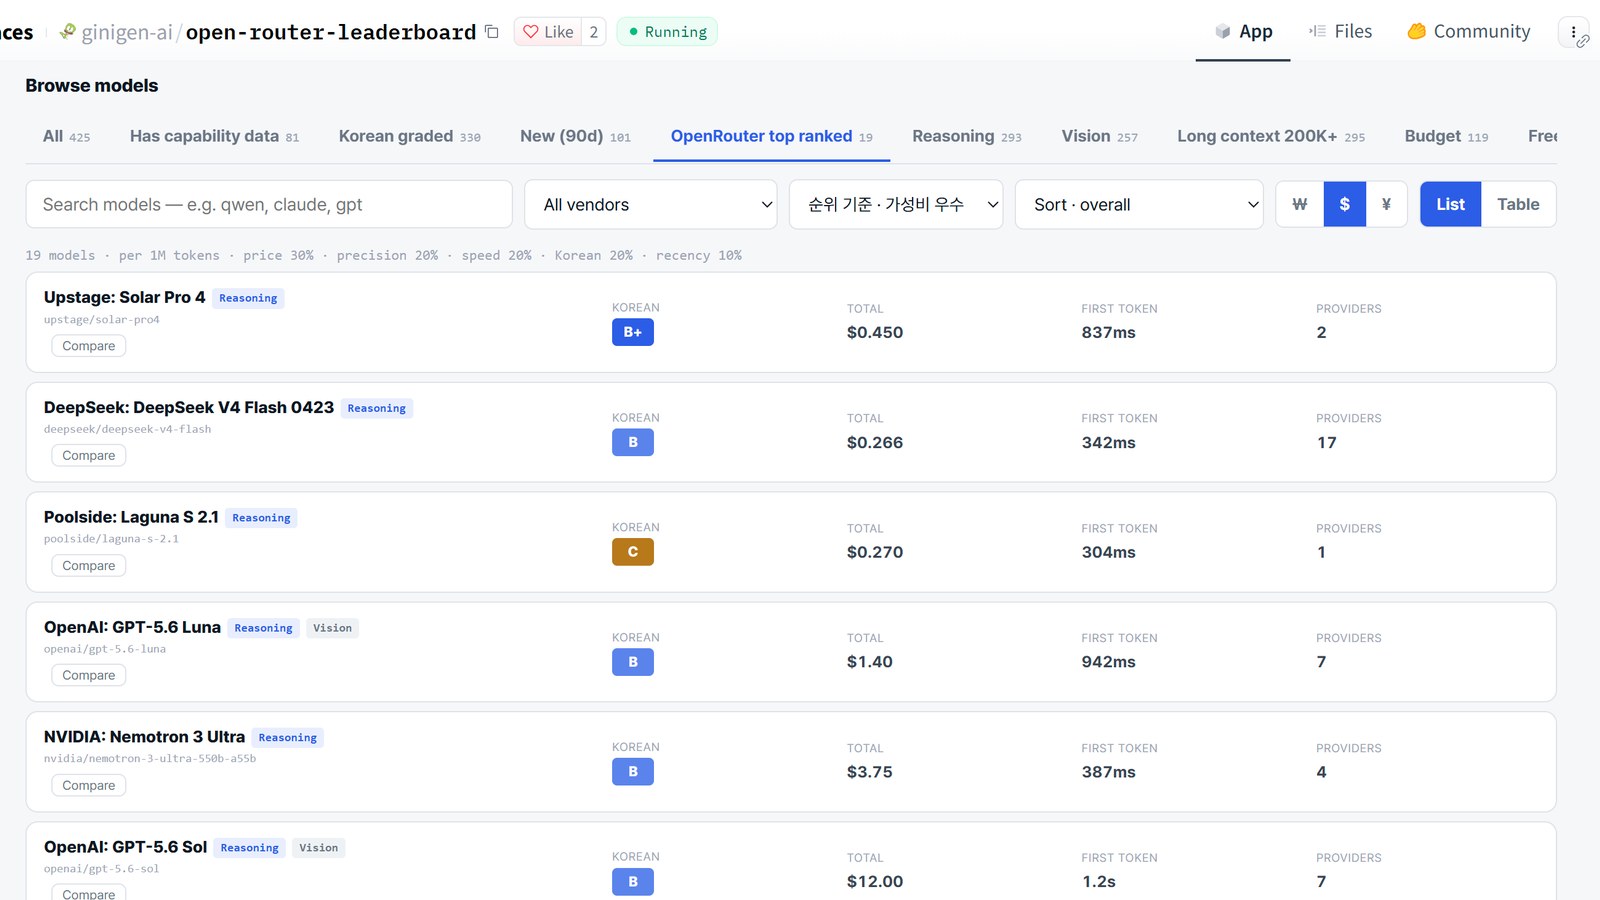
16 сентября 2026 года команда GiniGEN AI опубликовала на Hugging Face лидерборд всех моделей, перечисленных на OpenRouter: 425 моделей с ценой за миллион токенов, всех обслуживающих их провайдеров, измеренной авторами задержкой первого токена у 329 моделей и оценкой корейского языка у 330 моделей, которая не публикуется больше нигде.[1] Качество, цена и скорость возглавляют три разные модели, а корейский обваливается на двух осях: 8,5% моделей получают A за гоноративы и 9,4% — за знание корейских институтов.[1]

В Mantis: Первоисточник: 16 сентября 2026
Модели

«Говорит и думает одновременно»: Google выпустила Gemini 3.8 Live и 3.8 Live Extended Thinking

15 сентября 2026 года Google DeepMind представила две голосовые модели: Gemini 3.8 Live — для масштаба и недорогого диалога, и Gemini 3.8 Live Extended Thinking — для сложных задач, где модель рассуждает и говорит одновременно.[1] Обе выходят через Gemini API, Google AI Studio и Search Live, а Extended Thinking доступна в приватном превью Gemini Enterprise и в Docs Live, Gmail Live и Keep Live.[1] Из анонса: первое место в Speech to Speech Quality Index от Artificial Analysis с 82,6 балла, 68,6% на τ-Voice и 97,7% на Big Bench Audio.[1] Карточка модели уточняет рамки — контекст до 128K токенов, выход до 64K, база Gemini 3 Pro и дата отсечки знаний январь 2025 года.[2]

В Mantis: Первоисточник: 15 сентября 2026
Модели

DeepSeek выпустила V4.1-Flash: 552B MoE, 8B активных параметров и KV-кэш вчетверо меньше

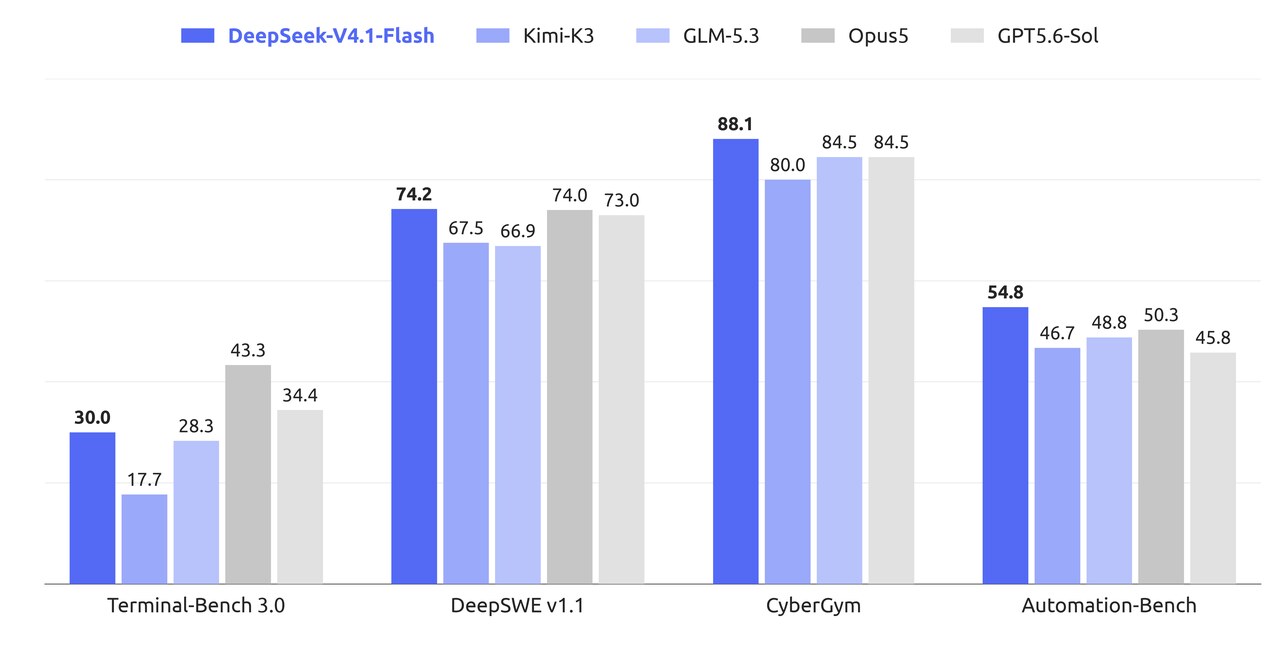
DeepSeek представила V4.1-Flash — самую компактную модель нового архитектурного семейства с нативным зрением, асимметричной архитектурой Causal Encoder-Decoder и сжатым до 890 байт на токен KV-кэшем. Новинка уже работает в API под именем deepseek-flash, а судьба V4-Pro описана в двух официальных текстах по-разному.

В Mantis: Первоисточник: 10 сентября 2026
Модели

Cohere открыла веса переводческой модели North Small Translate

MoE-модель поддерживает более 50 языков, активирует 25 из 218 млрд параметров и нацелена на быстрый перевод длинных документов — но опубликованные сравнения пока принадлежат самой Cohere.

В Mantis: Первоисточник: 10 сентября 2026
Модели

DeepSeek-V4.1-Flash сжимает KV-кэш ради контекста в миллион токенов

DeepSeek представила мультимодальную MoE-модель на 552 млрд параметров: новая архитектура сокращает оперативный KV-кэш вчетверо, а постоянный — в восемь раз относительно V4-Flash.

В Mantis: Первоисточник: 10 сентября 2026
Модели

AWS развернула Qwen3.8-2.4T-A95B на одном узле HyperPod

Открытая MoE-модель с 2,4 трлн параметров запускается на восьми NVIDIA B300 через vLLM и NVFP4. Официальная инструкция доводит развёртывание до OpenAI-совместимого endpoint, но не публикует готовый benchmark пропускной способности и задержки.

В Mantis: Первоисточник: 9 сентября 2026
Модели

IBM разместила gpt-oss-120b в watsonx.ai

Открытые веса OpenAI появились в корпоративной платформе IBM: большую модель можно разворачивать в собственном контуре, настраивать под рабочие процессы и дополнять отдельными защитными моделями.

В Mantis: Первоисточник: 7 августа 2025
Модели

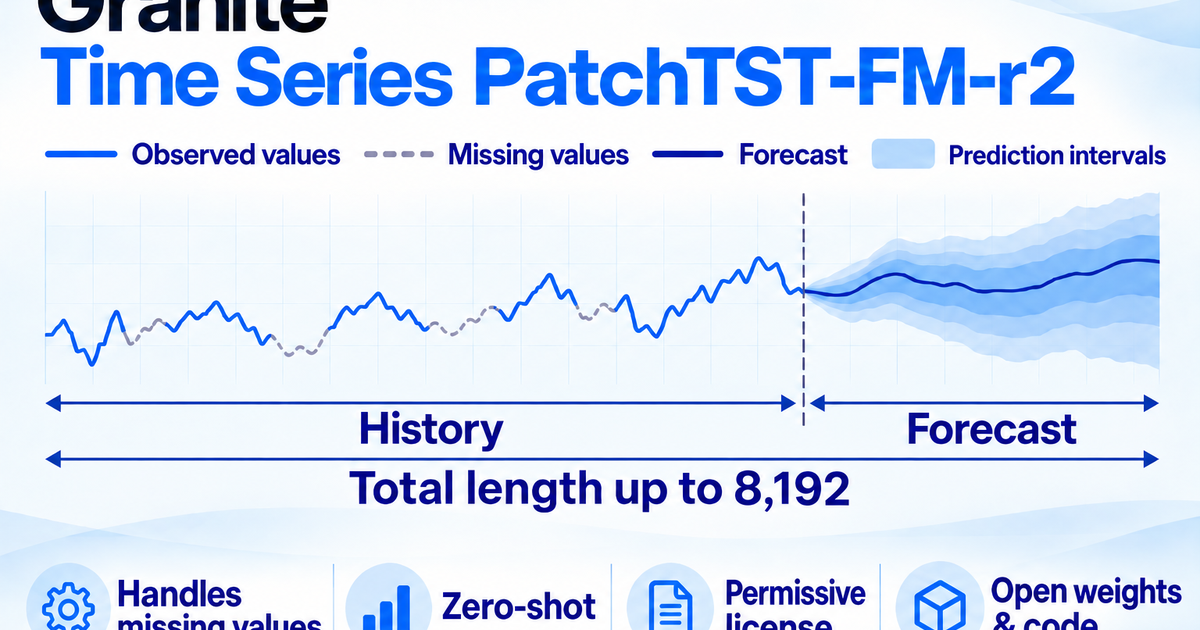
IBM открыла Granite PatchTST-FM-r2 для zero-shot прогнозирования временных рядов

Модель на 385 млн параметров сочетает self-attention с temporal convolution, принимает контекст до 8 192 точек и возвращает вероятностный прогноз по 99 квантилям. В GIFT-Eval она заняла второе место среди воспроизводимых zero-shot моделей, а IBM распространяет веса и код по Apache 2.0 или OpenMDW 1.0.

В Mantis: Первоисточник: 9 сентября 2026
Модели

GPT-6 Astra стала общедоступной в Microsoft Foundry

Microsoft объявила о доступности Astra в Foundry, вариантах развёртывания Global и US Data Zone и корпоративных средствах контроля. В центре предложения — многошаговая работа с приложениями, а не только диалог.

В Mantis: Первоисточник: 3 сентября 2026
Модели

OpenAI выпустила ChatGPT Images 2.5 с быстрым точечным редактированием

Новая модель генерации изображений точнее следует сложным инструкциям, меняет отдельные детали без полной перерисовки кадра и работает до четырёх раз быстрее. Доступ открыт в ChatGPT и через API как GPT-Image-2.5.

В Mantis: Первоисточник: 8 сентября 2026
Модели

Meta выпустила Muse Spark 1.3 для длинных agentic и coding-задач

Модель с max reasoning стала доступна в Muse Code и Meta Model API. Meta заявляет более устойчивое выполнение длинных инструкций, multitasking в одном thread и снижение расхода tool calls и tokens относительно версии 1.2.

В Mantis: Первоисточник: 2 сентября 2026
Модели

Microsoft выпустила MAI-Image-2.6 и ускоренную версию Flash

Обе модели поддерживают multi-image reference editing, web grounding и динамические форматы до 1.5K; точная MAI-Image-2.6 и быстрая Flash доступны разработчикам в Public Preview через Microsoft Foundry.

В Mantis: Первоисточник: 4 сентября 2026
Модели

Meta представила Muse Voice Transcribe для потокового распознавания речи

Одна autoregressive-модель объединяет streaming ASR, diarization и endpointing, адаптирует задержку к сложности слова, различает более 20 собеседников и работает с длинным многоязычным аудио.

В Mantis: Первоисточник: 1 сентября 2026
Модели

OpenAI выпустила GPT-6 Astra: ставка на самостоятельную работу за компьютером

Новая флагманская модель получила 72,6% на OSWorld 2.0 и, по данным OpenAI, выполняет эти задания примерно на 47% быстрее GPT-5.6 Sol. Доступ пока начинается с ограниченного круга организаций, затем Astra появится в ChatGPT, API и AWS.

В Mantis: Первоисточник: 3 сентября 2026
Модели

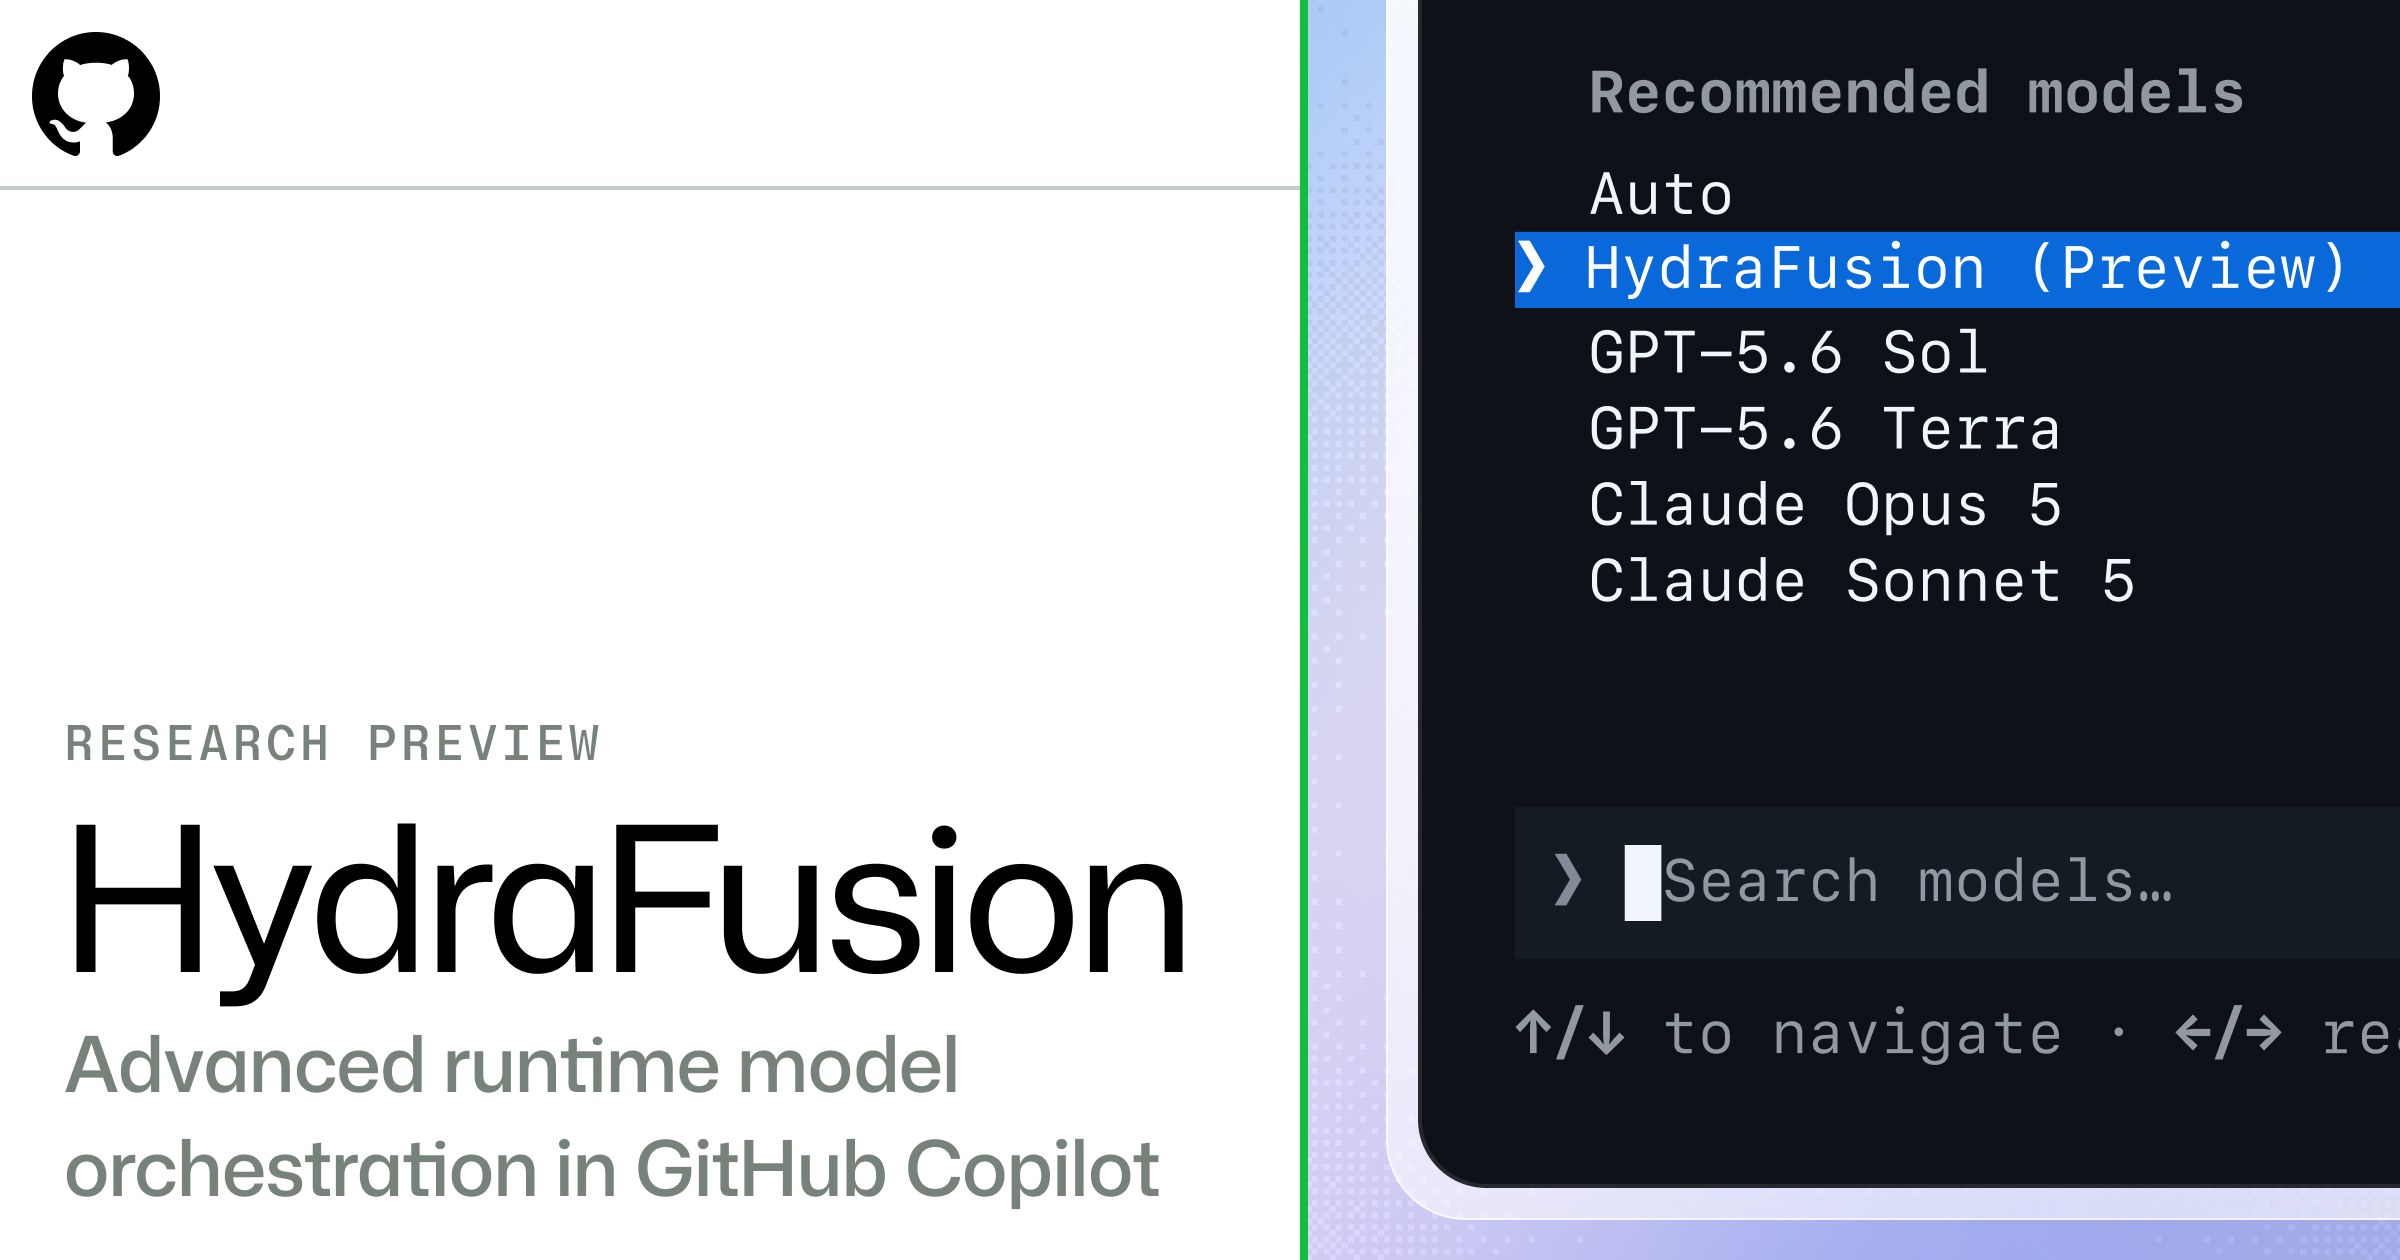
GitHub тестирует HydraFusion: Copilot сам собирает workflow из нескольких моделей

Research preview выбирает между одиночным ответом, каскадом и независимой критикой. GitHub обещает качество уровня frontier-моделей при меньшей оценочной стоимости, но пока опирается на контролируемые offline benchmarks.

В Mantis: Первоисточник: 4 сентября 2026
Модели

NeoMME объединила текст и изображения в одном encoder без отдельной vision tower

Модели на 260M и 800M параметров создают dense и late-interaction embeddings за один проход; авторы заявляют двукратный throughput и сжатие индекса с 1,5 MB до 6 kB на страницу.

В Mantis: Первоисточник: 3 сентября 2026
Модели

Gemini 3.8 Flash ускоряет агентов, а Cyber ищет и закрывает уязвимости

Google выпустила общедоступную Gemini 3.8 Flash и ограниченную Gemini 3.8 Flash Cyber. Первая нацелена на программирование и длинные агентные задачи, вторая — на поиск и автоматическое исправление уязвимостей у проверенных защитников.

В Mantis: Первоисточник: 2 сентября 2026
Модели

fal MiniMax H3 Max: видеогенерация быстрее реального времени без отказа от качества

fal дообучила модель MiniMax H3 с открытыми весами, связала модель с собственным inference-стеком и вывела на рынок систему, которая ставит во главу угла не отдельный рекорд, а баланс качества, управляемости и скорости.

В Mantis: Первоисточник: 2 сентября 2026
Модели

Anthropic выпустила Claude Fable 5.1 и Mythos 5.1: одна модель, два режима доступа

Новая флагманская система Anthropic получила контекст на 1 млн токенов, усилила агентное программирование и научные задачи, а доступ к наиболее чувствительным возможностям разделила между общедоступной Fable 5.1 и закрытой Mythos 5.1.

В Mantis: Первоисточник: 2 сентября 2026