Модели
«Короткая фраза на любом языке»: Qwen выпустила два 9B-рерайтера промптов к Qwen-Image-2.1
20 сентября 2026 года вместе с базовой моделью Qwen выложила два вспомогательных чекпоинта — Qwen-Image-2.1-PE-T2I и Qwen-Image-2.1-PE-I2I, и оба описаны как дообученные Qwen3.5-VL 9B.
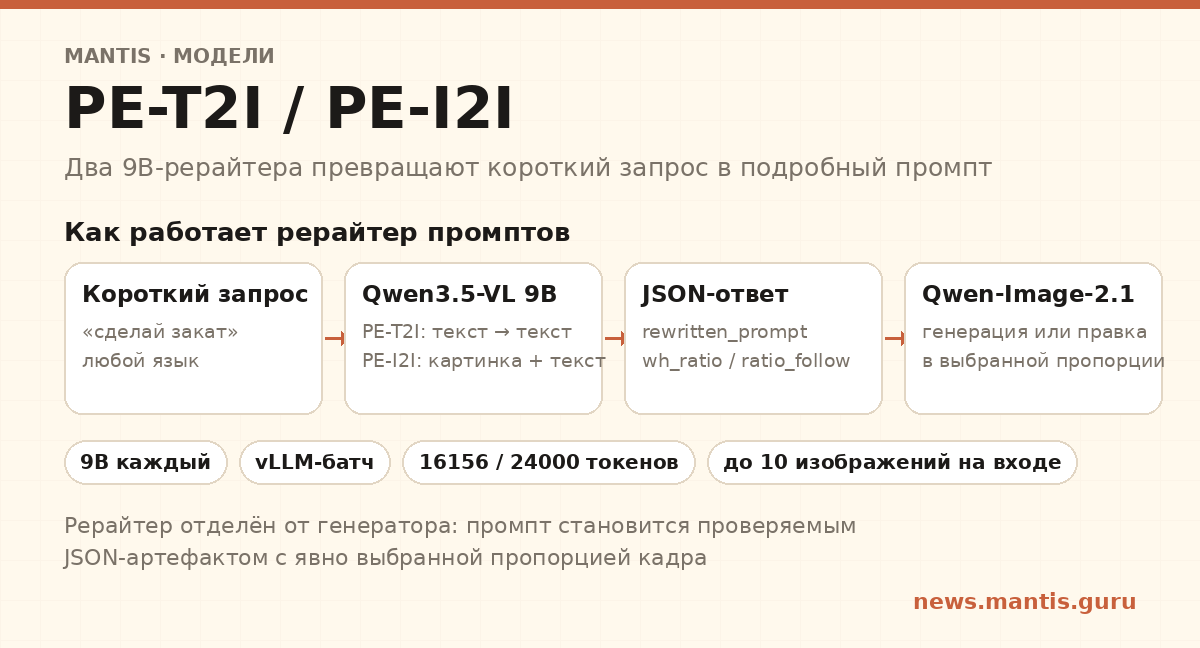
Первый превращает краткий запрос на любом языке в подробный английский промпт и рекомендованную пропорцию кадра, второй делает то же самое для редактирования: на вход идёт расплывчатое указание плюс одно или несколько изображений.
Официальный README рекомендует этот путь как основной: для лучших результатов короткие промпты следует расширять официальными моделями переписывания, потому что оба чекпоинта делят одну кодовую базу, которая сама определяет режим по входу.
Зачем понадобился отдельный рерайтер
Речь не о дообучении генератора, а о вынесенной наружу подготовке промпта: текстовая модель получает пользовательскую формулировку и возвращает уже готовое описание картинки, которое затем скармливается диффузионной модели. В карточке PE-T2I приведён пример запроса на китайском — «корги играет на гитаре под дождём» — и именно такие короткие формулировки рерайтер разворачивает в подробное английское описание с рекомендованной пропорцией.
Разделение задач даёт две независимые поверхности настройки: качество изображения определяется генератором, а точность попадания в замысел — рерайтером, которого можно менять и обновлять отдельно от основного чекпоинта. Для редактирования логика та же, но на вход дополнительно подаются изображения, а выходом становится не описание новой картинки, а конкретное, исполнимое указание для модели редактирования.
Формат ответа: JSON после блока рассуждений
Обе модели выводят объект JSON после блока рассуждений think. У PE-T2I в ответе два поля: rewritten_prompt — развёрнутый промпт для генератора — и wh_ratio, рекомендованная пропорция кадра.
У PE-I2I к ним добавляется третье поле: wh_ratio и ratio_follow взаимоисключающие, ровно одно из них заполнено. Поле ratio_follow означает, что пропорцию нужно наследовать у входного изображения, и в этом случае модель ссылается на него как на image1. Именно так решается вопрос кадра при правке на месте: новая композиция получает собственную пропорцию, а локальная правка — пропорцию исходника.
Сколько токенов и с какими параметрами
В примерах карточек генерация запускается с включённым режимом рассуждений и достаточно длинным лимитом новых токенов: 16 256 для PE-T2I и 24 000 для PE-I2I.
Сэмплирование в обоих примерах одинаковое — do_sample=True при temperature=1.0, top_p=0.95 и top_k=20.
Для PE-T2I достаточно установить transformers>=5.4.0, torch>=2.4.0, accelerate и pillow — отдельный пайплайн diffusers для рерайтера не нужен. PE-I2I работает через AutoModelForImageTextToText и AutoProcessor, то есть как обычная мультимодальная модель «изображение-текст».
Несколько изображений на входе
PE-I2I поддерживает несколько входных изображений и ссылается на них как на image1, image2 и далее. В README приведён пример «Place image1's subject into image2's scene» — перенос объекта с одного снимка в сцену другого, где модель сама разрешает, что именно нужно сохранить, а что — изменить.
Как это стыкуется с генератором
Связка описана в README: результат рерайтера подставляется в пайплайн QwenImage21Pipeline, а таблица WH_RATIO_TO_SIZE переводит рекомендованную пропорцию в конкретные размеры — 2048×2048 для 1:1, 2752×1536 для 16:9, 1536×2752 для 9:16, и если пропорция не распознана, используется 2048×2048.
Код рерайтера лежит в каталоге prompt_rewrite/ с единой точкой входа и переключателем задачи: run_transformers.py для локального инференса по одному примеру и run_vllm.py для офлайн-батча, который README называет рекомендованным режимом при масштабе. Во входном JSONL для редактирования указываются id, текст запроса и список входных изображений, то есть рерайтинг оформлен как пакетная операция над очередью запросов, а не как одиночный вызов в интерактиве.
Что это значит
Рерайтер превращает промпт в проверяемый артефакт: на выходе не свободный текст, а JSON с двумя-тремя полями, который можно залогировать, сравнить и переиспользовать без повторного прохода 9B-модели.
Это меняет структуру затрат — на каждый новый запрос добавляется отдельный текстовый проход, зато повторные генерации с тем же промптом его уже не требуют.
Второй эффект — язык: пользователь формулирует задачу на родном языке, а генератор получает английское описание, что снимает большую часть расхождений в качестве между языками.
Ограничение тоже видно из карточек: обе модели распространяются по Qwen Research License Agreement и требуют достаточно длинного лимита токенов на один ответ, а значит рассчитаны на батч, а не на мгновенный интерактив.