Модели
DeepSeek выпустила V4.1-Flash: 552B MoE, 8B активных параметров и KV-кэш вчетверо меньше
DeepSeek представила V4.1-Flash — самую компактную модель нового архитектурного семейства с нативным зрением, асимметричной архитектурой Causal Encoder-Decoder и сжатым до 890 байт на токен KV-кэшем. Новинка уже работает в API под именем deepseek-flash, а судьба V4-Pro описана в двух официальных текстах по-разному.
Что объявила DeepSeek
DeepSeek 10 сентября 2026 года выпустила V4.1-Flash — самую компактную модель нового архитектурного семейства, с нативным визуальным пониманием. Модель уже работает в DeepSeek API с поддержкой мультимодальности: чтобы обратиться к ней, достаточно указать в запросе имя deepseek-flash.
Прежние имена deepseek-v4-flash и deepseek-v4-flash-vision-exp пока принимаются, но соответствующие модели выведены из эксплуатации — запросы к ним обслуживает V4.1-Flash по цене Flash. Веса опубликованы на Hugging Face в репозитории deepseek-ai/DeepSeek-V4.1-Flash вместе с техническим отчётом.
Асимметричная архитектура: 8B параметров на входе и 16B на выходе
Главная особенность релиза — новая архитектура Causal Encoder-Decoder: всего 8B активных параметров на входе и 16B на выходе. Карточка модели уточняет, что это 40-слойный трансформер из 20-слойного причинного энкодера и 20-слойного декодера.
Инженерный смысл решения в том, что глобальный KV-кэш декодера проецируется из финальных скрытых состояний энкодера, а не выводится из собственных состояний каждого слоя декодера. Это позволяет активировать только 8B параметров на токен при префилле и 16B при декодировании, что заметно улучшает экономику задач с большим объёмом входных данных.
Базовая модель — это MoE на 552B параметров с поддержкой контекста до миллиона токенов. В каждом слое MoE один общий эксперт и 384 маршрутизируемых, из которых на токен активируются шесть. Обучение с нуля шло на мультимодальном корпусе объёмом 45 триллионов токенов.
KV-кэш: 890 байт на токен
Отдельный акцент релиза — экономия на кэше: по сравнению с предыдущим поколением V4.1-Flash требует вчетверо меньше HBM и в восемь раз меньше SSD-хранилища. Плата за попадание в кэш нередко составляет крупную долю расходов агентных систем, поэтому сжатие кэша напрямую сокращает счёт.
Карточка модели показывает масштаб в абсолютных числах: глобальный KV-кэш занимает 890 байт на токен, то есть примерно четверть от DeepSeek-V4-Flash, а постоянный след кэша сокращается примерно до одной восьмой.
Бенчмарки, цены и партнёры
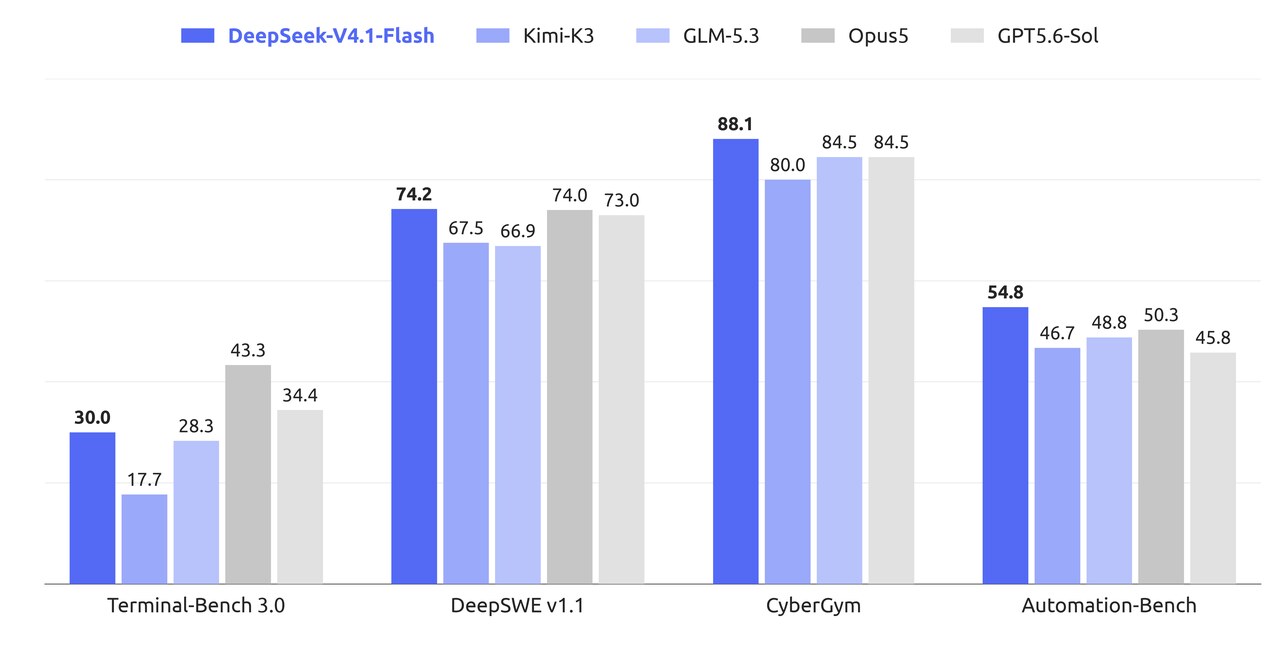
По заявлению компании, новые методы предобучения и крупномасштабное RL-дообучение дали результаты выше флагманских моделей, включая DeepSeek-V4-Pro. Тесты, проведённые несколькими независимыми сторонами, ставят V4.1-Flash впереди V4-Pro по производительности, стоимости, скорости и общему времени работы.
Тарификация осталась двухрежимной: вне пиковых часов ставка составляет половину пиковой, а новый прайс вступил в силу 10 сентября 2026 года в 04:00 UTC. Среди официальных партнёров, полностью поддержавших V4.1-Flash, названы WorkBuddy (включая CodeBuddy) и OpenCode. Компания также обещает вместе с открытым сообществом развивать инференс V4.1-Flash и расширять варианты развёртывания.
Что происходит с V4-Pro: две официальные страницы расходятся
Здесь Mantis фиксирует расхождение в официальных материалах, а не сглаживает его. В релизном посте сказано, что V4-Pro выводится из эксплуатации: начиная с 04:00 UTC 14 сентября 2026 года все запросы к deepseek-v4-pro будут маршрутизироваться на V4.1-Flash по его тарифам, и так — до выхода V4.1-Pro.
Актуальная страница Quick Start формулирует иначе: «In response to user demand, we have decided to continue providing API services for DeepSeek V4 Pro after September 14, 2026, with the billing method remaining unchanged». То есть документация обещает сохранить сервис V4 Pro после 14 сентября с прежней тарификацией.
Оба текста опубликованы на одном официальном домене, и официального разъяснения, какая версия окончательная, найти не удалось. Читателю, который планирует миграцию, стоит проверить актуальную страницу Quick Start перед изменением конфигурации.
Что это значит
Для пользователей API релиз означает прежде всего смену имени модели и пересчёт экономики агентных нагрузок: длинный контекст и повторное использование кэша становятся дешевле, а асимметричный энкодер-декодер обещает снизить цену именно входных токенов. Для рынка это ещё один шаг к моделям, спроектированным под агентов, а не под одиночный диалог. И отдельный практический урок: даже официальные страницы одной компании могут обновляться несинхронно, поэтому миграцию стоит планировать по самому свежему источнику, а не по анонсу.