Модели
Kandinsky 6.0 Video: открытая модель генерирует видео и синхронный звук 44 кГц — от текста и картинки
6 октября 2026 года лаборатория Kandinsky Lab открыла исходный код Kandinsky 6.0 Video — семейства диффузионных моделей, которые генерируют пятисекундные клипы вместе с синхронной звуковой дорожкой. Семейство состоит из двух размеров: Lite на 3 млрд параметров и Pro на 29 млрд. Обе версии работают в режимах text-to-audio-video и image-to-audio-video, выдают звук с частотой дискретизации 44 кГц с липсинком и с помощью модели сверхразрешения доводят картинку до Full-HD. Код, веса и интеграция с diffusers опубликованы под лицензией MIT.
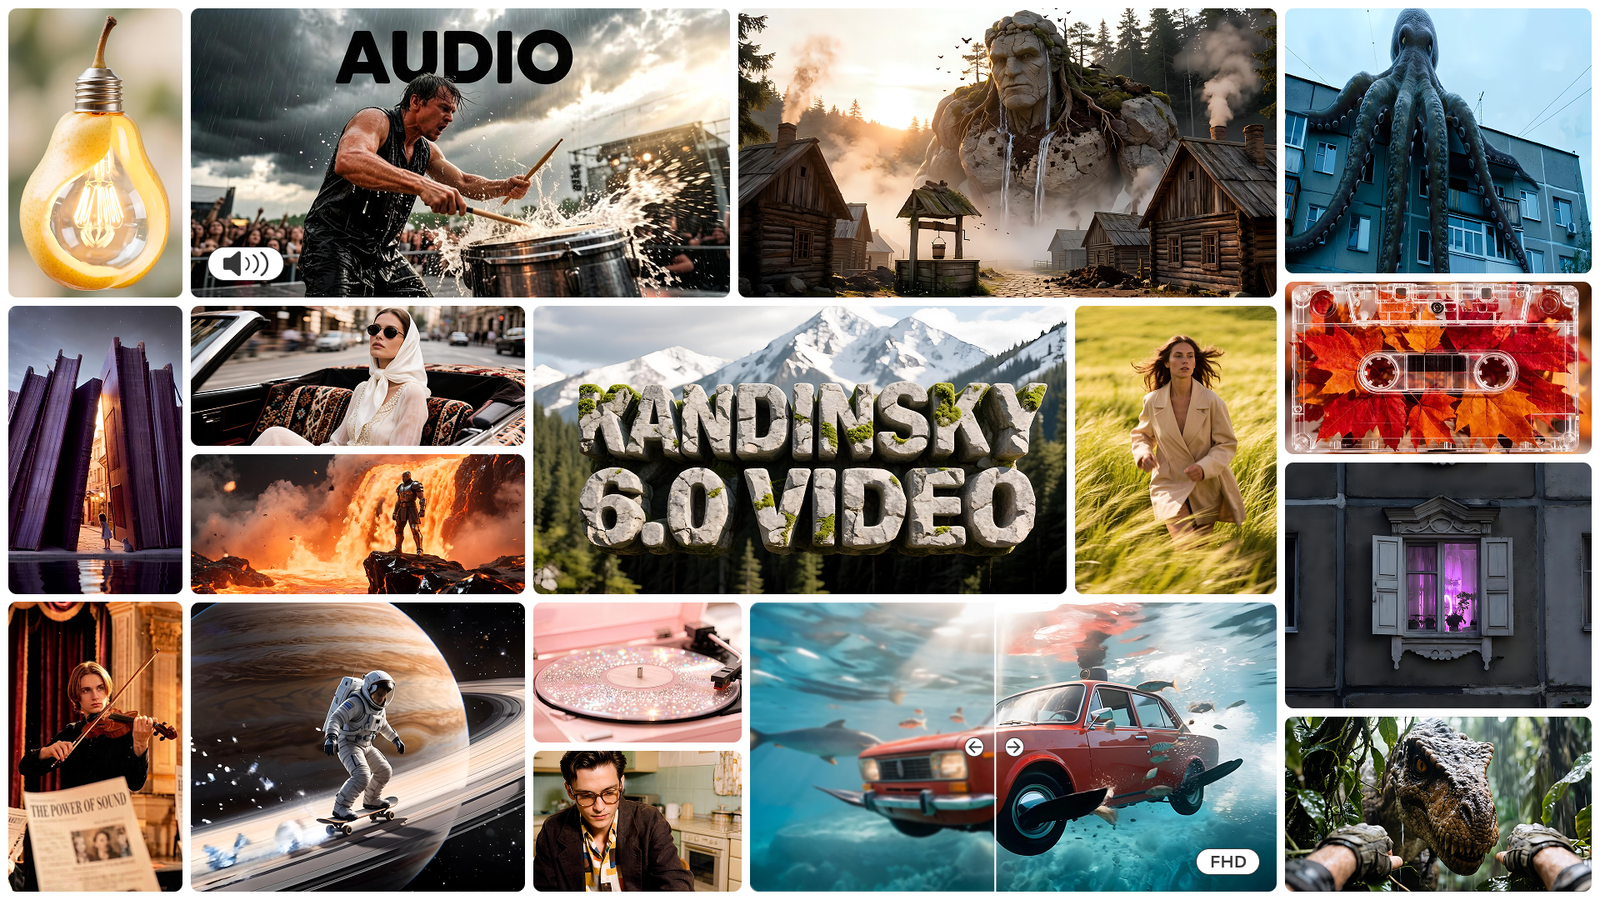
Два размера в одном релизе
Kandinsky 6.0 Video — это семейство фундаментальных диффузионных моделей для синхронной генерации видео со звуком. В отличие от связки «видеомодель плюс отдельный аудиогенератор», здесь картинка и звук рождаются в одном процессе: обе версии создают пятисекундные клипы с синхронной дорожкой 44 кГц, включая липсинк. Младшая версия — Lite на 3 млрд параметров, старшая — Pro на 29 млрд параметров. Поддерживаются два режима: text-to-audio-video (T2AV), когда всё строится от текстового описания, и image-to-audio-video (I2AV), когда за основу берётся готовое изображение.
Технический отчёт лаборатории появился 4 октября, а исходный код, веса и интеграция с библиотекой diffusers были открыты под лицензией MIT 6 октября. Тогда же в репозиторий добавили поддержку vLLM-omni и выложили демо-пространство на Hugging Face для дистиллированной версии.
Как устроена архитектура
В основе Kandinsky 6.0 Video — двупоточная архитектура CrossDiT. Она соединяет заранее обученный видеопоток и заново обученный аудиопоток через двунаправленное кросс-внимание, которое отвечает за временное и семантическое согласование двух модальностей. Идея в том, что видеоветка уже умеет строить согласованное движение, а аудиоветка учится ложиться на это движение, а не подстраиваться под него постфактум.
Обучение построено как непрерывный претрейн: сначала аудиопоток обучают с нуля на больших аудиокорпусах, затем оба потока обучают совместно на парных аудио-видео данных, сохраняя точность каждой модальности по отдельности. После претрейна идут дообучение с учителем, посттренировка с подкреплением и дистилляция. Именно дистилляция даёт быстрые варианты, пригодные для потребительских карт.
Что вошло в релиз
Лаборатория выложила не только веса: под MIT опубликованы код, контрольные точки моделей и интеграция с diffusers. В каталоге доступны пять наборов весов — pro, pro-pretrain, lite, lite-distill и lite-pretrain. Для ComfyUI добавили два узла — kandinsky6 и kandinsky6-sr, которые ставятся через менеджер и не требуют ручного копирования файлов. В репозитории также лежат примеры входных изображений и готовые рабочие процессы для обоих режимов.
Отдельно появилась поддержка vLLM-omni — серверного движка для мультимодального инференса — и демо-пространство дистиллированной версии Pro на Hugging Face. То есть модель можно взять как библиотеку, как сервер или как готовое демо.
Что показало сравнение
В слепом сравнении с участием людей Kandinsky 6.0 Video Pro уверенно превосходит предшественника — Kandinsky 5.0 Video Pro — и остаётся конкурентоспособной на фоне ведущих моделей генерации видео со звуком. Авторы отдельно отмечают качество речи: по нему новая модель особенно близка к лучшим решениям.
Kandinsky 6.0 Video продолжает открытую линию лаборатории — предыдущее поколение тоже публиковалось с открытыми весами и кодом. Под MIT здесь отдано всё вместе: код, контрольные точки и интеграция с diffusers, что, по замыслу авторов, должно ускорить открытые исследования и развёртывание в мультимедийной генерации.
Скорость и требования
Пятисекундный клип на недистиллированной модели занимает от нескольких минут, и разброс между картами большой. По таблице из репозитория, на H100 это 239 секунд для Lite в стандартном разрешении и 356 секунд для Pro, а Pro в Full-HD — 402 секунды. На потребительских картах дольше: RTX 4090 даёт 437 секунд для Lite и 1247 секунд для Pro в Full-HD, RTX 5060 Ti — 1310 секунд для Lite. Замеры не учитывают загрузку весов и кодирование MP4.
Сборка требует NVIDIA-графики и Python 3.13 или 3.14. На Hopper (H100 и H200) ставятся PyTorch под CUDA 13.0 и FlashAttention 3, на Ampere, Ada и потребительском Blackwell — PyTorch под CUDA 13.0 и SageAttention 2.2.0 с модульным или блочным выгрузом памяти. Для компиляции SageAttention нужен nvcc в PATH, а CUDA_HOME по умолчанию указывает на /usr/local/cuda.
Как запустить
Запуск описан в репозитории: клонировать проект, поставить окружение через uv и just, затем команда `just download pro-distill` скачает дистиллированную модель, а `just generate "a cat on a mat"` соберёт первый клип. Пресеты под конкретные карты лежат в kandinsky/configs/devices.
Готовое демо дистиллированной версии доступно как пространство на Hugging Face, а серверная поддержка пришла в vLLM-omni. Модель можно запускать и в ComfyUI через штатные узлы.
Почему это заметно
Модель, которая генерирует видео и синхронный звук в одном проходе и при этом отдана под открытой лицензией, остаётся редким случаем. Kandinsky 6.0 Video выходит под MIT с весами, кодом и интеграцией с diffusers, поэтому генерацию видео со звуком можно разворачивать на своём железе и адаптировать под свои задачи.
Первоисточники
- Kandinsky 6.0 Video: Foundation Models for Synchronized Video and Audio Generation — технический отчёт лаборатории
- kandinskylab/kandinsky-6 — официальный репозиторий, исходный код открыт 6 октября 2026
- Kandinsky-6.0 — коллекция моделей Kandinsky Lab на Hugging Face
- Kandinsky Lab — официальный сайт лаборатории