Модели
«Точная копия System 1 — это и точная копия его слепых зон»: AutoTrust выпустила открытую JEV-27B, дистиллированную из закрытой TypeSafe Jev 1.13
Средний KL ≈ 0,017 на 25 376 удержанных вопросах из 53 доменов и 84,07 % против 83,85 % в среднем по шести публичным бенчмаркам: открытая модель на Apache-2.0 повторяет распределения закрытой TypeSafe Jev 1.13 и отвечает за 137 мс на одной B200, а System 2 остаётся нетронутой — все 164 ответа HumanEval побайтово совпали с Qwen3.8-27B.
Что выпустила AutoTrust AI
27 сентября 2026 года лаборатория AutoTrust AI представила autotrust/JEV-27B — открытую модель класса System 1 с весами под лицензией Apache-2.0, которая обучена повторять поведение закрытой TypeSafe Jev 1.13.
Учителем выступила сама Jev 1.13: студент обучался на опубликованных распределениях вероятностей закрытой модели, а не на человеческой разметке. Корпусом дистилляции стал SargeDev/jev-distill-corpus-v3 — 740 957 строк под Apache-2.0, причём поток openjev_v2 дополнительно доступен под CC0.
AutoTrust отдельно оговаривает границу между проектами: новая модель не связана с TypeSafe AI, не одобрена ею и не является её продуктом, общих весов и кода у них нет.
JEV-27B — второе поколение этого подхода: первым был autotrust/JEV-9B, у которого System 2 работает на Qwen3.5-9B, а System 1 — на 40,2 млн обученных параметров.
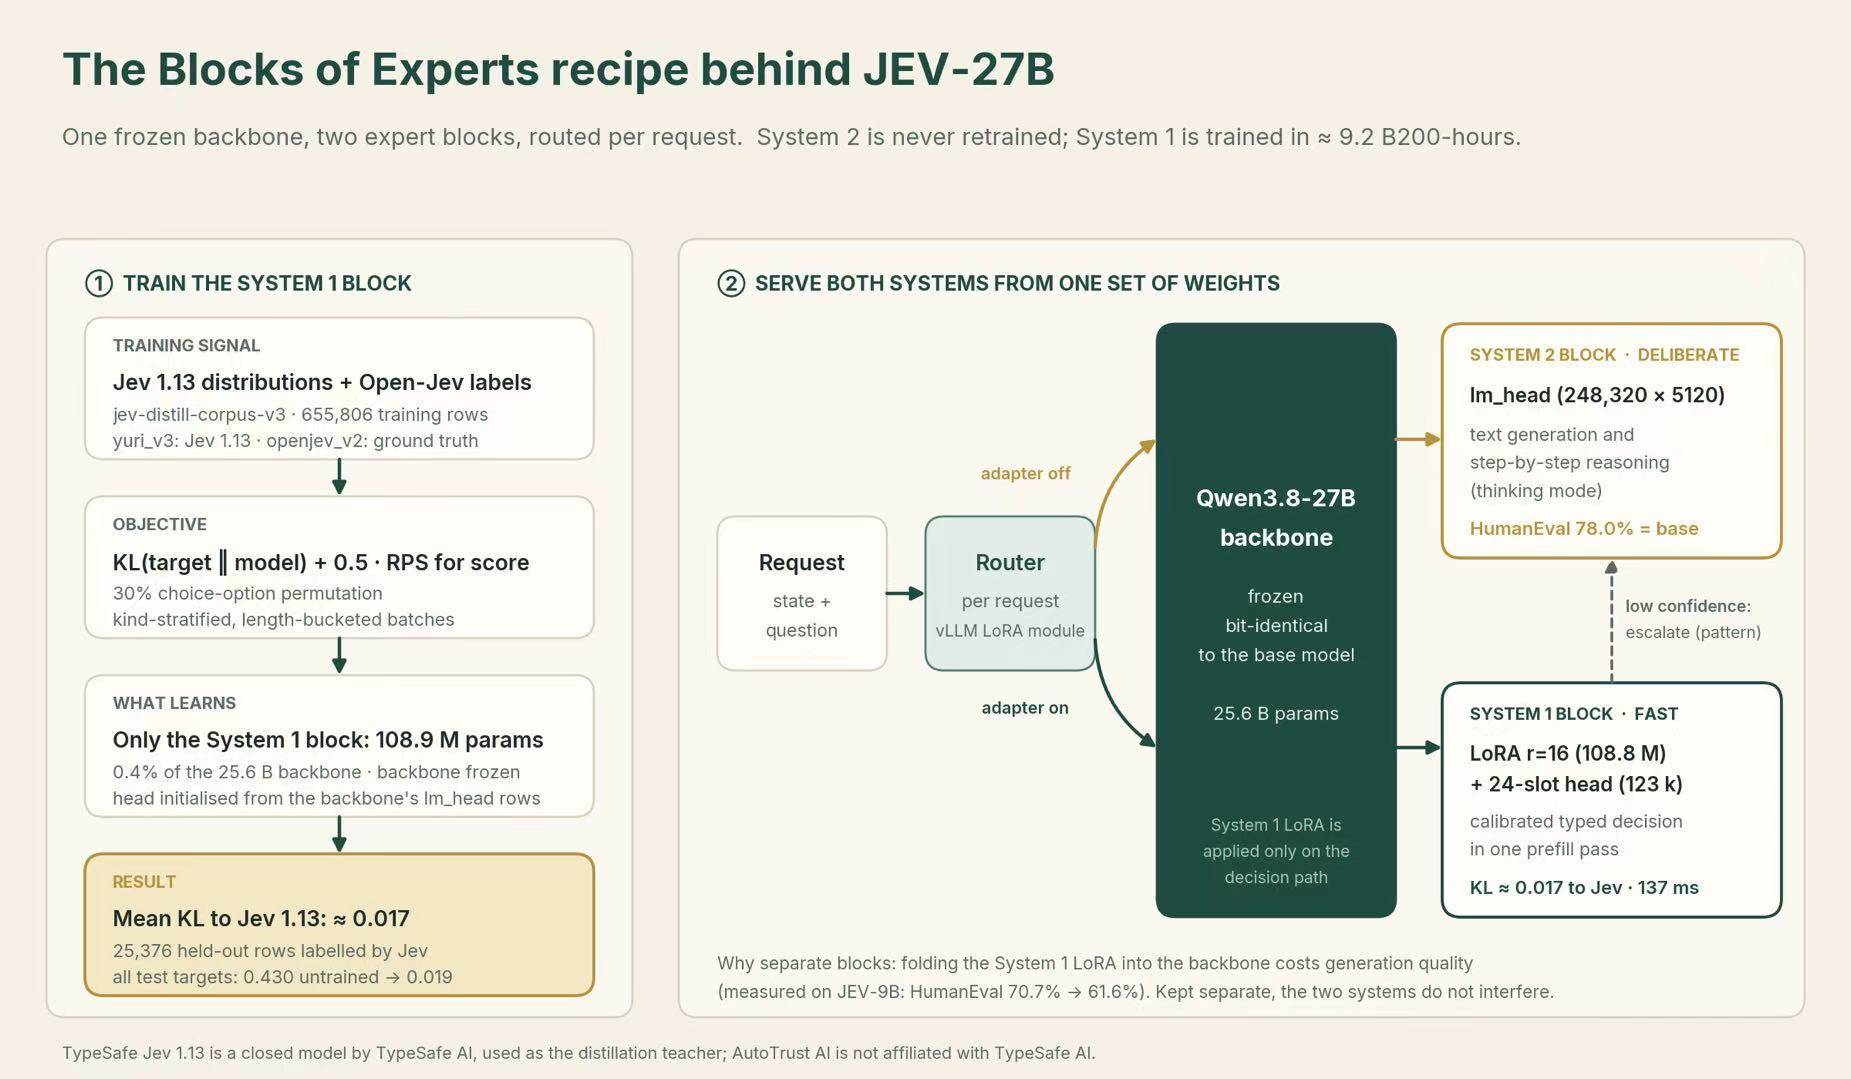
Устроено это так: System 2 — нетронутый Qwen3.8-27B, а System 1 — 108,9 млн обученных параметров, то есть 0,4 % от backbone, обученных примерно за 9,2 часа на одной B200.
Две системы из одного набора весов
Модель собрана по рецепту Blocks of Experts: сильная претрейновая модель остаётся замороженным экспертным блоком, а к ней добавляется небольшой съёмный блок, обученный под одну способность. Запрос сам выбирает систему: в vLLM это LoRA-модуль jev-decision для решений и базовый lm_head для обычной генерации.
System 1 отвечает на три вида типизированных вопросов — noul («верно ли утверждение»), choice (выбор из 2–16 вариантов) и score (шкала 0–5) — за один forward pass, без декодирования и разбора JSON, и возвращает калиброванное распределение вероятностей, по которому можно выставлять порог.
Голова решений инициализируется строками lm_head базовой модели, поэтому на нулевом шаге её ответ совпадает с zero-shot ответом претрейна: согласие с целями по choice составляло 58 % при AUROC 0,88, а после дистилляции выросло до 90 % и 0,996.
Блоки намеренно не сливают в один набор весов: у JEV-9B сложенный LoRA дал 61,6 % на HumanEval против 70,7 % у базовой модели — минус девять пунктов, поэтому backbone остаётся бит-в-бит неизменным.
Что показывают замеры
На шести публичных бенчмарках решений — JevBench, Kev, OpenJev text, Nimble, VitaminC и MASSIVE-en — JEV-27B набирает в среднем 84,07 % против 83,85 % у хостед-версии TypeSafe Jev 1.13 в прогонах самой AutoTrust. Выше она в четырёх группах из шести, отставание — на Kev (−1,77 п. п.) и VitaminC (−1,00 п. п.).
Среди открытых моделей с полным набором результатов следующая — NeoHorse-Jev-4B с 77,70 %, на 6,37 пункта ниже, причём её числа взяты из отчёта NeoHorse, а не перемерялись.
Ключевая метрика здесь — расхождение распределений: на 25 376 удержанных вопросах из 53 доменов, размеченных собственными распределениями Jev 1.13, средний KL ≈ 0,017. По примитивам это 0,004 для noul, 0,025 для choice и 0,021 для score, а наблюдателю нужно около 60 решений, чтобы набрать один нат доказательства о том, какая из двух моделей их выдала.
Сопутствующие метрики: AUROC для noul 0,995, совпадение top-1 с Jev 90,5 %, средняя абсолютная ошибка оценки 0,098 шага шкалы и ECE 0,0009 без пост-хок коррекции — подобранные температуры составили 1,014, 1,016 и 1,004.
На незнакомых семействах задач KL к программной разметке падает до 0,104 при точности top-1 0,942, а на независимом бенчмарке с человеческими метками студент даёт 96 % точности учителя при 16 вариантах и 98 % при 2, 4 и 8 вариантах.
System 2 при этом не деградировала: HumanEval 78,0 % до и после дистилляции, все 164 ответа побайтово совпадают с базовой моделью.
По скорости JEV-27B отвечает за медианные 137 мс на одной B200 против 238 мс в среднем и 291–301 мс по медиане у хостед-API. Один GPU держит около 130 решений в секунду против 23 у хостед-варианта, а в батче из 128 решений — 4,2 мс на решение.
Оставаясь открытой и обслуживая обе системы из одних весов, JEV-27B продолжает линию JEV-9B: KL к распределениям Jev снизился с ≈0,019 до ≈0,017, KL на незнакомых семействах задач упал с 0,234 до 0,104, а HumanEval вырос с 70,7 % до 78,0 %.
Вместе с тем JEV-9B остаётся быстрее — 2,6× — и даёт 90 % точности Jev при 16 вариантах, так что выбор между поколениями зависит от задачи.
Что модель не решает
AutoTrust прямо называет дистилляцию копированием, а не независимым судейством: там, где учитель ошибался или был плохо откалиброван, ошибается и студент.
Это видно на свежих примерах: в покерном споте с натсом модель идёт в олл-ин с уверенностью 0,63 против 0,62 у учителя, вопрос на подсчёт даёт 0,48 — подбрасывание монеты, — а около 7 % ответов на 16 вариантов меняются от одного лишь изменения порядка вариантов: 7,0 % у учителя и 7,4 % у студента.
Утверждение «неотличимо» измерено только на строках с метками Jev из 53 доменов обучения: набора с метками Jev вне этих доменов в корпусе нет, а метрики переноса получены против программной разметки. Паритет — по среднему, а не по каждой задаче.
Две системы объединены только в сервинге: System 2 — немодифицированная базовая модель, она не знает, что решила System 1, и их ответы могут расходиться.
Модель англоцентрична, а поток yuri_v1 в корпусе состоит из заглушек [0,5; 0,5], поэтому использовать JEV-27B для оценки релевантности памяти без дообучения нельзя.
Итоговая рекомендация авторов — гейтинг по уверенности и человек в контуре для высокорисковых решений: список слабых мест (многошаговые рассуждения, арифметика, даты, подсчёт, состязательные входы) унаследован от учителя.
Как запустить и что дальше
Один инстанс vLLM обслуживает обе системы из одних и тех же весов: обычные запросы идут через базовый lm_head, а адресованные LoRA-модулю jev-decision — через голову решений. Для корректных лог-вероятностей нужен флаг --logprobs-mode processed_logprobs, а --max-model-len 4096 рассчитан на решения.
Веса занимают около 54 ГБ в bf16. Для меньших GPU есть JEV-9B на 18 ГБ в bf16, а запуск JEV-27B на двух RTX 5090 остаётся оценкой по арифметике памяти, без замеров.
Лицензия — Apache-2.0, как и у базового Qwen3.8-27B; корпус дистилляции тоже Apache-2.0, а его поток openjev_v2 доступен под CC0.
Дальше AutoTrust обещает отправить модель на независимые доски Jev Decision Index и JevBench v1.4.2, собрать набор с метками Jev вне обучающих доменов и задокументировать развёртывание на двух RTX 5090. До появления независимых подтверждений все числа остаются самозаявленными, включая сравнение скорости с хостед-API.
Первоисточники
- Hugging Face — AutoTrust AI Lab, «autotrust/JEV-27B: fast, calibrated decisions and full reasoning from one open model» (Community Article, 27 сентября 2026)
- Hugging Face — карточка модели autotrust/JEV-27B (AutoTrust AI): отчёт об обучении, бенчмарки, ограничения и лицензия
- Hugging Face — карточка модели autotrust/JEV-9B (AutoTrust AI, первое поколение System 1 + System 2)
- Hugging Face — карточка датасета SargeDev/jev-distill-corpus-v3 (корпус дистилляции, Apache-2.0)