Модели
«Ни одна модель не выигрывает дважды»: лидерборд измерил цену, скорость и корейское качество у 425 моделей OpenRouter
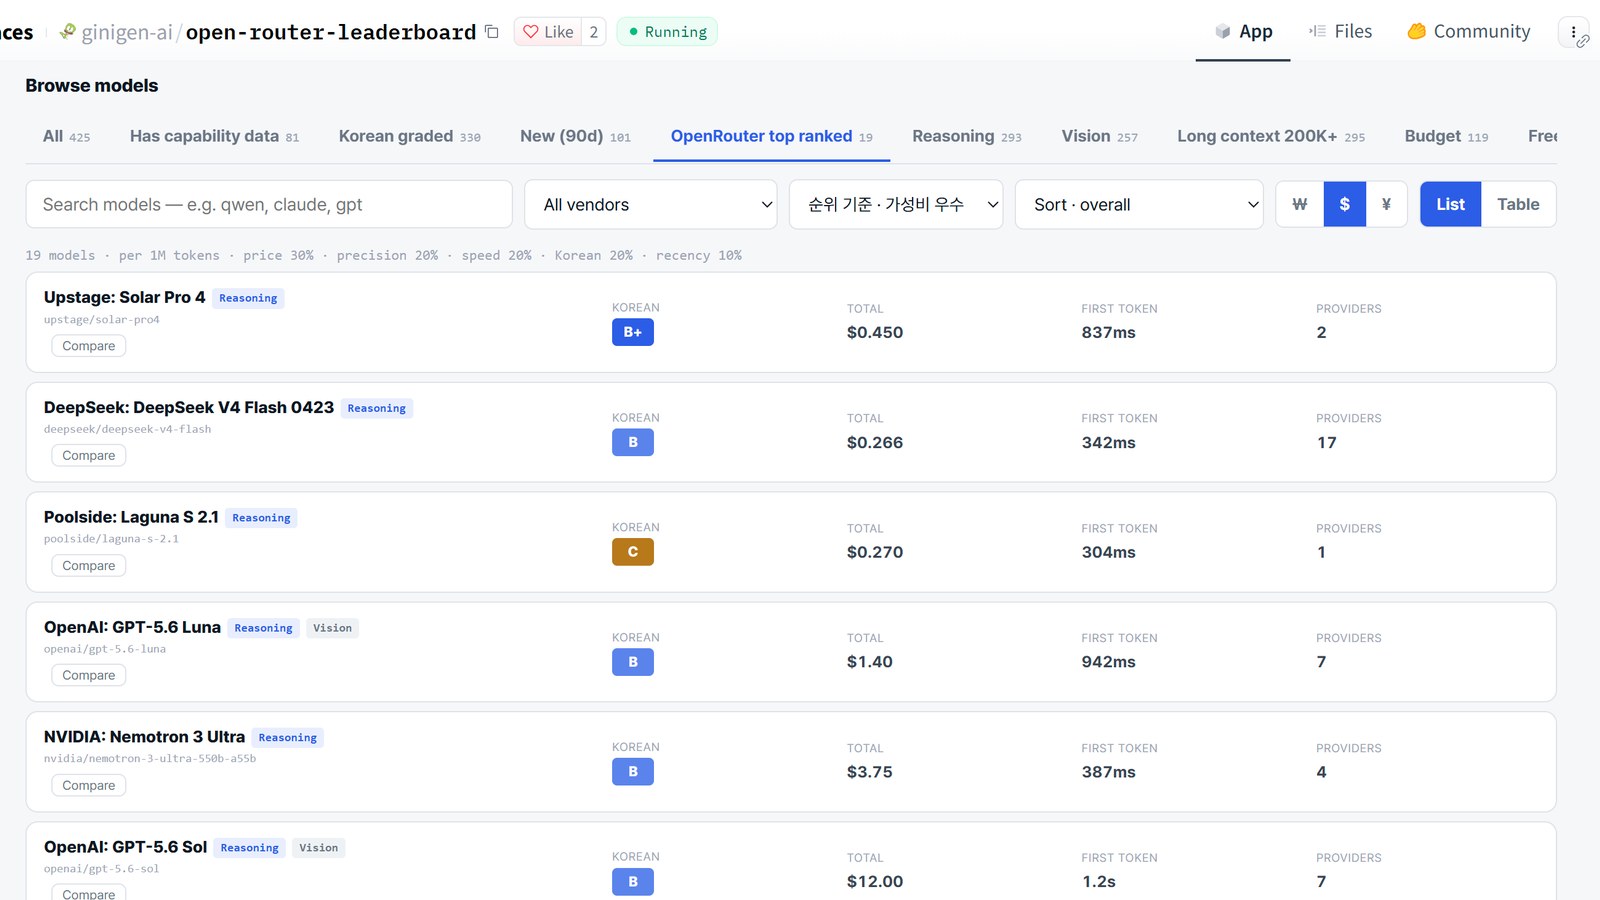
16 сентября 2026 года команда GiniGEN AI опубликовала на Hugging Face лидерборд всех моделей, перечисленных на OpenRouter: 425 моделей с ценой за миллион токенов, всех обслуживающих их провайдеров, измеренной авторами задержкой первого токена у 329 моделей и оценкой корейского языка у 330 моделей, которая не публикуется больше нигде. Качество, цена и скорость возглавляют три разные модели, а корейский обваливается на двух осях: 8,5% моделей получают A за гоноративы и 9,4% — за знание корейских институтов.
Что именно измерили
Рейтинг строится по тому, что определяет покупку: цена за миллион токенов, провайдеры каждой модели с их точностью вычислений и аптаймом, длина контекста, скорость ответа и качество языка. Данные о ценах, провайдерах и трафике взяты из публичного API OpenRouter — официальная документация описывает его как унифицированный интерфейс, который нормализует схему моделей и провайдеров, чтобы учить её нужно было один раз.
Две колонки в таблице принадлежат авторам проекта, потому что их не существовало: измеренная скорость ответа и оценка корейского языка.
Корейская колонка — причина, по которой проект вообще появился: статистика по языку запросов показывает, что запросы на корейском приходят, но не показывает, годится ли вернувшийся корейский для корейского офиса, — а для команды, которая ставит API перед корейскими клиентами, это единственный вопрос, который имеет значение. Оценка сделана для 330 моделей.
Три языка, три валюты, ежедневное обновление — и явно обозначенная граница между заимствованными и измеренными данными: цены, провайдеры и трафик берутся из чужого API, задержка и корейская оценка считаются своими средствами.
Корейский распадается на семь осей
Единая оценка «корейского» скрыла бы главное, поэтому авторы оценивают семь осей независимо: регистр (удержание единого формального или неформального уровня через весь ответ), знание корейских институтов (закон об отпусках, налоговые категории, процедуры госорганов — факты, а не беглость), соблюдение формата (выполнение прямого указания вроде «ответ ровно двумя предложениями»), гоноративы (субъектные и объектные, включая ошибки, которые носитель замечает мгновенно), точность резюме (сохранение цифр и имён при сжатии), терминология (профессиональная лексика в финансах, праве, инженерии) и свобода от переводного языка (читается ли текст как корейский или как переведённый английский).
Каждая ось оценивается A/B/C/F, затем усредняется и сворачивается в восемь полос — от A+++ до F.
Лидер в каждой колонке — своя модель
На вопрос «какая модель лучше в корейском» лидерборд даёт три разных ответа в зависимости от того, что имелось в виду.
По качеству первым идёт Google: Nano Banana 2 (Gemini 3.1 Flash Image) с полосой A+++. По отношению оценки к цене — Mistral: Mistral Nemo, $0.049 за миллион токенов при оценке C. По измеренной задержке первого токена — NVIDIA: Nemotron 3 Nano Omni (бесплатная версия), 128 мс при оценке F.
Тот же рисунок повторяется на всех осях, которые отслеживает проект, — интеллект, программирование, агентные задачи, Elo арены: лидер по качеству почти никогда не лидер по цене и почти никогда не лидер по скорости, а лидерборд с единственной ранжированной колонкой отвечает на вопрос, которого никто не задавал.
Две оси обваливаются, и именно они нужны в офисе
Разрыв между осями и есть главный результат: доля оценок A по гоноративам — 8,5% против 51,8% оценок F, по знанию корейских институтов — 9,4% против 54,7%. Дальше идут терминология (31,2% против 44,2%), соблюдение формата (47,6% против 34,2%), точность резюме (49,2% против 37,4%), свобода от переводного языка (53,1% против 33,4%) и регистр (53,3% против 32,7%).
Модели, которые пишут беглый корейский — чистый регистр, без переводного языка, — проваливаются на гоноративах и не подают вида, что провалились: текст, где гоноратив применён к неодушевлённому предмету, одновременно беглый и неправильный, а это хуже очевидно сломанного вывода, потому что на вычитке такое не ловится.
Ось институционального знания проваливается по другой причине: это вообще не языковая задача — корейское трудовое право и налоговые категории являются фактами, и модель, которая их никогда не видела, уверенно изобретает их на безупречном корейском.
Распределение: треть поля — F
По итоговым полосам картина такая: A+++ — 5 моделей (1,5%), A++ — 2 (0,6%), A+ — 18 (5,5%), B+ — 55 (16,7%), B — 58 (17,6%), C — 52 (15,8%), D — 29 (8,8%), F — 111 (33,6%). Треть поля проваливается полностью, и меньше 8% моделей дотягиваются до любой полосы A.
Среди пяти моделей с идеальными 3,00 оказался gpt-3.5-turbo-16k — модель 2023 года — рядом с флагманами 2026-го, а gpt-3.5-turbo-0613 получает A++. Вывод авторов узкий и практичный: корейский модели нельзя вывести из даты её выхода, числа параметров или результатов английских бенчмарков — его приходится измерять по каждой модели отдельно.
Скорость измеряли сами
Поле задержки в публичных данных о моделях пустое, поэтому авторы вызвали 329 моделей через платный API с одинаковым промптом и записали задержку первого токена и число токенов в секунду.
Этот замер показывается рядом с p50–p99 перцентилями OpenRouter, которые агрегируют тысячи реальных запросов: величины отвечают на разные вопросы — агрегат описывает установившееся поведение на трафике, собственный замер описывает один контролируемый вызов с известным промптом, провайдером и моментом времени, — и подписаны они раздельно, а не слиты в одну цифру, чтобы каждую можно было проверить другой. Собственный вызов даёт и то, чего в агрегате нет: какой провайдер обслужил запрос, с какой точностью вычислений и в какой момент.
Как держали оценку честной
Судья не видит названия оцениваемой модели и запускается только после того, как правильно ответит на все контрольные вопросы с известными ответами. Контрольный набор фиксируется заранее, а прогон при промахе по контролю блокируется, а не сопровождается предупреждением.
Загрязнение символами считается механически, а не оценивается: доли ханча, каны и хангыля вычисляются кодом, потому что это арифметика, а передача арифметики языковой модели добавляет разброс ни за что. Если оценено меньше пяти осей из семи, оценки нет вовсе — она помечается частичной, поэтому верхнюю полосу нельзя получить, блеснув на одном вопросе.
Сторона предложения
Из 107 провайдеров, обслуживающих эти модели, 55 находятся в США, 6 — в Сингапуре, 6 — в Китае, остальные разбросаны по другим странам; 33 штаб-квартиру не раскрывают. Среди 74 раскрывших корейских нет ни одного.
Проект показывает страну штаб-квартиры провайдера и расположение его дата-центров в карточке модели, потому что это первый вопрос корейских корпоративных закупок — где физически оказываются данные, — и ни один публичный лидерборд этого не показывает.
Как этим пользоваться
Всё живёт в Space на английском, корейском и китайском языках с ценами в долларах, вонах и юанях. Можно выбрать стартовую точку — кодинг-агенты, длинные документы, высокий объём, реальное время, корейская работа, мультимодальность — или скомбинировать фильтры, сравнить от двух до четырёх моделей со всеми семью осями и поделиться точной ссылкой на отфильтрованный вид.
Оценка корейского стоит рядом с ценой и задержкой, поэтому дешёвая модель, которая ломается на корейском, видна сразу, а не через две вкладки. Открытые эндпоинты без ключа: /api/korean — оценки с детализацией по осям, /api/speed — измеренная задержка первого токена и токены в секунду, /api/models — цены, контекст, модальности; обновление ежедневно в 08:00 по корейскому времени.
Что в публикации не сказано
Промптов и состава контрольного набора в публикации нет: семь осей описаны словами, но самих заданий и шкал, по которым ставится A или F, не приведено, поэтому воспроизвести оценку сторонним читателем нельзя.
По каждой модели указан результат без числа прогонов и без даты замера, а семь осей авторы называют предложением, а не стандартом. Использованный судья — языковая модель — не назван, как и его версия: известно только, что он не видит имени оцениваемой модели и проходит контрольный набор.
Заявленные 425 моделей и измеренные 329 — это снимок на момент публикации: рейтинг обновляется ежедневно, поэтому цифры в тексте относятся к 16 сентября 2026 года. Публикация — статья сообщества на Hugging Face, написанная командой GiniGEN AI, а не пресс-релиз лаборатории.