Модели
Liquid AI выпустила DSpark-драфтер для LFM2.5-VL-3B: до 3,13× быстрее на устройстве и до 2,66× на H100
Liquid AI представила экспериментальный драфтер DSpark для своей vision-language модели LFM2.5-VL-3B. Заявленное ускорение декодирования — до 2,66× на GPU и до 3,13× на устройствах, при росте числа параметров всего на 8,9% и без изменения качества вывода. На M3 Ultra прирост скромнее: 1,57–2,14× на декодировании.
Что выпустили
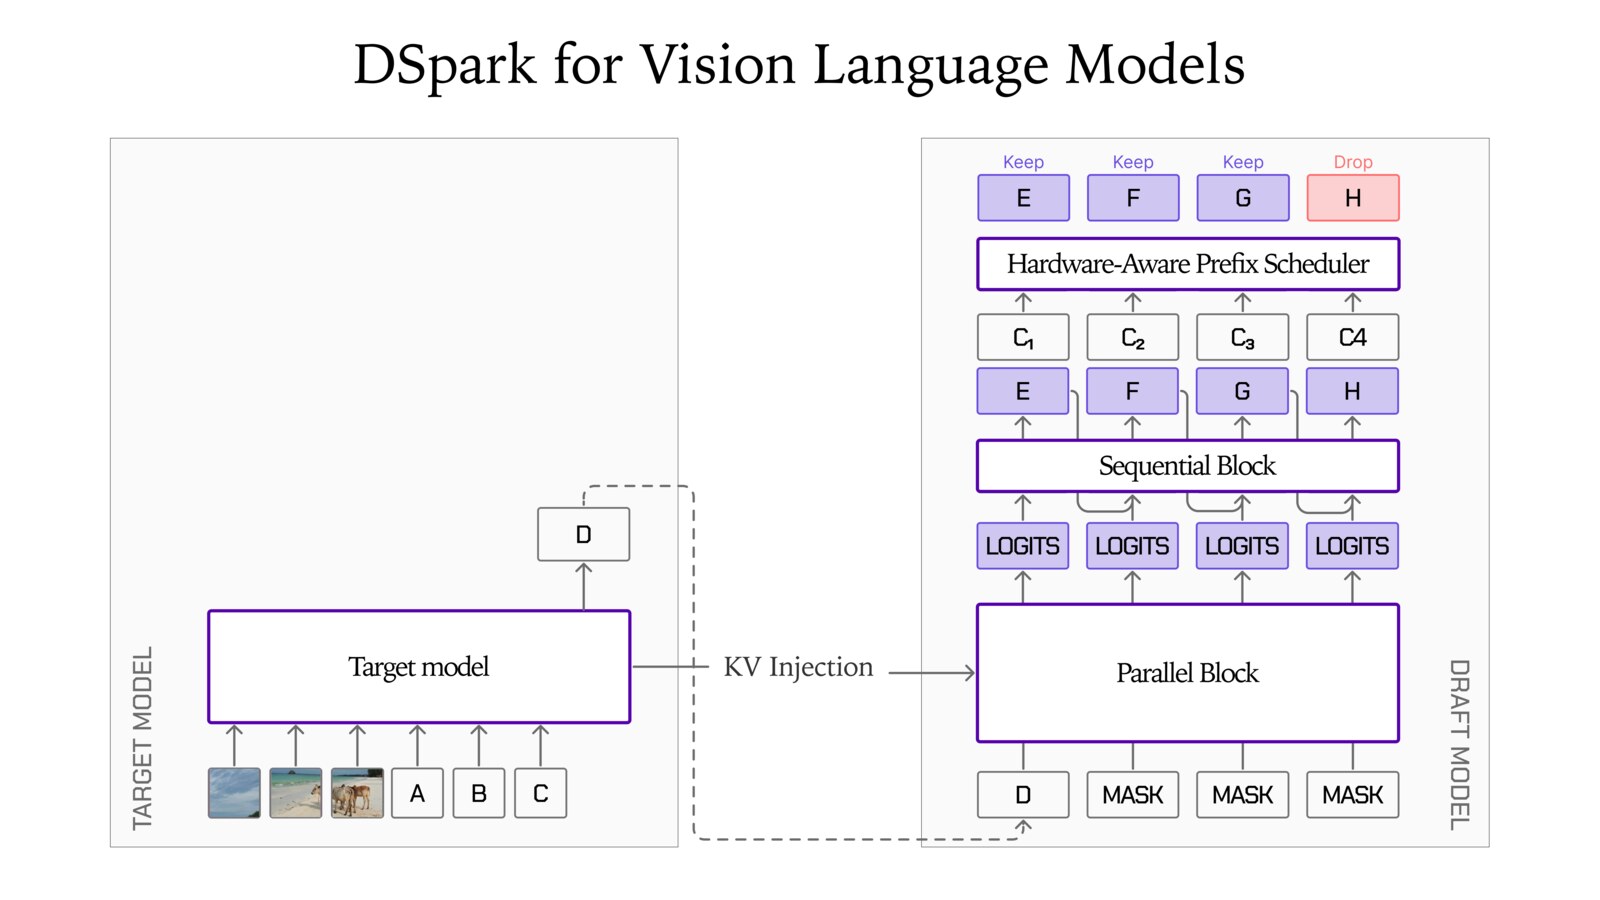
Liquid AI выпустила экспериментальный DSpark-драфтер для своей vision-language модели LFM2.5-VL-3B. Как и в ранее выпущенных драфтерах LFM2.5-DSpark для текстовых Liquid Foundation Models, он добавляет путь спекулятивного декодирования: минимальный рост потребления памяти в обмен на заметно более быстрое декодирование без изменения качества вывода.
Модель опубликована на Hugging Face в форматах Safetensors и GGUF, и с первого дня заявлена поддержка в llama.cpp, MLX-VLM и SGLang.
Как устроен драфтер
Драфтер снимает скрытые состояния целевой модели на фиксированном наборе слоёв и на их основе предлагает блок из k токенов-кандидатов. С точки зрения драфтера модальность входа не важна: к моменту, когда токены доходят до скрытых слоёв, текст и патчи изображения представлены многомерными тензорами, поэтому алгоритм вывода для vision-language модели тот же, что и для текстовых.
Финальная смесь обучающих данных — supervised fine-tuning на типовых vision-language задачах со смещением в сторону рабочих нагрузок, под которые модель предназначена. Архитектура драфтера — упрощённая attention-only модель, число слоёв и размер блока выбраны абляциями; обучение шло 10 эпох с замером доли принятия на каждом этапе. В итоге выбраны 4 слоя и размер блока 9, а на инференсе рекомендуется 8 или 9 в зависимости от железа.
Состав драфтера опубликован отдельной таблицей: 193,0 млн параметров в стеке декодера, 21,0 млн — проекция скрытых состояний, 65,5 млн — Markov head, 6,4 тыс. — нормы и head уверенности. Итого около 279,5 млн параметров, то есть рост числа параметров развёрнутой модели всего на 8,9%; эмбеддинги и LM head привязаны к целевой модели и драфтером не переносятся.
Отдельная деталь: все абляции и обучающие прогоны выполнены исключительно на оборудовании AMD с использованием собственного тренировочного фреймворка Liquid AI.
Замеры: устройства и GPU
На устройствах замеры велись в FP16, при размере батча 1, температуре 0, блоке 8 и до 2 048 выходных токенов. С MLX-VLM на M5 Max декодирование ускоряется в 2,30–3,13× в зависимости от задачи, сквозная задержка улучшается в 1,56–2,62×. С llama.cpp на M3 Ultra декодирование быстрее в 1,57–2,14×, сквозное время — в 1,30–1,77×.
На GPU замеры шли в SGLang на одной H100 80 ГБ в BF16 при размере блока 9: декодирование ускоряется в 2,04–2,66×, сквозная пропускная способность растёт в 1,64–2,27×. На странице поста на Hugging Face в одном месте указано «20,4x to 2.66x», тогда как в блоге Liquid AI та же величина приведена как 2,04×; ниже мы приводим значение из блога производителя.
Набор задач один и тот же — шесть типов по бенчмарку MMSpec: общий VQA, текстовый VQA, подписи к изображениям, VQA по графикам, сложные рассуждения и многоходовой диалог. Для замеров использовалась инфраструктура Pipette, на которой Liquid AI публикует данные о производительности устройств; ускорение квантованных моделей в этот релиз не входит.
Доля принятых драфтов составила примерно 3,2–4,5 токена на проход верификации на устройствах и 3,46–4,57 на H100 — она зависит от драфтера и рабочей нагрузки, а не от железа или рантайма.
Почему на устройствах выигрыш скромнее
В больших языковых моделях предзаполнение в основном ограничено вычислениями, а его стоимость растёт почти квадратично с длиной промпта. В vision-language моделях к этому добавляется vision-энкодер: изображение сначала проходит через него, а затем языковой бэкбон обрабатывает сотни визуальных токенов вместе с текстовым промптом.
На устройствах вычислений заметно меньше, чем на серверных GPU, поэтому предзаполнение занимает более существенную долю сквозной задержки. Спекулятивное декодирование ускоряет только фазу декодирования, оставляя vision-кодирование и предзаполнение неизменными. Когда эти этапы уже занимают большую часть времени, даже крупное ускорение декодирования даёт лишь умеренный сквозной выигрыш — это классический пример закона Амдала.
Температура, точность и оговорки
При совпадающих настройках сэмплирования спекулятивное декодирование эквивалентно по распределению прямому сэмплированию из целевой модели, то есть вывод остаётся точным: целевая модель проверяет каждый предложенный токен, поэтому при жадном выводе результат совпадает с результатом одной целевой модели.
При росте температуры драфтер и целевая модель чаще расходятся: доля принятия падает, а вместе с ней и пропускная способность. Отдельно замерена граница между агрегированной пропускной способностью системы и скоростью генерации у отдельного пользователя при росте конкурентности — все тесты в SGLang на одной H100. Преимущество DSpark сохраняется на всех измеренных уровнях, но разрыв сужается.
Существенная оговорка: модель названа экспериментальной, а все приведённые в публикациях числа получены на собственной инфраструктуре Liquid AI. Независимых замеров в источниках нет.
Как запустить
Для SGLang нужна сборка с поддержкой DSpark для целей LFM2 (PR #40651): сервер запускается с указанием спекулятивного алгоритма DSPARK и драфтера LiquidAI/LFM2.5-VL-3B-DSpark, при этом размер блока читается из config.json драфтера, а базовый вариант — та же команда без трёх флагов --speculative-*. Для llama.cpp нужна сборка с PR#29339, для MLX-VLM — с PR#2280; в MLX-VLM размер блока берётся из метаданных драфтера, а n-max ограничивается этим значением.
На странице поста перечислены три модели: целевая LFM2.5-VL-3B размером 3B и драфтеры LFM2.5-VL-3B-DSpark и LFM2.5-VL-3B-DSpark-GGUF размером 0,3B. Сам драфтер доступен в Safetensors и GGUF.
Первоисточники
- Liquid AI Blog — «LFM2.5-VL-DSpark: Accelerating vision-language models on edge and beyond» (24 сентября 2026): состав драфтера 279,5 млн параметров, рост на 8,9%, 4 слоя и блок 9, обучение на AMD, замеры на M5 Max и M3 Ultra, SGLang на H100 80 ГБ, MMSpec, инфраструктура Pipette, влияние температуры, границы спекулятивного декодирования, команды запуска
- Hugging Face — «Accelerating vision-language models with LFM2.5-VL-DSpark» (Liquid AI, 24 сентября 2026): анонс drafter-модели, заявленные ускорения, поддержка llama.cpp, MLX-VLM и SGLang с первого дня, точность спекулятивного декодирования при жадном выводе, команды запуска и ссылки на пул-реквесты
- Hugging Face — модель LiquidAI/LFM2.5-VL-3B-DSpark: карточка драфтера (0,3B), форматы Safetensors и GGUF