Модели
IBM открыла Granite PatchTST-FM-r2 для zero-shot прогнозирования временных рядов
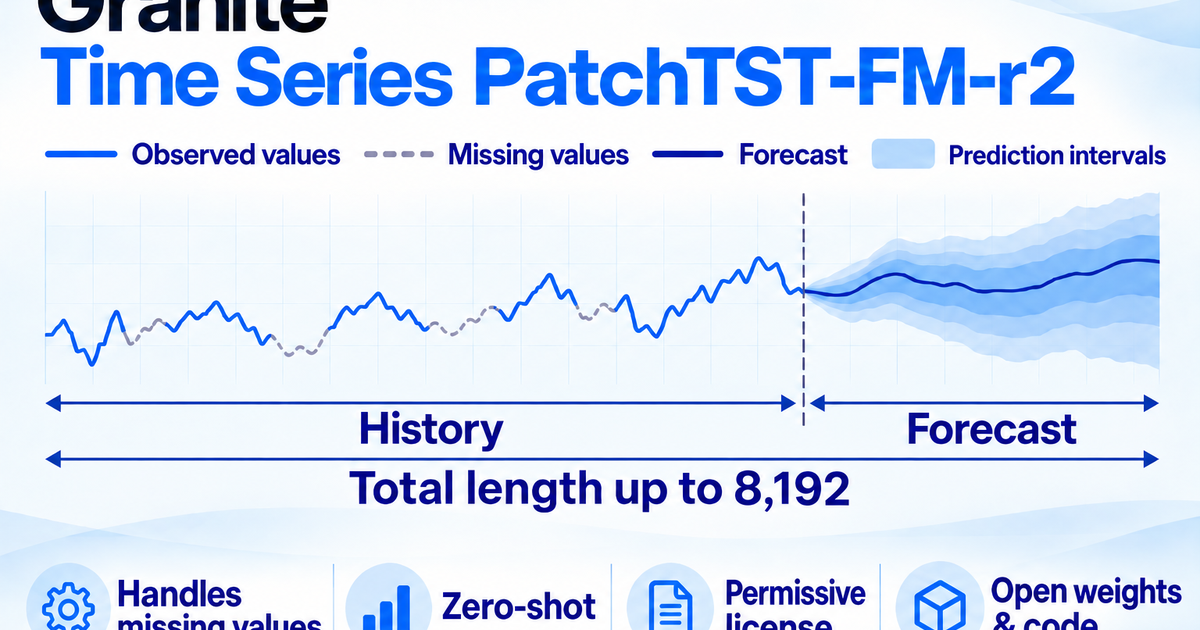
Модель на 385 млн параметров сочетает self-attention с temporal convolution, принимает контекст до 8 192 точек и возвращает вероятностный прогноз по 99 квантилям. В GIFT-Eval она заняла второе место среди воспроизводимых zero-shot моделей, а IBM распространяет веса и код по Apache 2.0 или OpenMDW 1.0.
Один pretrained model вместо отдельной модели для каждого ряда
IBM Research выпустила Granite Time Series PatchTST-FM-r2 — foundation model для прогнозирования временных рядов без предварительного обучения на данных конкретного пользователя. Zero-shot режим означает, что модель получает уже наблюдавшийся отрезок нового ряда и строит продолжение, не требуя отдельного training pipeline для каждого товара, датчика или рынка. Авторы называют среди возможных областей спрос, цены, энергопотребление, трафик и телеметрию, но сама архитектура не привязана к одному домену.
Релиз включает открытые веса, описание архитектуры, inference pipeline и код для воспроизведения benchmark. PatchTST-FM-r2 развивает PatchTST-FM-r1: IBM увеличила обучающую базу, добавила probabilistic forecasting и поддержку восстановления пропущенных значений. Модель содержит около 385 млн параметров, работает с контекстом длиной до 8 192 точек и использует prediction head на 99 квантилей.
Conformer соединяет дальние зависимости и локальную динамику
Главное архитектурное изменение — замена обычных transformer blocks на Conformer blocks. В каждом таком блоке multi-head self-attention отвечает за дальние связи между участками ряда, а convolution layer после attention улавливает близкую по времени структуру. Convolution находится между двумя half-step feed-forward layers; kernel sizes 3 и 5 чередуются по схеме {5, 5, 3, 3}. Идея состоит в том, чтобы не заставлять один механизм одинаково моделировать и локальные колебания, и длительные зависимости.
Исходный ряд делится на перекрывающиеся patches длиной 16 с шагом 8. При обучении IBM применяет Hamming window loss weighting, а при inference собирает перекрывающиеся прогнозы методом overlap-and-add. Число blocks выросло с 20 до 30, чтобы вместить расширенный training corpus; перед prediction head добавлен layer normalization для стабильности обучения. Hidden dimension равен 1 024.
Вероятностный прогноз важнее одной линии
Набор из 99 квантилей позволяет модели описывать не только центральную траекторию, но и распределение возможных исходов. Пользователь может запросить, например, квантили 0,1, 0,5 и 0,9 и получить диапазон вокруг медианного прогноза. Для планирования запасов или нагрузки такой результат полезнее одной точки: он даёт возможность связать решение с допустимым риском, хотя сам по себе не гарантирует, что интервалы будут хорошо откалиброваны на конкретном домене.
Официальный пример загружает модель через `PatchTSTFMForPrediction.from_pretrained` и передаёт её в `TimeSeriesForecastingPipeline`. В pipeline явно задаются timestamp column, target columns, context length, prediction length, частота и требуемые quantile levels. Пакет устанавливается командой `pip install "granite-tsfm>=0.3.9"`. Такой интерфейс делает первый тест коротким, но production-внедрение всё равно требует контроля версии данных, обработки пропусков и сопоставления forecast horizon с реальным решением.
Что именно показал GIFT-Eval
По состоянию на 8 сентября 2026 года IBM называет PatchTST-FM-r2 лучшей моделью среди воспроизводимых zero-shot решений с permissive, commercial-friendly лицензией и второй среди всех воспроизводимых zero-shot моделей в GIFT-Eval. Рейтинг учитывает агрегированные CRPS и MASE: для обеих метрик меньшее значение лучше. Когда к сравнению добавляют pretrained models, которым разрешено использовать training split тестовых наборов GIFT-Eval при pretraining, PatchTST-FM-r2 занимает третье место по CRPS и четвёртое по MASE.
Эти позиции нужно читать вместе с методикой отбора. В model card указано, что для воспроизведения zero-shot таблицы необходимо выбрать zero-shot models, исключить варианты с test leak и оставить только модели с replication code. Там же отмечено, что результаты Granite-PatchTST-FM-r2 на момент публикации находились в pending pull request к benchmark. Поэтому рейтинг — сильный публично проверяемый сигнал, но не окончательная независимая сертификация и не обещание лидерства на любом частном наборе данных.
Обучающая смесь отделена от evaluation sets
Training data собраны из четырёх компонентов. Это выбранная часть GiftEvalPretrain, синтетические последовательности по мотивам KernelSynth с другим набором периодических kernels, TSMixup dataset и CauKer dataset. Для TSMixup IBM подчёркивает, что использовались только datasets, отсутствующие в evaluation set GIFT-Eval. CauKer добавляет около 500 тысяч синтетических последовательностей длиной 4 096.
Расширение синтетических данных должно разнообразить формы, сезонности и режимы, которые модель встречает до реального применения. Однако model card не превращает это разнообразие в гарантию для редких событий, структурных разрывов или рядов с иным процессом формирования. Корректная проверка начинается с фиксированного backtest на собственных исторических окнах и сравнения с простыми baselines, а не только с другой foundation model.
Лицензию можно выбрать, поддержку — нельзя предполагать
PatchTST-FM-r2 распространяется по двойной лицензии: пользователь может выбрать Apache License 2.0 или OpenMDW License 1.0. Открыты не только weights, но и реализация новой архитектуры в IBM TSFM repository; она сохраняет обратную совместимость с checkpoints PatchTST-FM-r1. Это снижает барьер для коммерческого эксперимента и миграции между двумя версиями модели.
Одновременно IBM прямо указывает границу обязательств: код опубликован как open-source project, компания не обещает enhancements, updates или support и не делает заявлений об уровне качества и безопасности. Для production-команды это означает необходимость самостоятельно закрепить version, проверить dependency chain, измерить ресурсы inference и подготовить rollback. Открытая лицензия отвечает на вопрос о праве использования, но не заменяет эксплуатационную ответственность владельца системы.
Как проверять модель до реального решения
Практичный canary должен разделять качество прогноза и удобство внедрения. Сначала стоит зафиксировать несколько горизонтов и baselines, измерить MASE или другую доменную метрику, calibration квантилей, устойчивость к пропускам и latency. Затем — проверить стоимость CPU/GPU, объём памяти, воспроизводимость одной версии weights и поведение на рядах, которых не было в настройке эксперимента.
Особенно важно не выбирать модель только по среднему месту в benchmark. Для пополнения запасов критичны ошибки на пиках и стоимость дефицита, для энергетики — интервалы неопределённости, для телеметрии — дрейф и пропуски. PatchTST-FM-r2 даёт готовую сильную стартовую точку и воспроизводимый интерфейс, но решение о rollout должно опираться на измеренный downstream outcome. В этом и состоит ценность релиза: дорогое обучение универсального backbone уже выполнено, а локальная команда может сосредоточиться на честной проверке применимости.