Модели
«7B в генераторе и прозрачность из коробки»: Qwen открыла Qwen-Image-2.1 — одну модель для генерации и редактирования
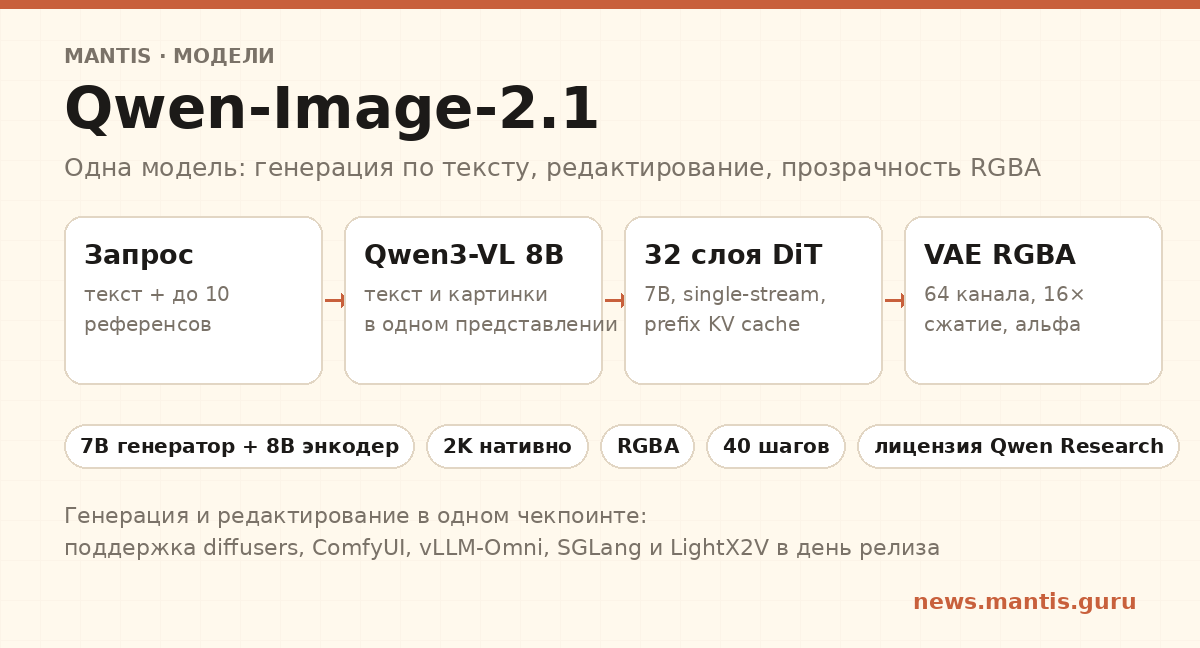
20 сентября 2026 года Qwen объявила релиз Qwen-Image-2.1: веса опубликованы в репозитории на Hugging Face и в ModelScope. Модель описана как единый конвейер для генерации изображений по тексту и для редактирования, а её генеративный компонент занимает 7B параметров при 32 слоях single-stream DiT.
Появлению объявления предшествовала публикация весов: карточка модели в репозитории Qwen на Hugging Face датирована 14 сентября 2026 года, а заметка о релизе и обновление README — 20 сентября. В тот же день рядом появились два вспомогательных чекпоинта, дообученных из Qwen3.5-VL 9B для переписывания промптов.
Одна модель вместо двух конвейеров
Основное обещание релиза — объединить в одном чекпоинте то, что обычно собирается из двух моделей: генерацию по тексту и редактирование по изображению. Qwen формулирует это как Native Transparency, Unified Creation and Editing: модель генерирует обычные и прозрачные RGBA-изображения из текста, редактирует прозрачные слои и вырезает объекты с фотографий.
Прозрачность здесь не постобработка: в репозитории указан 64-канальный RGBA-автоэнкодер с 16-кратным пространственным сжатием, который поддерживает её нативно. Для генерации с альфа-каналом карточка модели предписывает отдельный формат промпта — сначала фраза «This is an RGBA image with transparency», затем описание и уточнение, что у изображения есть альфа-канал, а фон прозрачный.
До десяти референсов и локальные правки
Карточка модели заявляет поддержку до 10 референсных изображений в одном запросе. Локальные правки задаются кругами, рукописными пометками или отдельными масками, при этом заявлено сохранение идентичности людей и предметов.
README приводит конкретные примеры: групповой снимок, собранный из шести портретов, комплект одежды из пяти референсов — модель, одежда, обувь, сумка, шляпа, а также многорегиональное редактирование по кругам, где за один проход нужно убрать часы, изменить цвет волос и заменить одежду.
Как устроена модель
Трансформер — 32 слоя и 7B параметров, single-stream, с блочно-каузальной маской внимания вида (q_idx >= kv_idx) or same_image_block: текст использует токен-каузальную маску, изображения — чанковую двунаправленную. Текстовым энкодером служит Qwen3-VL 8B, который кодирует и инструкцию, и условные изображения в единое представление.
Планировщик — Flow Matching с дискретным расписанием Euler и динамическим сдвигом. Отдельно в README описан префиксный KV-кэш: трансформер автоматически кэширует префикс текста и условных изображений между шагами диффузии, когда в чекпоинте стоит causal_condition: true (значение по умолчанию), и тогда контекст условия кодируется один раз и переиспользуется на всех шагах.
Это заметно ускоряет редактирование с несколькими условными изображениями. Для экономии видеопамяти предусмотрен enable_model_cpu_offload() — выгрузка частей пайплайна на CPU.
2K, пропорции и сорок шагов
Модель нативно поддерживает 2K-разрешение. Таблица рекомендуемых размеров покрывает семь пропорций — от 1:1 (2048×2048) до 16:9 (2752×1536) и 9:16 (1536×2752), а в примерах используется 40 шагов диффузии.
Полный набор весов в bfloat16 занимает около 33 ГБ: четыре шарда текстового энкодера, два шарда трансформера и VAE объёмом 1,35 ГБ.
Поддержка с первого дня
День релиза отмечен в README записями об интеграциях. Diffusers получил пайплайн QwenImage21Pipeline (PR #14804), а ComfyUI поддерживает модель нативно — совместимые веса опубликованы отдельным репозиторием Comfy-Org/Qwen-Image-2.1 вместе с примерами workflow для генерации и редактирования.
vLLM-Omni ускоряет инференс переиспользованием префиксного KV-кэша между шагами и выделенными CUDA Graph, добавляя FP8-квантование и тензорный параллелизм. SGLang заявляет нативную поддержку с префиксным кэшированием, Cache-DiT, CUDA-графами и параллелизмом TP/Ulysses/Ring/CFG (PR #39983), а LightX2V добавил ускорение в день релиза. ModelScope поддерживает модель через открытый DiffSynth-Studio, включая скачивание весов, генерацию онлайн и обучение LoRA.
К этому приложены аппаратные истории: запуск на AMD Radeon через ROCm, PyTorch и Diffusers, а также поддержка гетерогенных чипов через FlagOS — предсобранные образы и веса для восьми платформ опубликованы под FlagRelease.
Что это значит
Практический вывод для того, кто выбирает модель под продукт, — не в одном числе, а в связке: 7B в генеративном компоненте и 8B в текстовом энкодере означают около 15B параметров на проход, а прозрачность, десять референсов и правки по маске снимают отдельные шаги предобработки, которые обычно закрывают сторонние инструменты.
Нативная прозрачность показательна сама по себе: она превращает альфа-канал из результата постобработки в свойство модели, а значит снимает вопрос о качестве краёв вырезанного объекта. Но лицензия не свободная — модель распространяется по Qwen Research License Agreement, и это стоит проверять до коммерческого запуска.