Модели
«Правильно в 90,7 % случаев против 83,9 % у Jev»: FrontiersMind выпустила открытую Lumma-Fev-27B на базе Qwen3.8-27B
14 октября 2026 года FrontiersMind опубликовала Lumma-Fev-27B — модель принятия решений на 27 млрд параметров с открытыми весами под Apache-2.0, обученную поверх Qwen3.8-27B без LoRA и замороженных слоёв на примерно 100 тыс. примеров за один проход. На удержанном наборе из 4 454 решений модель права в 90,7 % случаев против 83,9 % у TypeSafe Jev 1.13, ошибка калибровки ECE — 0,009 против 0,045, а на одном forward pass модель возвращает распределение вероятностей по вариантам, которое можно использовать как порог. На бенчмарках рассуждений BBH и WinoGrande Jev по-прежнему впереди, тип вопросов score в этой версии не обучался, а веса весом около 49 ГиБ в bfloat16 требуют одного GPU на 80 ГБ.
Что выпустила FrontiersMind
14 октября 2026 года организация FrontiersMind опубликовала на Hugging Face пост «Introducing Lumma-Fev-27B» и вместе с ним открытые веса модели под лицензией Apache-2.0 в репозитории FrontiersMind/Lumma-fev-27B. Пост подписан пятью авторами организации и помечен на Hugging Face как Community Article — это публикация самой FrontiersMind, а не внутренний материал платформы. Сама организация на Hugging Face отмечена как verified company со ссылкой на собственный сайт frontiersmind.ai.
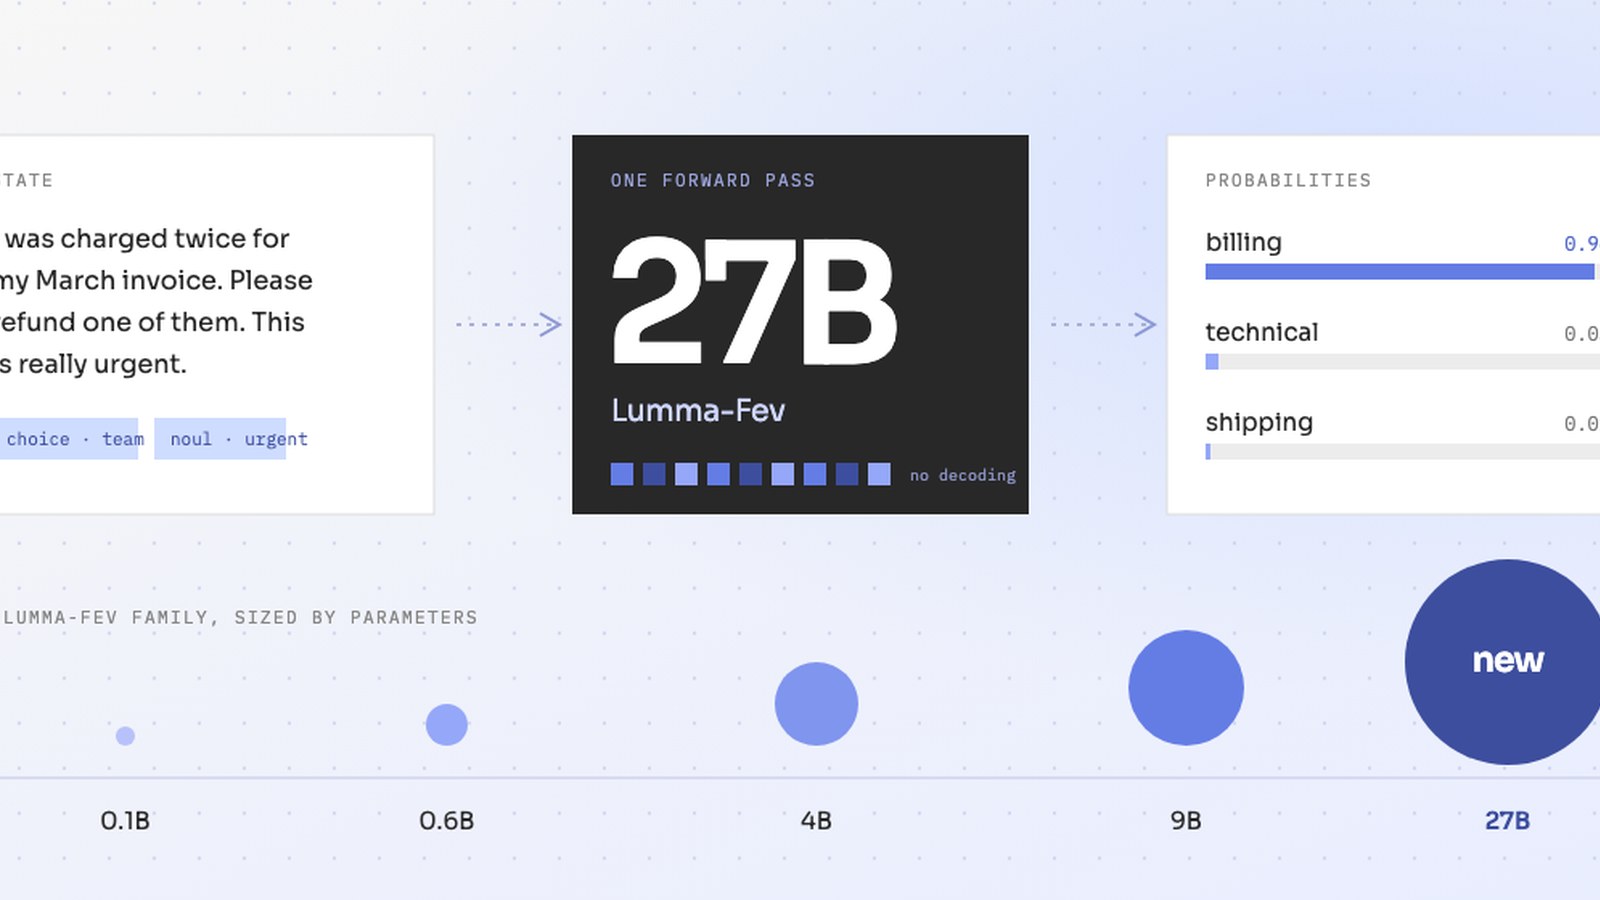
Lumma-Fev-27B — самая большая модель в семействе Lumma-Fev, выпущенном в сентябре 2026 года: тогда семейство занимало диапазон от 154 млн до 9 млрд параметров, а все модели решали одну задачу — оценивали предложенные варианты за один проход, а не генерировали метку, которую потом нужно разбирать.
Название модели говорит о 27 млрд параметров, и в тексте поста указаны именно 27 миллиардов. Карточка модели на Hugging Face при этом перечисляет размер как 26B параметров в формате BF16 — расхождение между названием и машинной карточкой редакция не сглаживает и приводит оба значения как они опубликованы.
База модели — Qwen3.8-27B: по описанию авторов, обучались все веса сразу, без LoRA и без замороженных слоёв, на примерно 100 тыс. примеров решений. Языки — английский и три индийских: хинди, тамильский и каннада.
Один forward pass и тот же контракт /v1/systemone
Интерфейс модели не изменился по сравнению с остальными размерами семейства: на вход подаётся состояние (state) и словарь вопросов, на выходе для каждого вопроса — выбор с картой вероятностей по заданным вариантам либо вероятность «да» для шлюза noul. Контракт тот же, что у TypeSafe Jev — /v1/systemone, — поэтому существующие клиенты, по словам авторов, переходят на новую модель сменой базового URL.
Типов вопросов три: noul отвечает да или нет вероятностью, choice выбирает одну метку из списка до 255 вариантов, score расставляет уровни по порядку. Интерфейс принимает все три, но обучение и оценка этой версии шли только на noul и choice, поэтому ответы score авторы называют непроверенными до самостоятельной проверки на своих данных.
Состояние может быть текстом, объектом JSON или массивом, и каждый вопрос читает состояние и собственные варианты, не влияя на остальные ответы. В примере из поста состояние «My integration keeps failing. Please help.» с вопросом о том, какая команда должна разбирать обращение, даёт choice support с уверенностью 0,9993 и распределением 0,9996 против 0,0002 у billing и sales, а вопрос noul о срочности возвращает вероятность 0,1058.
Замеры против Jev: 90,7 % против 83,9 %
Это первая модель семейства Fev, которую FrontiersMind сравнивает напрямую с TypeSafe Jev на задачах, ради которых семейство создавалось, и авторы отдельно оговаривают, что показывают и проигрыши тоже. Обе модели — Lumma-Fev-27B и TypeSafe Jev версии 1.13 через хостед-API — прогонялись на одних и тех же строках двумя способами: на удержанном наборе решений, похожих на обучающие, и на восьми открытых бенчмарках; все числа, если не указано иное, — обычная точность, замеры сделаны в октябре 2026 года.
Главный результат: на удержанном наборе из 4 454 решений Lumma-Fev-27B права в 90,7 % случаев против 83,9 % у Jev, то есть плюс 6,9 процентного пункта на тех же строках, и это девять исходных задач. Ошибка калибровки ECE на том же наборе — 0,009 против 0,045, меньше — лучше.
Набор собран из девяти открытых задач: понимание прочитанного, перефразирование, вывод следствий, токсичность, определение намерения и других; обучающие и тестовые строки взяты из разных семейств источников, чтобы один и тот же исходный пример не оказался по обе стороны.
На бенчмарках рассуждений, таких как BBH и WinoGrande, впереди остаётся Jev — об этом авторы пишут прямо, без попытки представить сравнение односторонним.
Для индийских языков публичного бенчмарка принятия решений не существует, поэтому хинди, тамильский и каннада авторы измерили на внутреннем бенчмарке, который собрали сами.
Калибровка: уверенность, которую можно читать
Ключевая мысль поста: модель решений полезна для автоматизации только тогда, когда её уверенность что-то значит. На удержанном наборе ошибка калибровки Lumma-Fev-27B составляет 0,009 против 0,045 у Jev, то есть когда модель говорит «90 %», она права примерно в 90 % случаев.
Подобранная температура — 0,94, поэтому сырые оценки почти не нуждаются в пересчёте. Каждая точка на графике калибровки — интервал уверенности минимум из 20 тестовых строк, размер точки растёт с числом строк, а пунктирная линия означает идеальную калибровку.
Здесь же авторы ставят границу применимости: калибровка измерена на их собственном тестовом распределении, поэтому пороги для автоматического действия нужно подбирать на размеченных данных своего трафика.
Как обучали
Обучение шло на примерно 100 тыс. примеров за один проход по данным и охватывало английский, хинди, тамильский и каннада. База — Qwen3.8-27B, обучались все веса со свежим оптимизатором, а языковую голову заменила небольшая голова чтения поверх вариантов ответа.
Рецепт авторы описывают как короткий одноразовый fine-tune, вдохновлённый AutoJev. Вычисления — четыре GPU H200 примерно на 3,2 часа, то есть около 13 GPU-часов, причём веса были разложены по видеокартам.
Выбор чекпойнта тоже описан: каждые 50 обновлений авторы оценивали отложенный набор против Jev и сохраняли лучший чекпойнт, калибровка которого отличалась от калибровки Jev не более чем на 0,01 — и этим чекпойнтом оказался последний.
Веса занимают около 49 ГиБ в bfloat16, поэтому нужен один GPU на 80 ГБ; вызовы модели не отличаются от остальных размеров Lumma-Fev. Пост приводит и код: пакет ставится через pip install -U lumma-fev, модель загружается как lumma_fev.load("FrontiersMind/Lumma-fev-27B"), а серверная версия поднимается командой lumma-fev-serve и отвечает по тому же адресу /v1/systemone.
Что модель не решает
Первое ограничение названо самими авторами: тип score не входил в обучение, его ответы они считают непроверенными, пока пользователь не проверит их на своих данных.
Второе — языки: модель работает на английском и трёх индийских языках, и качество на индийских языках измерено на внутреннем бенчмарке авторов, потому что публичного нет.
Третье — калибровка и пороги: числа относятся к тестовому распределению FrontiersMind, и переносить порог на чужой трафик без переобучения на размеченных данных того же трафика авторы не советуют.
Четвёртое — сравнение: все приведённые в посте цифры получены самой FrontiersMind на Jev версии 1.13 через хостед-API, то есть это замеры автора модели о своей модели против чужой, без независимой перепроверки. О превосходстве над другими открытыми моделями по бенчмаркам решений в посте речи нет — сравнение построено вокруг Jev и восьми открытых бенчмарков.
Как это читать
Lumma-Fev-27B — не языковая модель общего назначения, а модель принятия решений: она не пишет текст, а возвращает распределение по вариантам, которое превращается в выбор или шлюз через порог. Метрика, которую авторы считают главной, относится именно к этому режиму работы — расхождение ответов и их калибровка на типизированных вопросах.
Карточка модели на Hugging Face подтверждает рамки релиза: лицензия apache-2.0, теги qwen3_5 и decision-model, базовая модель Qwen/Qwen3.8-27B, тип пайплайна text-classification, размер 26B параметров и тип тензоров BF16.
В качестве следующего шага авторы называют более широкую смесь для обучения с публичными наборами задач, включая решения вида рассуждений и знаний, и более крупный прогон на большем числе GPU.