Модели
«Только три системы перешагнули 0,70»: тринадцать верификаторов ответов LLM впервые сравнили на одном тест-сете
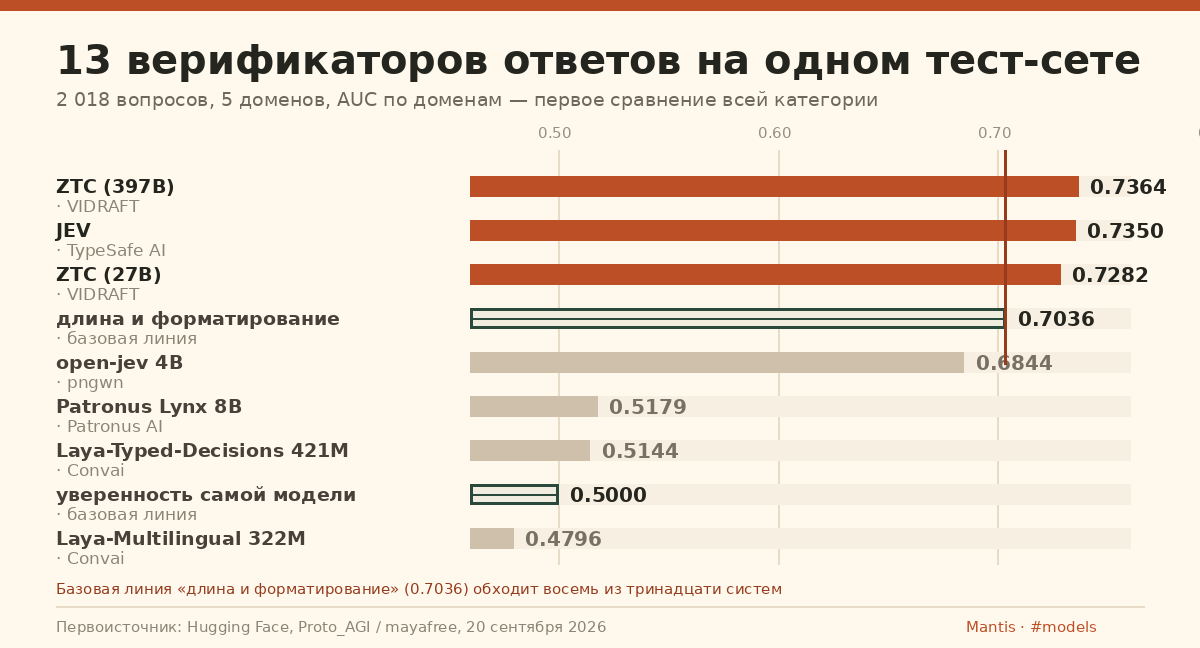
20 сентября 2026 года на Hugging Face опубликовано исследование Proto_AGI (mayafree) «Inside the JEV Ecosystem: 13 Answer Verifiers on One Test Set»: тринадцать систем проверки ответов LLM измерены на одном наборе из 2 018 вопросов с одинаковыми метками по метрике AUC с агрегацией по доменам, а код оценки выложен публично. Разрыв между первым и вторым местом составил 0,0014 AUC при интервале от −0,019 до +0,032, тогда как базовая линия, смотрящая только на длину и форматирование ответа, дала 0,7036 и обошла восемь из тринадцати систем.
20 сентября 2026 года на Hugging Face опубликовано исследование Proto_AGI (mayafree) «Inside the JEV Ecosystem: 13 Answer Verifiers on One Test Set» — попытка измерить целую категорию систем проверки ответов на одном тест-сете с одинаковыми метками: тринадцать систем прогнаны по 2 018 вопросам, код оценки опубликован.
Мотив авторы формулируют прямо: каждый поставщик систем проверки ответов публикует собственный бенчмарк, и в каждом из них побеждает он сам. Одного набора, на котором были бы прогнаны все, до сих пор не существовало.
Что такое typed decision model
Typed decision model возвращает не свободный текст, а структурированный вердикт — булево значение, выбор или порядковую оценку. Такая модель выполняет один прямой проход и не генерирует ни одного токена, и именно это делает её на один–три порядка дешевле и быстрее, чем вопрос к frontier-модели.
Категорию основала модель Jev компании TypeSafe AI под названием System One models, и вокруг неё сложилась небольшая экосистема: открытые воспроизведения, архитектурно совместимые альтернативы вроде Laya от Convai, а также смежные инструменты Patronus Lynx и Vectara HHEM.
Что именно измеряли
Задача — по вопросу и ответу, написанному какой-то моделью, оценить, верен ли ответ. Набор: 2 018 элементов, из них 508 неверных, 5 доменов, ответы четырёх разных моделей.
Метрика — AUC: насколько хорошо неверные ответы сортируются вниз; порога у неё нет, а 0,5 означает бросок монеты. Ось измерения — фактическая проверка без предоставленного документа-основания.
Агрегация идёт сначала по доменам и лишь затем взвешивается по размеру. Это принципиально: если свести все 2 018 элементов в один AUC, числа систематически выше, потому что шкалы оценок в разных доменах различаются и объединение поощряет именно это различие, а не способность отделять верное от неверного. На собственной системе авторов объединённая цифра равна 0,80, тогда как среднее по доменам — 0,73, и в таблице приводится меньшая, воспроизводимая.
Неопределённость оценивается парным bootstrap с 3 000 пересэмплирований; если интервал содержит ноль, место не присваивается вовсе. В таблице стоят и две референсные строки: логистическая модель по десяти поверхностным признакам ответа — длина, число цифр, форматирование — и заявленная уверенность самой отвечавшей модели.
Верх таблицы — это ничья
Первую строку занимает ZTC (397B) от VIDRAFT, вторую — JEV от TypeSafe AI, третью — ZTC (27B). Разрыв между первым и вторым местом — 0,0014 AUC, а 95-процентный интервал на этот разрыв идёт от −0,019 до +0,032. По собственному правилу таблицы интервал, содержащий ноль, ранга не даёт, поэтому первое и второе места неразличимы — и это сказано над таблицей, а не в сноске.
Ниже базовой линии идут open-jev 4B (0,6844), Patronus Lynx 8B (0,5179) и Laya-Typed-Decisions 421M (0,5144), а под строкой уверенности самой модели оказалась Laya-Multilingual 322M (0,4796).
Отдельной строкой вынесены ответы, полученные прямым вопросом к LLM: они генерируют токены и потому стоят вне оси ранжирования — GPT-5.2 0,7148, Qwen3-Next-80B 0,6366, GPT-4o-mini 0,5878, Gemini 2.5 Flash-Lite 0,5822. Ещё одна система, Vectara HHEM-2.1 (0,4852), решает другую задачу — следует ли ответ из предоставленного документа, — а в этом наборе документ не даётся.
Поверхностная базовая линия — реальная планка
Первый из четырёх выводов, которые авторы считают выжившими после проверки погрешностями, — про базовую линию: одна только длина ответа и его форматирование дают 0,7036, и восемь из тринадцати измеренных систем оказываются ниже. Верификатор под этой чертой определяет не правильность, а форму.
Отсюда прямой вывод авторов: любой лидерборд в этой категории, в котором такой базовой линии нет, льстит своим участникам.
Больше параметров — не значит лучше
Внутри одного семейства модель на 397B обходит модель на 27B в целом, но на научных рассуждениях порядок разворачивается резко: 27B — 0,7410, 397B — 0,6287. Модель в четырнадцать раз крупнее получает на 0,11 меньше.
Это согласуется с отдельным наблюдением: модель класса 180B набрала 0,7146 — ниже, чем 4B с результатом 0,7284. Формулировка авторов: качество проверки следует за геометрией представлений, а не за числом параметров.
«Просто спросить frontier-модель» — дорого и середина таблицы
GPT-5.2 добирается до 0,7148 — ниже обеих конфигураций ZTC и ниже JEV, — при этом генерирует токены и стоит примерно $0,55 за 1 000 вызовов против $0,024 у JEV.
Меньшие судьи падают ещё ниже: GPT-4o-mini — 0,5878, Gemini 2.5 Flash-Lite — 0,5822.
Открытая альтернатива: скорость подтвердилась, точность — нет
Laya — архитектурно ближайший открытый аналог Jev: неавторегрессионная, без генерации токенов, Apache-2.0, около 0,015 с на вызов, что примерно в 140 раз быстрее измеренного хостед-API. Заявка на скорость подтверждается.
С точностью на этом наборе — нет: 0,4796 и 0,5144 против опубликованного заявления о победе над Jev на собственном англоязычном typed-decision бенчмарке поставщика. Оба числа могут быть верны, потому что это разные тесты, — и именно это и есть аргумент в пользу общего набора.
AUC — не то число, по которому разворачивают систему
Рейтинг отвечает на вопрос, какая система лучше отделяет верные ответы от неверных, но не на вопрос, какая система помогает агенту. Второй вопрос авторы измерили отдельно: каждый ответ оценивается верификатором, нижние k % уходят на переответ более сильной модели, остальное остаётся как есть. Все ветви берут переответы из одного общего пула, чтобы ни одна не получала более удачные повторы, а ничьи разыгрываются случайно и усредняются по 200 зёрнам.
При бюджете 20 % и базовой точности без гейта 74,83 %: ZTC — 76,16 % (+1,34 п.п.), JEV — 74,76 % (−0,07 п.п.), случайный отбор — 74,58 % (−0,25 п.п.). Две системы различаются на 0,0014 AUC и на 1,4 процентного пункта сквозной точности агента.
Механизм объясняет расхождение: переответ — палка о двух концах, неверные ответы, отправленные назад, исправляются в 38 % случаев, а верные — ломаются в 30 %. Значит, ценность гейта определяется точностью, а не полнотой: при бюджете 20 % JEV отправил на переответ 403 элемента, из которых 216 уже были верными, а ZTC — 403, из которых верными были 195. JEV починил примерно столько же, сколько сломал, и эта асимметрия в колонке AUC не видна.
Авторы оговаривают объём измерения: одна цель эскалации и один набор элементов, результат приводится как механизм, а не как универсальная константа.
Что опубликовано, а что нет
Полностью опубликованы все оценки, все метки и код оценки. Исходные элементы не распространяются: они взяты из корпусов, лицензии которых запрещают распространение или изменение либо требуют доступа, а также из выходов коммерческих моделей, условия которых явно не разрешают повторную публикацию; код оценки выложен, чтобы тот же протокол можно было прогнать на любом закрытом наборе.
Четыре опубликованных воспроизведения не запустились из своих артефактов — отсутствующая классифицирующая голова, неподдерживаемые архитектуры, неполный токенизатор — и каждое присутствует в таблице вместе с ошибкой и ссылкой, потому что реальное состояние категории включает и то, что не работает.
Ещё одна запись помечена как pending: её повторное измерение разошлось с прежним значением на величину, которую стенд воспроизведения пока не может объяснить. Она сохраняет прежнее число с пометкой до тех пор, пока стенд не совпадёт с реализацией вышестоящего проекта: снижать оценку конкурента на основании собственного недоверенного кода авторы коррекцией не считают.
Что это значит
Таблица сообщает по каждой записи доступность API, доступность локальных весов, возможность дообучения на данных заказчика, число генерируемых токенов, стоимость за 1 000 вызовов и AUC по доменам. Чтобы добавить систему, нужно открыть обсуждение на Space со ссылкой и запускаемым сниппетом оценки, а записи, которые нельзя исполнить из опубликованных артефактов, попадают в раздел did not run, а не исчезают из таблицы.
Практический итог для того, кто выбирает верификатор: сравнивать системы имеет смысл только на общем наборе и только с поверхностной базовой линией, а решение о развёртывании принимать по сквозной точности агента, где цена пропущенной и цена исправленной ошибки считаются отдельно.