Модели
«Одна семья моделей, два золотых результата»: NVIDIA донастроила Nemotron под золото IOI и IMO
7 октября 2026 года NVIDIA в своём блоге на Hugging Face описала, как из одной базовой семьи Nemotron получились две специализированные системы: одна набрала 535,4 из 600 на IOI 2026 — выше золотого порога 361,12 и выше лучшего результата человека 498,27, — а вторая взяла 30 из 42 на IMO 2026 при официальном золотом пороге 29. Результат по информатике получен в живом проспективном прогоне под теми же ограничениями по времени, доступу в сеть и посылкам, что у людей-участников, и это неофициальный бенчмарк без надзора, не вошедший в официальный зачёт IOI; доказательства IMO оценивали официальные проверяющие олимпиады.
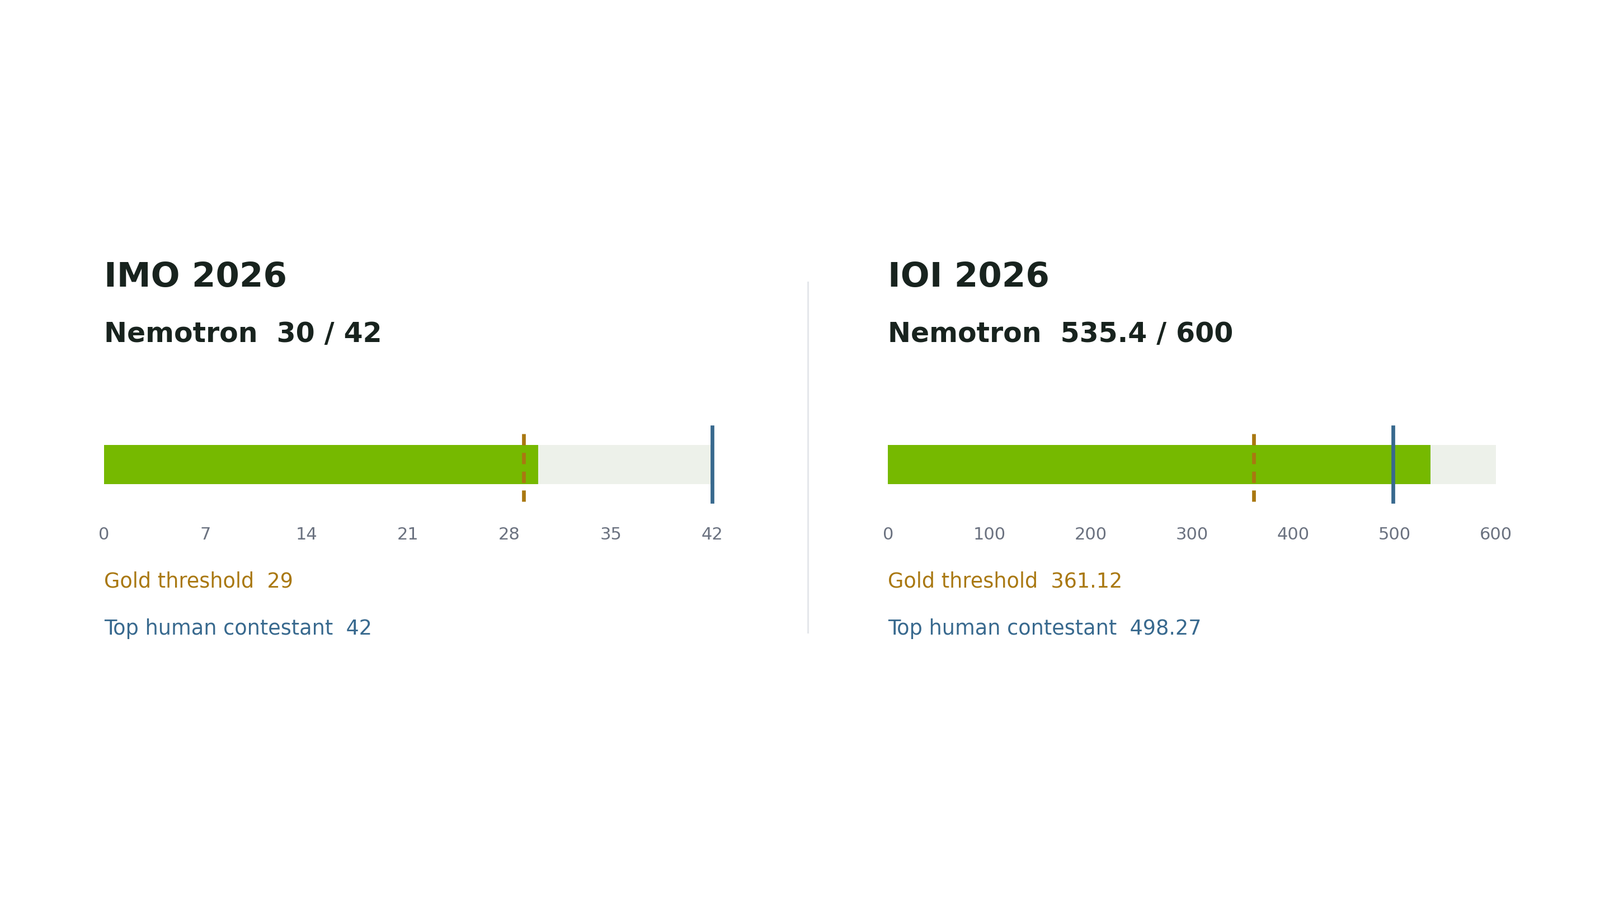
Что показала NVIDIA
Международная олимпиада по информатике (IOI) и Международная математическая олимпиада (IMO) проверяют разные навыки: IOI требует алгоритмов и кода, проходящего скрытые тесты в жёстких лимитах по времени и числу посылок, а IMO — строгих доказательств на естественном языке. Успех сразу на обоих соревнованиях, по формулировке авторов, указывает на нечто более широкое.
NVIDIA сообщила, что её команды, отталкиваясь от Nemotron 3, применили обучение с учителем (SFT), обучение с подкреплением (RL) и инференс с обратной связью и получили системы золотого уровня на обоих соревнованиях 2026 года. Материал подписали пятеро авторов NVIDIA: Aleksander (aficek), Igor Gitman, Sean Narenthiran, Mehrzad Samadi и Somshubra Majumdar.
Конкретика такая: Nemotron-3-Ultra-CC с SFT и стратегией GenCorrect набрал на IOI 2026 535,4 из 600 — выше золотого порога 361,12 и выше лучшего человеческого результата 498,27; система на базе Nemotron 3 Ultra с общей моделью, SFT- и RL-чекпойнтами в схеме «сгенерировать — проверить — уточнить» набрала на IMO 2026 30 из 42 при официальном золотом пороге 29.
Оговорки тоже приведены самими авторами: IOI-прогон был живым и проспективным, под теми же ограничениями по времени, доступу в интернет и посылкам, что у людей, но это неофициальный бенчмарк без надзора, не включённый в официальный рейтинг IOI, а доказательства IMO проверяли официальные проверяющие олимпиады.
Рецепт специализации
По формулировке NVIDIA, «легко дообучать» должно означать не просто обучаемый чекпойнт, а способность адаптировать сильную базовую модель к требовательному домену по ясному воспроизводимому рецепту.
Рецепт состоит из четырёх частей: взять сильную базовую модель Nemotron; отобрать доменные задачи и качественные трассы рассуждений; применить стандартные методы пост-обучения — SFT и, где полезно, RL; соединить специалиста с инференс-циклом, который генерирует, оценивает и улучшает варианты ответа.
Обучение и инференс были объёмными, но сам подход, как подчёркивают авторы, знаком и воспроизводим: новую базовую модель под каждую задачу строить не пришлось.
От общей способности к коду до золота IOI
Для спортивного программирования NVIDIA отобрала 22 000 задач и сгенерировала синтетические трассы рассуждений, обучив двух специалистов: Nemotron-3-Nano-CC с 30 млрд общих и 3 млрд активных параметров прошёл и SFT, и RL, а Nemotron-3-Ultra-CC с 550 млрд общих и 55 млрд активных параметров — только SFT.
Прогресс на IOI 2025 показывает ценность специализации: Nano выросла со 130 баллов до 280 после SFT и 291 после RL, а со стратегией GenCorrect — итеративным циклом «сгенерировать — оценить — уточнить» — дошла до 468 и перешагнула золотой порог 438,3; Ultra-CC с той же инференс-стратегией набрала 502.
Адаптация при этом выглядит по-разному на разных масштабах: у Nano основную прибавку дал SFT, RL добавил меньше, но устойчиво; для более сильной Ultra хватило одной эпохи SFT, чтобы обойти полностью пост-обученную Nano на IOI, ICPC и LiveCodeBench Pro — именно этот вывод определил конфигурацию Ultra-CC для IOI 2026 с результатом 535,4 из 600.
Математика: доказывать, проверять, уточнять
Проект IMO применил ту же идею к олимпиадной математике: от Nemotron 3 Ultra обучили одного специалиста с SFT и другого с RL.
Корпус SFT — 414 890 качественно отфильтрованных примеров по 15 818 уникальным задачам на доказательство; данные покрывали генерацию доказательств, их уточнение, проверку и метапроверку, чтобы модель училась строить аргументы, находить пробелы, отвечать на критику и судить о полноте доказательства; RL-модель обучалась на 9 597 задачах, подобранных у границы возможностей модели.
Оба пост-обученных чекпойнта обошли общедоступную модель в разработческих экспериментах: SFT-чекпойнт был сильнее в первом раунде поиска, а RL-чекпойнт дал лучший результат как отдельный чекпойнт; их сильные стороны дополняли друг друга, поэтому финальная система использовала обоих специалистов вместе с общей моделью.
На каждую задачу IMO модели генерировали варианты доказательств, оценивали их, выдавали критику и уточняли самые перспективные попытки, а отдельная высокоресурсная стадия выбирала финальную посылку; система работала целиком на естественном языке, без формального доказателя, внешних инструментов и доступа в интернет — и набрала 30 из 42, включая полный балл по четырём из шести задач.
Донастройка и вычисления на инференсе — вместе
Более ранний пост NVIDIA про IOI 2025 показывал, как вычисления на этапе инференса вытягивают открытые модели до золотого уровня; новые результаты добавляют к этому важную часть — лучшая специализация даёт системе инференса лучших кандидатов, лучших критиков и лучшие уточнения.
На IOI стратегия GenCorrect превращала выигрыш от донастройки в более крупные улучшения за несколько раундов обратной связи, а на IMO использование дополняющих друг друга SFT- и RL-чекпойнтов оказалось полезнее, чем простое увеличение числа выборок из одного чекпойнта.
Вывод, который авторы подчёркивают отдельно: медали дал не только fine-tuning и не только перебор выборок, а совместное проектирование модели, данных и инференс-цикла.
Открытые модели, данные и рецепты
Коллекция Nemotron Labs IMO 2026 собирает SFT- и RL-чекпойнты, оба тренировочных набора данных и Nemotron-IMO-Bench — новый бенчмарк из 200 олимпиадных задач; статья про IMO описывает подход к обучению и систему generate-verify-refine, а репозиторий NeMo-Skills содержит инференс-конвейер IMO, промпты, отправленные доказательства и воспроизводимый quickstart.
Для спортивного программирования на Hugging Face доступна модель Nemotron-3-Ultra-CC, статья про IOI приводит рецепт обучения и методологию GenCorrect, а конвейер оценки и инференса IOI также лежит в NeMo-Skills.
Карточка модели в публикации указана как nvidia/NVIDIA-Nemotron-Labs-3-Competitive-Coding-550B-A55B-NVFP4 — генерация текста, 335B, обновлена 20 дней назад.
Рамка
Это сообщение NVIDIA о собственных результатах: числа самозаявленные, независимой проверки в публикации не приводится, а IOI-прогон, по признанию самих авторов, был неофициальным и в официальный зачёт не вошёл.
Доказательства IMO при этом оценивали официальные проверяющие олимпиады, а сами результаты получены на чекпойнтах Nemotron и опубликованных рецептах — то есть воспроизводимость здесь зависит от доступа к этим артефактам.