Модели
«Вердикт за один проход и ноль сгенерированных токенов»: FINAL_Bench выпустила судью Darwin-27B-ZTC с измеримой калибровкой
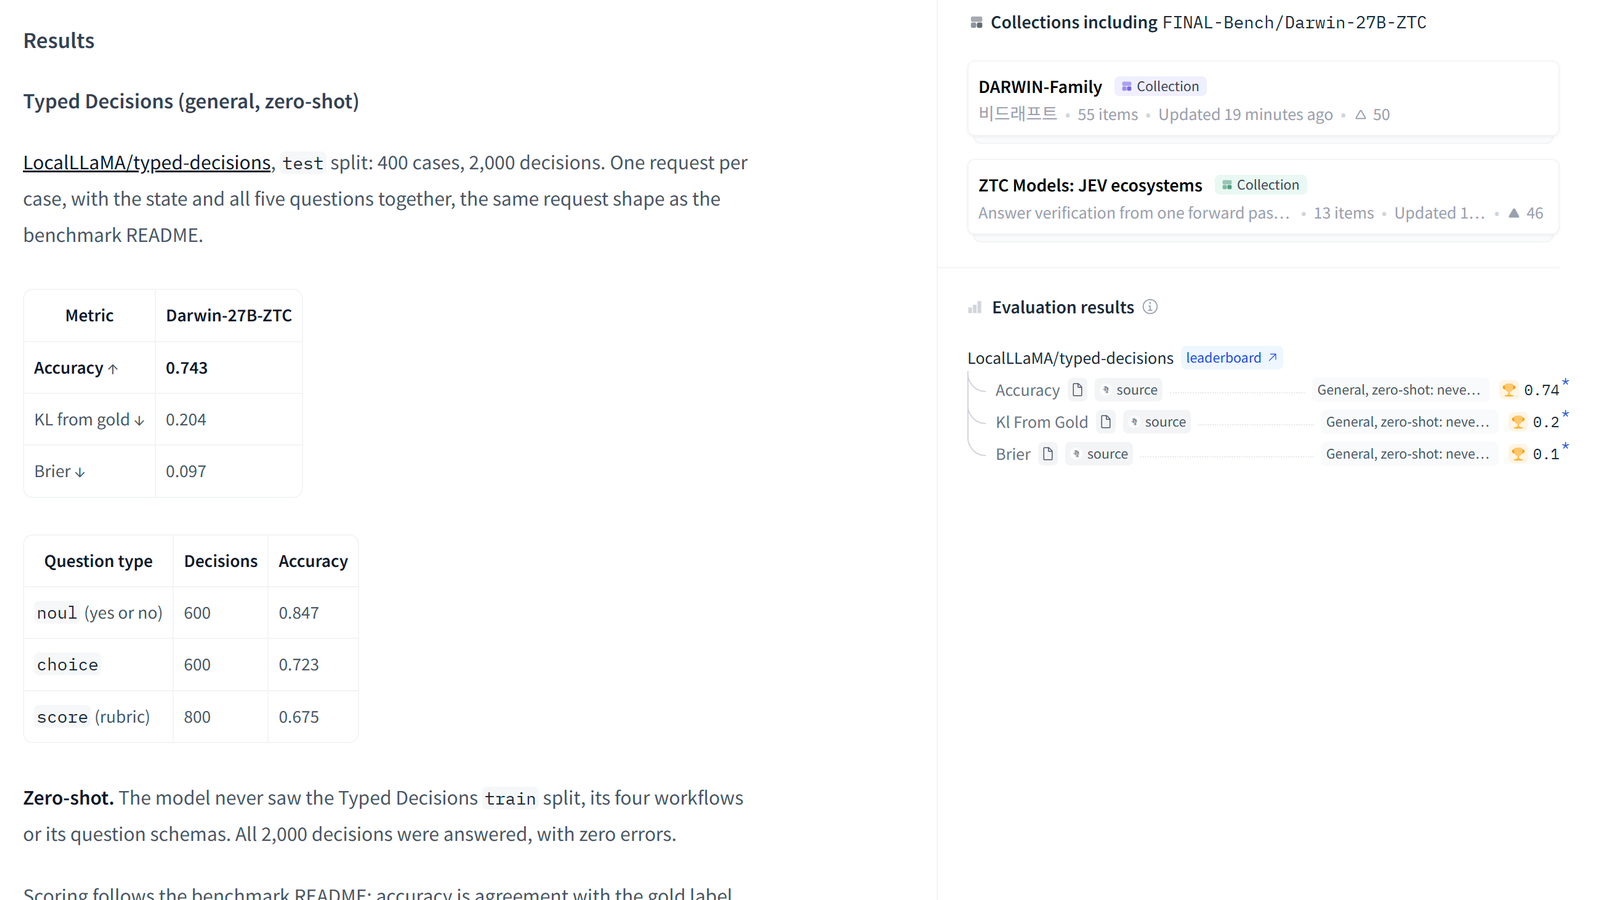
FINAL_Bench описала Darwin-27B-ZTC — судью, который вместо генерации текста возвращает распределение вероятностей по вариантам ответа за один прямой проход: ноль сгенерированных токенов, детерминированный результат и калибровка, измеряемая строгими правилами подсчёта очков. В зеро-шот-прогоне на бенчмарке typed-decisions модель набрала 0.743 точности при KL 0.204 и Brier 0.097 и вышла на первое место в официальной таблице.
Что произошло
В блоге Hugging Face компания FINAL_Bench опубликовала разбор Darwin-27B-ZTC — «судьи» (judge), который оценивает ответы не генерацией, а оценкой условной вероятности: модель возвращает категориальное распределение по каждому типизированному вопросу за один прямой проход, без цикла декодирования и без сгенерированных токенов.
Публикация от 8 октября 2026 года сопровождает модель FINAL-Bench/Darwin-27B-ZTC и таблицу typed-decisions на Hugging Face; в тексте разобраны постановка задачи, метрики и ограничения.
Две структурные проблемы судей на генеративных моделях
Использовать языковую модель как судью стало обычной практикой — оценка ответов, сравнение предпочтений, маршрутизация, фильтрация по безопасности, — но генеративный судья приносит с собой два долга.
Первый — задержка: генерация это O(L) последовательного декодирования по длине выхода L. Каждое суждение выдаёт десятки и сотни токенов, каждый зависит от предыдущего, поэтому параллелизм ограничен, а в конвейере на миллионы элементов стоимость растёт линейно.
Второй — калибровка: судье нужна не только оценка, но и уверенность в ней, а из генеративной модели её достают либо чтением logprob, либо многократной выборкой. Первый путь расходится с истинной апостериорной вероятностью, второй раздувает дисперсию и стоимость разом, и ни один не гарантирует, что заявленная уверенность совпадёт с реальной вероятностью правильного ответа.
Как устроен ZTC
Darwin-27B-ZTC обходит оба долга, меняя постановку: судейство переформулировано как оценка условной вероятности, а не генерация, и результатом становится элемент симплекса вероятностей по пространству ответов, полученный за один прямой проход.
Из этого следуют три свойства. Детерминизм: шага сэмплирования нет, дисперсия выхода равна нулю, и один и тот же вход всегда даёт одно распределение — поэтому метрики это точные значения, а не оценки по выборке, и доверительный интервал для воспроизведения не нужен.
Вычислительная стоимость: одно суждение — один прямой проход, и задержка не зависит от длины выхода, что на масштабе партии даёт структурный, а не постоянный выигрыш.
Устранение мешающих факторов: temperature, top-p, штраф за повторы и максимальная длина выпадают из оценки, поэтому сравнение моделей между собой честнее — различия в настройках больше не искажают числа.
Результаты на typed-decisions
Бенчмарк typed-decisions проверяет, справляется ли один судья с разнородными типами ответов: noul — корректность свободного ответа, choice — выбор правильного варианта из кандидатов, score — присвоение непрерывной или порядковой оценки. У всех трёх разные границы решения, и единое представление суждения как раз и есть цель.
В чистом зеро-шот-прогоне, где обучающая часть бенчмарка не использовалась, общая точность составила 0.743 на general-сплите при 2 000 суждений и нуле ошибок; по типам — noul 0.847, choice 0.723, score 0.675, а калибровка — KL 0.204 и Brier 0.097.
Разброс по типам авторы считают содержательным: лучшее значение у noul и худшее у score совпадает с интуицией, что порядковое суждение сложнее категориального, — именно поэтому результаты даны по типам, а не одной сводной цифрой.
Калибровка: Brier и KL
Когда судья стоит перед маршрутизатором или предохранителем безопасности, критерий меняется с точности на калибровку: типичная схема — «если уверенность выше порога τ, принять автоматически, иначе отдать большей модели или человеку», и в такой схеме избыточная уверенность фатальна, потому что высокая уверенность на неверном ответе проходит через шлюз.
Brier для вектора предсказанных вероятностей и one-hot исхода — это средняя квадратичная ошибка, и это строго правильное правило подсчёта очков: единственная стратегия, оптимизирующая ожидаемую оценку, — сообщать истинную вероятность, поэтому завышать или занижать уверенность невыгодно. Значение 0.097 означает, что предсказанные вероятности в среднем недалеко уходят от исходов.
Расхождение Кульбака — Лейблера между предсказанным распределением и эмпирическим распределением исходов тем меньше, чем ближе распределения: 0.204 означает, что предсказание близко к распределению исходов.
Точность и калибровка, подчёркивают авторы, — независимые оси: модель может быть точной, но самоуверенной, или неточной, но хорошо откалиброванной, а операционно важно получить обе одновременно. Результат 0.743 при KL 0.204 и Brier 0.097 читается как сигнал и по оси правильности, и по оси честности уверенности.
Для более строгого взгляда нужны диаграмма надёжности (предсказанная вероятность против наблюдаемой точности по бинам уверенности) и ECE — ожидаемая ошибка калибровки: Brier и KL это сводные скаляры, а диаграмма показывает, какие именно бины пере- или недооценены, что и требуется при выборе порога τ.
Детерминизм и сравнение с генеративным судейством
Каждое опубликованное значение — детерминированный выход, а не среднее по выборкам: он не зависит от seed и числа сэмплов и воспроизводится точно на том же входе, а значит, измеряемое не вносит дисперсию в собственный выход и проблемы «перезапустил — число сдвинулось» здесь просто нет.
В сравнении с генеративным судьёй ZTC получает уверенность напрямую из распределения, а не из logprob или многократной выборки; работает за один проход вместо O(L) декодирования; не имеет дисперсии выхода; не зависит от temperature, top-p и длины; а калибровка измеряется строго правильным правилом подсчёта очков.
Где применимо и какие ограничения
Авторы называют три сценария: крупномасштабная оценка выходов, где на миллионах элементов решающим становится один прямой проход на суждение; маршрутизация моделей, где лёгкие входы уходят малым моделям, а сложные — большим по порогу уверенности; предохранители безопасности, где меньшая самоуверенность позволяет агрессивнее поднимать планку автоматического принятия без утечек.
Ограничения тоже перечислены: числа получены на general-сплите typed-decisions, а калибровка чувствительна к сдвигу распределения и требует отдельной валидации; точность по типу score относительно низка, и метрики, лучше отражающие порядковую структуру (например, ранговая корреляция), — предмет дальнейшей работы; публичны веса, метод инференса и результаты бенчмарка, а детали конфигурации обучения не раскрыты.
Darwin-27B-ZTC занимает первое место в официальной таблице typed-decisions на Hugging Face с точностью 0.743 в зеро-шот-режиме; авторы приглашают к обсуждению того, как публиковать диаграммы надёжности и ECE и как смягчать деградацию калибровки при сдвиге распределения.