Модели
UIBK-Embedding-v1: плотный и late-interaction поиск в одной модели, одном индексе и одном MaxSim
Группа Data Science Университета Инсбрука выпустила открытую модель поиска на 179 млн параметров, в которой один проход энкодера даёт и плотный вектор, и токенные векторы ColBERT, а обычный MaxSim складывает обе оценки без второго индекса и без слияния результатов.
Два семейства поиска
Модели поиска делятся на два семейства: плотные bi-encoder'ы превращают текст в один вектор и сравнивают запрос с документом одним косинусом, а модели late interaction семейства ColBERT хранят по вектору на каждый токен и сравнивают через MaxSim, суммируя лучшие совпадения токенов.
Одно векторное представление хорошо передаёт, о чём текст, и это решает, когда длинный запрос надо сопоставить целиком; токенное совпадение находит точную сущность или фразу, что важно для фактоидных и multi-hop вопросов.
Обычно оба качества получают через hybrid retrieval: две модели, два индекса, два поиска и шаг слияния в конце. Модели вроде BGE-M3 возвращают несколько представлений из одного энкодера и экономят вторую модель, но каждое представление всё равно живёт в своём индексе со своей функцией оценки.
Авторы сначала проверили, что сигналы действительно дополняют друг друга: на двух файнтюнах от одного бэкбона плотная модель оказалась на 14,7 пункта лучше на ArguAna и на 7,7 на SCIDOCS, а late-interaction — на 5,0 лучше на NQ и на 4,7 на MS MARCO.
Как это устроено
Текст кодируется один раз, и на выходе получается обычный список 128-мерных единичных векторов — ровно то, что ожидает индекс ColBERT.
Бэкбон — ModernBERT-base с 22 слоями: первые 18 слоёв общие для двух голов, а последние четыре каждая голова держит своей копией, поэтому один проход стоит 26 вычислений слоёв вместо 22, а вторая голова добавляет 20,1 млн параметров к 149,0 млн базовых.
Плотная голова использует latent-attention pooling из NV-Embed: состояния токенов обращаются к 512 обучаемым латентным векторам, а среднее по токенам даёт вектор предложения на 768 измерений; в контролируемом сравнении на тех же данных, шагах и seed это оказалось на 0,8 пункта NanoBEIR лучше пулинга по [CLS].
Связывает всё приём со слотами: 768-мерный вектор предложения проецируется фиксированной случайной матрицей с ортонормальными строками в 381 = 3 × 127 измерений, режется на три среза и нормализуется, так что сумма трёх косинусов срезов приближает косинус исходных векторов предложения. Эти три вектора записываются поверх первых трёх позиций каждого текста, поэтому список не длиннее, чем у обычной модели ColBERT.
Чтобы два сигнала не смешались, каждый вектор получает ещё одну координату — тег с противоположными знаками для токенов и слотов; из-за этого слот никогда не выбирает токен, а токен не выбирает слот, как только его лучшее токенное совпадение даёт косинус выше 0,08. На практике разделение полное: на NanoBEIR по всем парам векторов запроса и документа ни один токен запроса не выбирает слот и ни один слот не выбирает токен.
В результате один стандартный MaxSim сам распадается на сумму: ранжирование задаётся late-interaction-оценкой плюс 0,75 от плотной. Вес 0,75 — свойство сохранённых векторов, и его можно выбрать при упаковке модели без всякого обучения.
Обучение и данные
Обучение идёт в три этапа на открытых данных с открытым cross-encoder'ом в роли учителя. Сначала — контрастивное предобучение ModernBERT-base на выборке из 331 млн пар публичной коллекции LightOn, около 75 часов на четырёх H100.
От этого бэкбона файнтюнятся две одноголовые модели — плотная и ColBERT; их усреднение по весам инициализирует гибрид, который затем обучается обеими головами, а последние четыре слоя дублируются в две вершины. Учитель — публичный кросс-энкодер mxbai-rerank-large-v2, а лосс складывается из пяти членов, из которых важнее всех дистилляция в тот самый счёт, который ранжирует документы при инференсе; финальная эпоха занимает 4,3 часа на четырёх H100.
Строки, чей запрос совпадает с тестовым или development-запросом BEIR, из обучения удалены: 37 391 строка из предобучающей выборки и 228 строк из файнтюн-коллекции.
Результаты
Все числа UIBK-Embedding-v1 получены в MTEB 2.21.6 со стандартной обёрткой PyLate и индексом PLAID с настройками по умолчанию — в оценке нет ничего специфичного для этой модели.
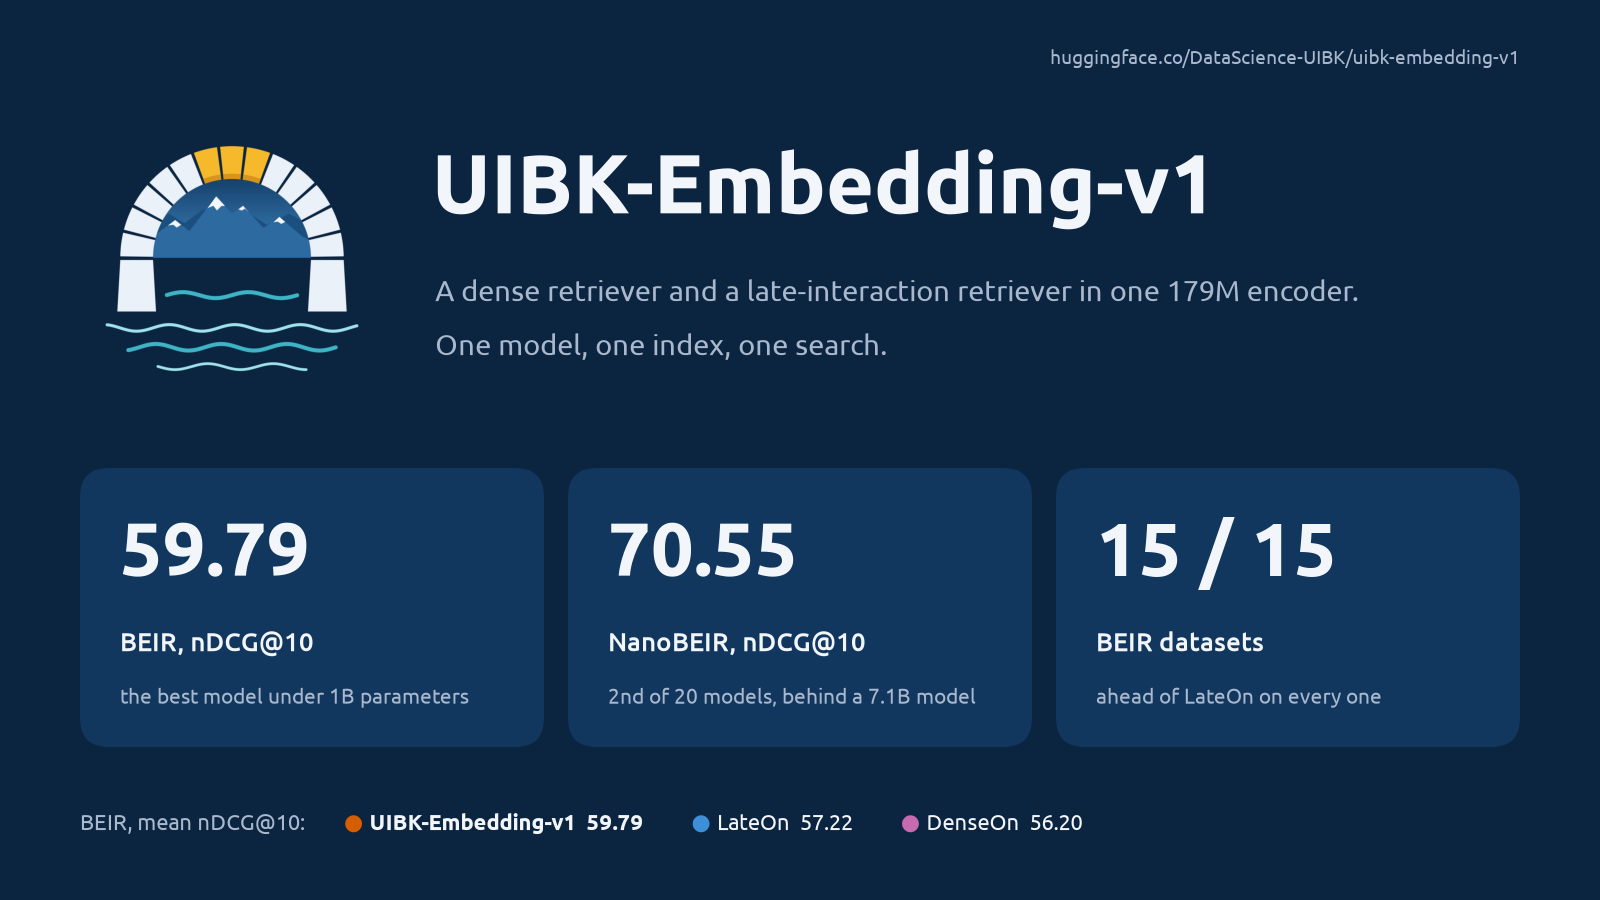
На 15 датасетах BEIR модель набирает 59,79 nDCG@10 против 57,22 у LateOn, лучшей другой модели своего класса, и обходит LateOn на всех 15 датасетах. Прирост больше всего на Touché (+9,3), ArguAna (+6,0), Climate-FEVER (+5,2), NQ (+3,9) и DBPedia (+3,2) — это датасеты обоих типов: и длинных аргументных запросов, где сильны плотные модели, и сущностных вопросов, где силён late interaction.
На NanoBEIR модель даёт 70,55 — второй результат среди 20 моделей с официальными числами; выше только inf-retriever-v1 с 7,1 млрд параметров и 72,04. На LoTTE success@5 равен 83,77 — лучший результат среди моделей с официальными числами MTEB. На LIMIT small recall@2 составляет 91,4 против 83,5 у GTE-ModernColBERT, при том что лексический бейзлайн BM25 на этом бенчмарке даёт 97,8. На десяти retrieval-задачах MTEB(eng, v2) модель набирает 62,47 — лучшее среди 45 моделей до 250 млн параметров, у которых есть все десять задач.
Авторы отдельно оговаривают честность сравнения с LateOn: их модель на 30 млн параметров больше, читает документы до 2048 токенов против 300 в опубликованных числах LateOn, но при равной длине документов разрыв всё равно остаётся.
Цена
Одна модель вместо двух означает один проход и один индекс. На FiQA (57 638 документов, один H100) модель кодирует 899 документов в секунду при индексе 580 MiB и поиске 7,8 мс на запрос; LateOn даёт 986 документов в секунду при 574 MiB и 4,4 мс, а гибрид LateOn + DenseOn — 541 документ в секунду при 743 MiB.
Кодирование на 9% медленнее LateOn — это цена четырёх дополнительных слоёв плотной вершины — и в 1,7 раза быстрее двух проходов гибрида LateOn и DenseOn, при индексе размера LateOn и на 22% меньше двух индексов гибрида.
Как запустить
Модель работает через PyLate; из необычного — нужен trust_remote_code=True, потому что два небольших модуля в репозитории задают двухвершинный энкодер и выходной слой, и обязательны промпты query: и document:. Запросы читаются до 256 токенов, причём плотная голова читает все, а токенная — первые 64; документы читаются до 2048 токенов. Веса доступны под лицензией Apache 2.0.
Ограничения
Модель только англоязычная: сама конструкция от языка не зависит, но многоязычную версию авторы не обучали. Как всякая late-interaction-модель, она хранит вектор на каждый токен, поэтому её индекс крупнее, чем у одновекторной модели, хотя три слота пишутся поверх существующих позиций и список не удлиняют.
Нужны trust_remote_code=True, transformers версии 5.3 и выше и оба промпта, а MultiVectorEncoder из Sentence Transformers 6 с этой моделью не тестировался. В разделе Limitations карточки модели сказано, что решения по данным, лоссам и learning rate принимались на самом BEIR и что модель пока не оценивалась на деконтаминированном или отложенном бенчмарке. В самой статье при этом приводится результат 61,55 на деконтаминированном BEIR — против 60,36 у LateOn по публикации и 59,69 при собственном прогоне авторов.
Что это значит
Вывод авторов прост: плотный ретривер и late-interaction-ретривер не нуждаются в двух моделях, двух индексах и шаге слияния — трёх слотов и одномерного тега достаточно, чтобы стандартный MaxSim складывал две оценки, а дистилляция кросс-энкодера в эту сумму превращает две головы в один ретривер. С 179 млн параметров модель обходит всё своё размерное окружение, а выше неё стоят только модели минимум с 1,5 млрд параметров.