Модели
«Одна модель вместо команды ранжирования»: AutoTrust показала ленты и поиск на решениях JEV-27B-VL
13 октября 2026 года лаборатория AutoTrust AI Lab опубликовала на Hugging Face разбор двух своих демонстраций — ленты коротких видео shorts.guru.so и новостного поиска news.guru.so. В обеих весь привычный конвейер рекомендаций заменён одной моделью решений: она смотрит, что пользователь смотрел последним, и на кандидатов — и за один прямой проход выдаёт калиброванную вероятность для каждого варианта, а сами вероятности и становятся порядком выдачи. Ничего для продукта не обучалось, признаки не проектировались, а логи не нужны до первой рекомендации. По обложкам модель догоняет коллаборативную фильтрацию, обученную на истории просмотров 59 045 человек (AUC 0,727 против 0,728), и обходит её по попаданию в топ-5 (59 % против 49 %).
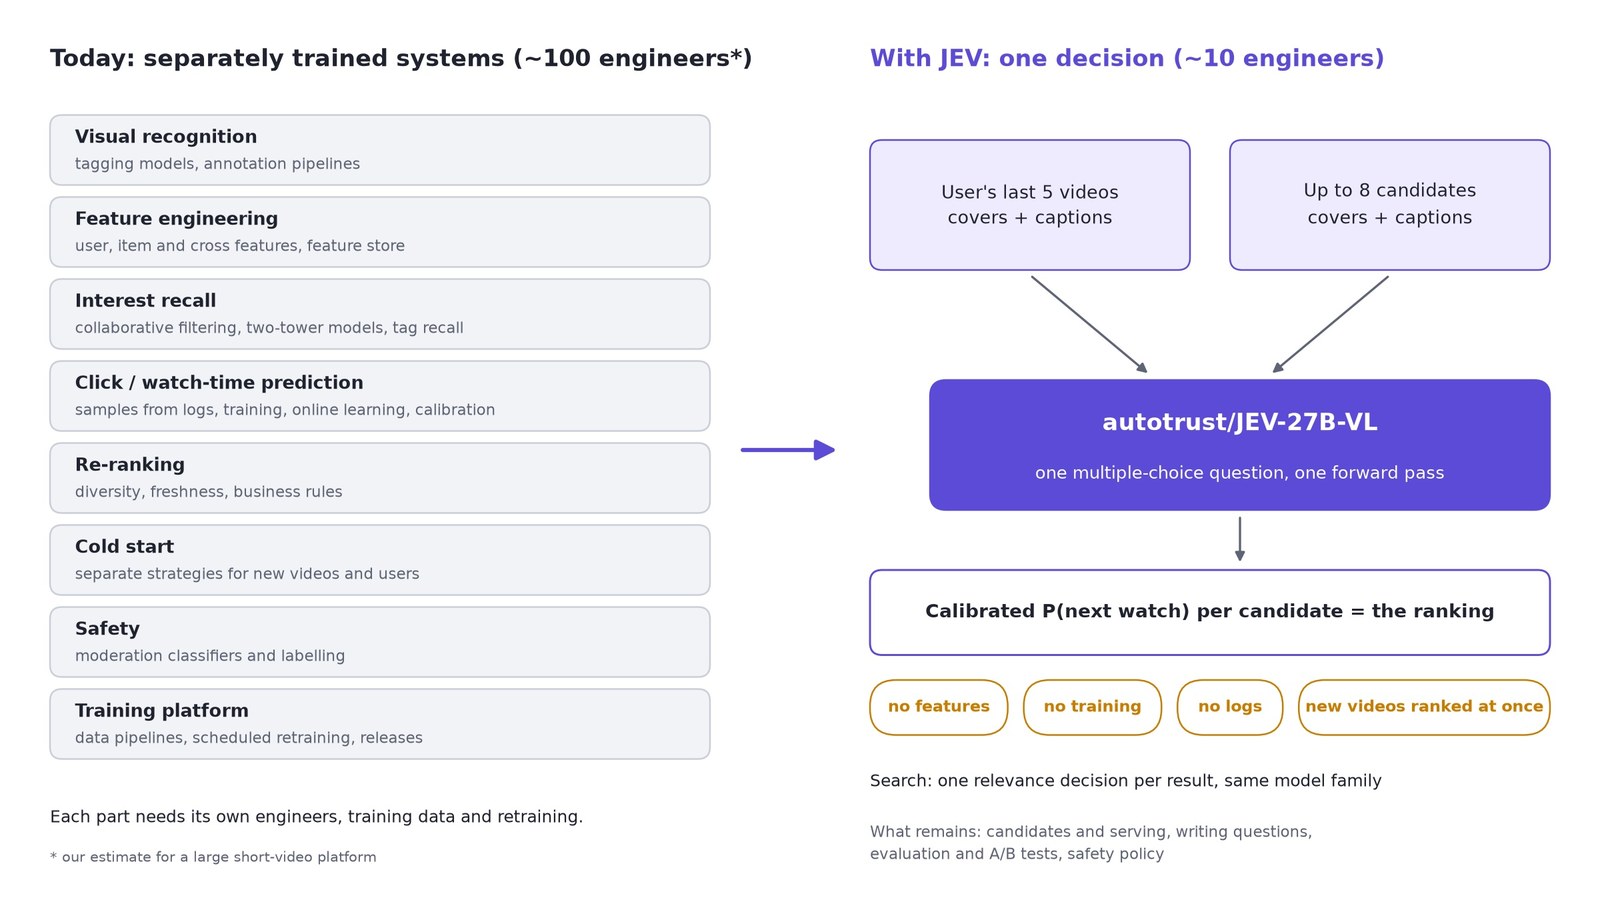
Один вопрос вместо конвейера
Авторы начинают с того, что рекомендации и поиск отвечают на один и тот же вопрос: какой из этих материалов нужен этому человеку. Крупные платформы отвечают на него стеком систем, каждая из которых обучается отдельно: модели понимания контента, признаки, спроектированные руками, модели отбора, предсказание клика и времени просмотра, переранжирование, правила холодного старта и классификаторы модерации.
Свою оценку объёма работы авторы дают прямо: по их расчёту, ранжирование в ленте коротких видео большой платформы требует не меньше 100 инженеров, а поиск строится таким же образом — понимание и переписывание запроса, оценки релевантности от людей, признаки и модели learning-to-rank, обученные переранжировщики и генерация ответа.
В двух своих демонстрациях авторы вместо этого задают вопрос модели напрямую. Для ленты коротких видео нужны изображения, поэтому там работает autotrust/JEV-27B-VL; новостная часть обходится текстом и использует autotrust/JEV-27B или autotrust/JEV-35B. Каждая область стека в демонстрациях — либо одно решение модели, либо несколько строк кода.
Почему, по мнению авторов, одного решения хватает
Первое: модель видит. Она читает обложки и подписи, поэтому понимание контента происходит внутри ранжирования, а не в отдельной системе разметки видео.
Второе: модель читает историю пользователя в момент запроса. Интерес выводится из последних просмотров при каждом запросе, а не заучивается в эмбеддинги, которые нужно переобучать: лайк или пропуск меняет уже следующую порцию.
Третье: она возвращает калиброванные вероятности за один прямой проход и не генерирует текст. Такие числа можно сортировать, сливать из разных источников — в демонстрациях это 6 новостных лент и 3 поисковых движка — и отсекать по порогу, например на проверке безопасности или при отбрасывании слабых кандидатов.
Четвёртое: модель сравнивает кандидатов между собой. Один вопрос ранжирует целую порцию — это, по измерениям авторов, и быстрее, и точнее, чем оценивать каждого кандидата по отдельности.
Пятое: поведение меняется вместе с вопросом, а не вместе с переобучением. Если добавить в вопрос то, что пользователь ищет сегодня, лента превращается в ленту с поисковым управлением; если спрашивать о важности, а не о релевантности, поисковый ранжировщик становится новостным рекомендателем.
Лента коротких видео
Пул демонстрации — 8,9 миллиона английских видео 2026 года из набора datasocial/tiktok-5.6B-videos, отобранных по языку: не реклама, длительность от 5 секунд до 10 минут, не меньше 50 тысяч просмотров.
Кандидатов предлагает короткая функция оценки по размеченному пулу примерно из 11 тысяч видео: пересечение тем с последними просмотрами, общие хештеги, тот же автор или звук, тематические предпочтения и слабый приор популярности. Поиск внутри ленты идёт по google/embeddinggemma-2 без дообучения по всем 8,9 миллиона подписей — около 60 миллисекунд на запрос.
Само ранжирование — это один вопрос с выбором варианта: в него кладут обложки и подписи последних 5 просмотренных видео и до 8 кандидатов. В коде демонстрации запрос уходит методом POST на https://api.scienceguru.ai/v1/decide с полями "model": "jev-27b-vl" и "kind": "choice", а ответные вероятности сортируются по убыванию.
Следующую порцию приложение запрашивает, когда в текущей остаётся 3 видео: тогда ранжирование успевает учесть свежие лайки и пропуски и закончиться, пока пользователь досматривает предыдущее видео. Если модель не успевает к сроку, порция показывается в порядке кандидатов.
Новости: рекомендация и поиск
В news.guru.so рекомендация берёт свежие заголовки из 6 новостных лент и делает по одному решению о важности на заголовок, все запросы идут параллельно: 60 решений за 0,46 секунды.
Поиск собирает результаты Google News, Bing News и Yahoo News и делает по одному решению о релевантности на результат. Каждый результат получает вероятность релевантности и оценку от 0 до 5, их среднее и задаёт место: это 22–24 решения за 0,23–0,62 секунды. Страница показывает этот порядок рядом с порядком самих движков, а первые 8 результатов идут в короткий ответ со ссылками.
Результаты без обучения
На MicroLens-100k, где модель ранжирует 20 кандидатов и должна угадать следующее просмотренное видео, она набирает AUC 0,727, используя только обложки. Обученная item-based коллаборативная фильтрация на истории 59 045 пользователей даёт 0,728, то есть разница по AUC нулевая — 0,000 при 95-процентном интервале от −0,041 до +0,040, — но по попаданию в топ-5 модель впереди: 0,590 против 0,490. Существенная разница в том, что коллаборативной фильтрации нужна история совместных просмотров, а модели достаточно обложки.
На MIND, наборе для новостных рекомендаций, модель даёт AUC 0,642 против 0,616 у LightGBM, обученного на MIND с признаками, собранными руками. На TREC-COVID при переранжировании поиска модель набирает nDCG@10 0,858 против 0,793 у bge-reranker-v2-m3, обученного переранжированию.
Отдельно авторы прогнали на 100 пользователях MicroLens тот самый вопрос, который использует shorts.guru.so, — 8 кандидатов с подписями и обложками. Модель набрала AUC 0,760, поставила настоящее следующее видео на первое место для 50 % пользователей и в топ-3 для 75 %; случайная выдача даёт 12,5 % и 37,5 % соответственно.
Скорость, стоимость и вместимость
Главную экономию авторы показывают сравнением двух способов задать вопрос на 200 случаях из публичных плейлистов YouTube по 20 кандидатов, на одном B200. Отдельный вопрос «да/нет» на каждого кандидата — это 20 решений, AUC 0,905 и 1,54 секунды на пользователя. Один вопрос с выбором на всю порцию — 1 решение, AUC 0,931 и 0,42 секунды.
В живой ленте медиана составляет 0,73 секунды на вызов модели и 1,44 секунды от начала до конца; ждать этого времени пользователю не приходится, потому что порция ранжируется, пока он смотрит предыдущую. В новостях это 0,23–0,62 секунды на поиск и 0,46 секунды на 60 заголовков.
По вместимости: при 8 кандидатах на вопрос один ключ API с лимитом 120 решений в минуту ранжирует около 960 видео в минуту, а развёрнутая самостоятельно на одном B200 модель ранжирует порядка 258 кандидатов в секунду.
Текстовые решения JEV-27B-VL принимает так же, как текстовая модель: на 1 000 решений средняя разница вероятностей составляет 0,010. Карточка модели указывает архитектуру Image-Text-to-Text, 28 миллиардов параметров и лицензию Apache-2.0.
Что авторы сами называют ограничениями
Первое ограничение — это прокси, а не продакшен-метрики. Оффлайновые бенчмарки взяты с других платформ, поэтому выигрыш в продакшене ещё нужно подтверждать A/B-тестами, а оценки численности команд — это расчёт авторов, а не измерение.
Второе — дешёвая ступень отбора кандидатов остаётся. Это арифметика, а не обученная модель, потому что прогонять модель на 27 миллиардов параметров по миллионам материалов на каждый запрос нереально.
Третье — пороги не проверены: порог безопасности и правило отбрасывания слабых кандидатов не сверялись с размеченными данными.
Четвёртое — лицензии данных. Набор datasocial/tiktok-5.6B-videos распространяется под CC BY-NC 4.0, а MIND — на условиях Microsoft Research.
Место материала
Та же страница ссылается на два более ранних материала AutoTrust AI Lab — от 27 и 30 сентября 2026 года, посвящённых самим моделям JEV-27B и JEV-27B-VL. Новый текст описывает уже прикладной уровень: ленту и поиск целиком, с измерениями на публичных наборах, живыми демонстрациями и открытым кодом запроса к модели.
Числа и оценки в материале принадлежат авторам: независимой проверки бенчмарков и заявлений о численности команд редакция не проводила.
Первоисточники
- Hugging Face — AutoTrust AI Lab, «One Decision Model Instead of a Ranking Team: Short-Video and News Recommendation with autotrust/JEV-27B-VL» (Community Article, 13 октября 2026)
- Hugging Face — карточка модели autotrust/JEV-27B-VL (AutoTrust AI Lab): Image-Text-to-Text, 28B, лицензия Apache-2.0, бенчмарки MicroLens, MIND и TREC-COVID
- Hugging Face — карточка модели autotrust/JEV-27B (AutoTrust AI Lab): текстовая модель решений, 27B