Модели
«Первое место без единого сгенерированного токена»: Darwin-27B-ZTC-v2 возглавила бенчмарк System One Mosaic
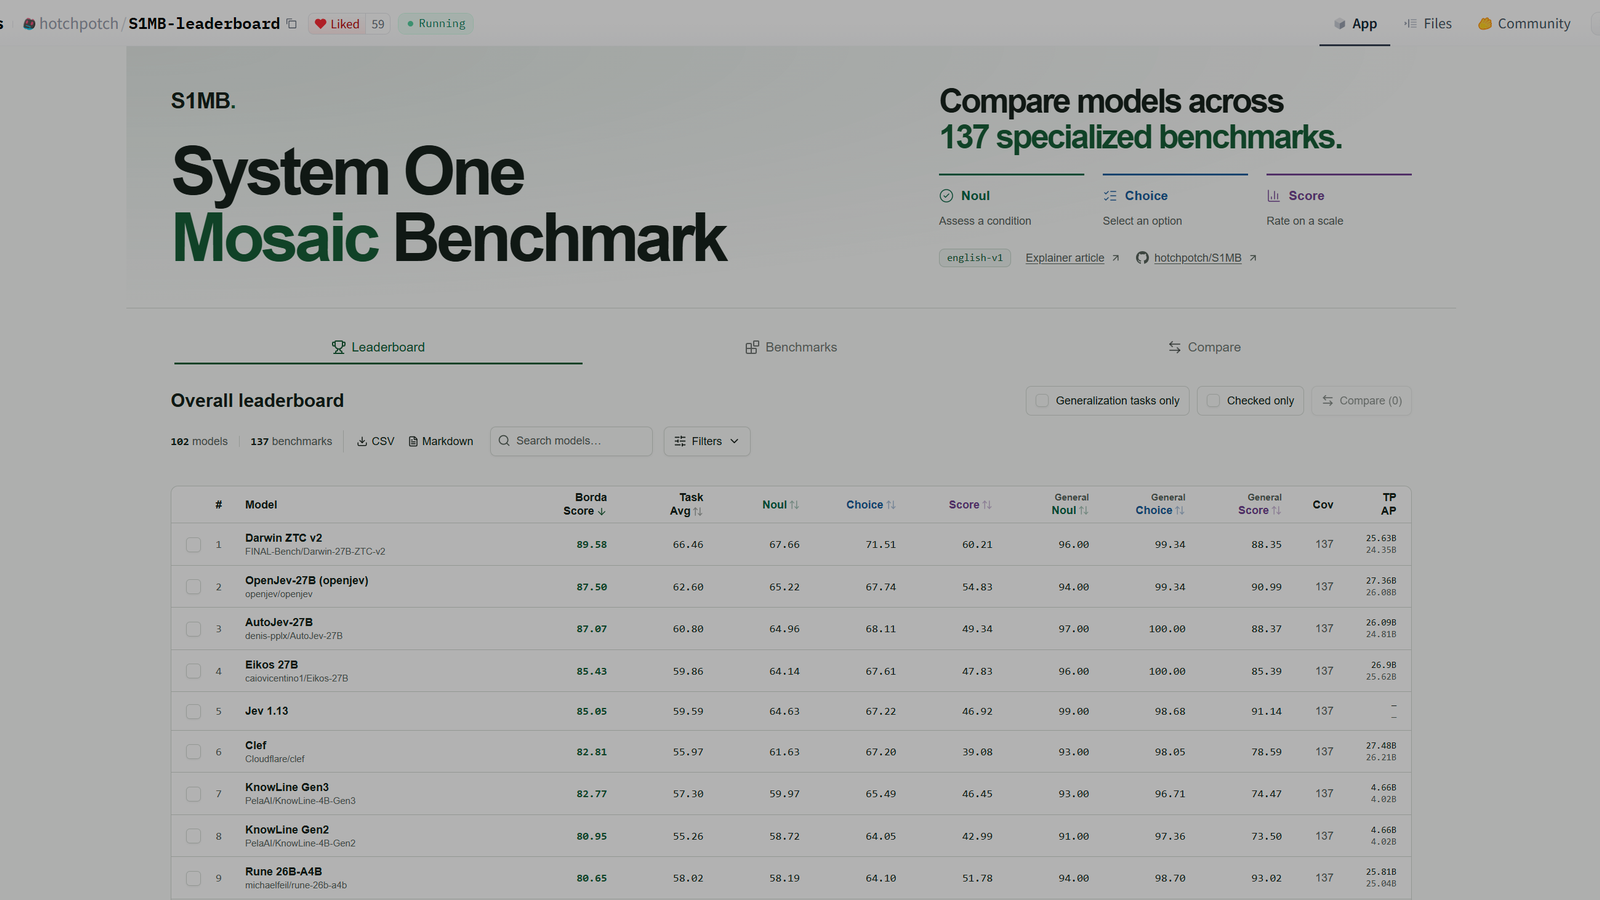
FINAL_Bench показала, как её судья Darwin-27B-ZTC-v2 вышел на первое место в сводном бенчмарке System One Mosaic (S1MB): модель читает состояние и типизированные вопросы и возвращает метку с калиброванной вероятностью за один прямой проход, без генерации текста. Лидерство держится и на обобщающих сплитах, где модель набирает 96.00, 99.34 и 88.35 по семействам Noul, Choice и Score.
Что произошло
9 октября 2026 года в блоге Hugging Face компания FINAL_Bench опубликовала материал «Leading the System One Mosaic Benchmark: What Darwin-27B-ZTC-v2's #1 Means» — разбор того, как её судья Darwin-27B-ZTC-v2 вышел на первое место в сводном бенчмарке System One Mosaic (S1MB), который ведёт hotchpotch.
Это продолжение более ранней публикации FINAL_Bench о судье Darwin-27B-ZTC с одним прямым проходом: теперь акцент смещён на место модели в общей таблице, а не на устройство калибровки.
Что такое «System One» и как устроен S1MB
Отдельный класс моделей 2026 года — «System One»: они вообще не генерируют свободный текст. Вместо ответа токен за токеном такая модель читает состояние и набор типизированных вопросов и возвращает структурированный результат — метку и калиброванную вероятность — за один прямой проход. Рамку популяризировала TypeSafe AI с моделью JEV от бывших исследователей OpenAI: для маршрутизации, оценки и предохранителей внутри агентных систем нужна не проза, а быстрое типизированное решение с уверенностью, по которой можно задать порог.
S1MB (System One Mosaic Benchmark, ведёт hotchpotch) собран именно под такие модели: он объединяет 137 специализированных бенчмарков в три семейства задач — Noul (оценить условие, открытая корректность утверждения), Choice (выбрать правильный вариант из кандидатов) и Score (оценить по шкале, порядковое суждение). Это три разные задачи: открытая проверка, категориальная классификация и, по сути, порядковая регрессия, — поэтому одна модель, обязанная закрывать все три, не может подстроиться под одну геометрию решения.
Рейтинг строится не по среднему сырых чисел, а по Borda:-счёту. Каждый бенчмарк превращается в ранг, и ранговые баллы суммируются по всем 137 — так поощряется широкая и ровная сила, а не всплеск на нескольких удобных задачах. Авторы называют агрегацию намеренно консервативной: занять верхнюю позицию по Borda труднее, чем по сырому среднему.
Результаты
На момент публикации Darwin-27B-ZTC-v2 — первое место в общем зачёте: Borda 89.58 при Task Avg 66.46 и по семействам Noul 67.66, Choice 71.51, Score 60.21.
Дальше идут модели семейства JEV: OpenJev-27B (Borda 87.50, Task Avg 62.60), AutoJev-27B (87.07; 60.80), Eikos 27B (85.43; 59.86) и Jev 1.13 (85.05; 59.59).
Разрыв наверху, отмечают авторы, задают Task Avg (66.46 против 62.60 у второго места) и колонка Score (60.21 против 54.83) — самое трудное из трёх семейств: порядковое оценивание проседает у большинства судей, и именно там разрыв самый широкий. Второе наблюдение: места со второго по пятое занимают модели семейства JEV (OpenJev, AutoJev и сам JEV), а S1MB — домашний бенчмарк категории System One, поэтому лидерство против моделей, которые эту категорию и задали, авторы считают содержательным результатом, а не победой на нишевом тесте.
На обобщающих сплитах модель держится высоко: General Noul 96.00, General Choice 99.34, General Score 88.35 при покрытии всех 137 бенчмарков. Эти числа важны потому, что судья полезен, только если держится на входах, под которые его не настраивали.
Почему судья без токенов хорошо проходит S1MB
Darwin-27B-ZTC — классификатор с нулём сгенерированных токенов: он не сэмплирует, а читает вход и типизированные вопросы и сразу выдаёт распределение вероятностей за один прямой проход. Отсюда три свойства, и все три совпадают с тем, что измеряет S1MB.
Детерминизм: без сэмплирования нет дисперсии выхода — один и тот же вход даёт одно и то же распределение, поэтому заявленные числа это точные значения, а не оценки по выборке.
Стоимость одного прохода: задержка не растёт с длиной выхода, потому что цикла декодирования нет; на бенчмарке из 137 наборов и в реальных развёртываниях на миллионы суждений это структурная, а не постоянная разница в цене.
Калиброванная уверенность: раз модель выдаёт распределение, её можно оценивать на честность уверенности, а не только на правильность. На родственной таблице typed-decisions модель тоже первая (точность 0.743, зеро-шот) при калибровке KL 0.204 и Brier 0.097; Brier — строго правильное правило подсчёта очков, поэтому эти числа нельзя улучшить, завышая или занижая уверенность.
Совпадение не случайно: S1MB сам есть набор типизированных решений, поэтому модель, изначально выдающая типизированные распределения, отвечает на языке бенчмарка, тогда как генеративную модель приходится приводить к этой форме промптом или извлечением logprob — а это добавляет шум и цену.
Честное чтение результата
Публичные таблицы лидеров двигаются: добавляются новые модели, и верхняя позиция — это снимок, а не постоянный титул. Числа отражают таблицу на момент написания, и авторы называют ранг вместе с датой, а не как абсолютное утверждение.
Стоит быть точными и в границах: S1MB измеряет качество типизированных решений — он не измеряет открытую генерацию, длинные рассуждения или работу с инструментами. Darwin-27B-ZTC — судья, а не чат-модель, и результат относится именно к категории судей.
Вывод авторов: категория System One оценивается как отдельный рынок, и во главе бенчмарка, построенного её измерять, теперь стоит судья без токенов — лидерство шире всего на самом трудном семействе и держится на обобщающих сплитах, а это ровно тот профиль, который нужен от судьи перед маршрутизатором или предохранителем.