Робототехника
Skild AI научила робота осваивать новые задачи по одному видео
S1 принимает видеодемонстрацию как prompt и без task-specific post-training выполняет незнакомые многошаговые операции длительностью до десяти минут; исследование опирается на NVIDIA Cosmos, Omniverse, Isaac Sim и Isaac Lab.
Видеозапись вместо нового цикла обучения
Skild AI представила S1 — robot foundation model, которая получает видеодемонстрацию новой операции как prompt, интерпретирует цель, предметы и последовательность действий, а затем переносит показанное на доступного робота. Модель при этом не обновляет веса и не проходит task-specific post-training: компания называет этот режим in-context learning по аналогии с тем, как языковая модель осваивает задачу из примеров в контексте.
Отличие от обычной промышленной автоматизации особенно заметно при частых изменениях. Фиксированная robotic cell обычно требует новой программы, сбора данных и валидации после смены продукта, оснастки или планировки. S1 должна позволить оператору показать желаемое действие камерой и перейти к исполнению без отдельного training run для каждой вариации. Это не означает, что робот становится универсальным: результат зависит от предварительно обученного общего представления о манипуляциях и физическом мире.
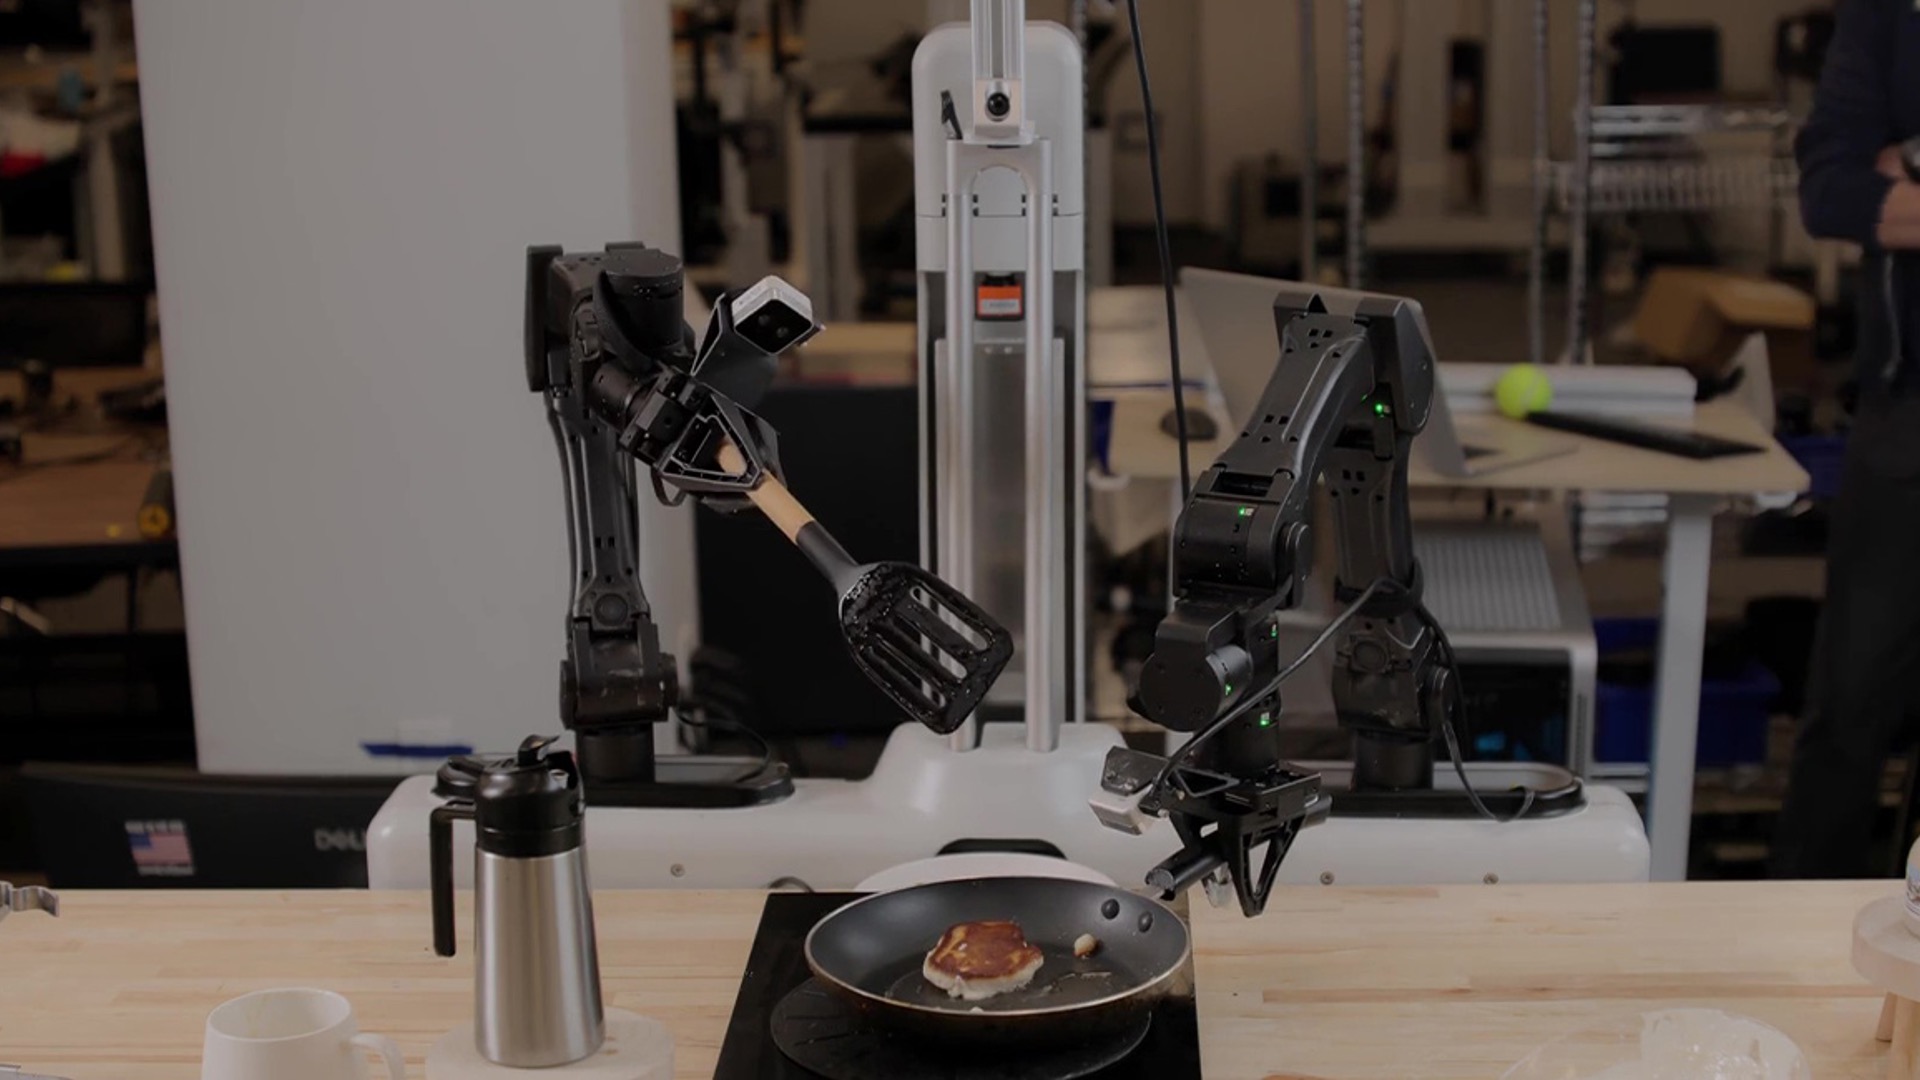
В опубликованных демонстрациях S1 выполняет ранее не показанные ей длинные задачи: пересаживает растение, готовит блины, заваривает pour-over coffee и комплектует наборы. Операции длятся до десяти минут и могут включать десятки шагов. В тесте с пересадкой растения команда перешла от записи примера к автономному запуску на реальном оборудовании за 11 минут; модель также реагировала на перемещение объектов и пыталась восстановиться после ошибок.
Что именно измерила команда
По данным Skild, на новых многошаговых задачах S1 успешно завершала отдельный шаг примерно в 66% случаев, тогда как сравниваемая AI-система — в 9%. Компания описывает это как улучшение более чем в семь раз. Метрика относится к step-level success в собственных испытаниях разработчика: она не равна 66-процентной вероятности безошибочно закончить всю десятиминутную последовательность и пока не подтверждена независимым benchmark.
Skild также оценивает информационную ценность одной короткой видеодемонстрации примерно в 380 hands-on training examples. Ручной сбор такого объёма данных, по оценке компании, занял бы 50–100 часов. Сравнение показывает потенциальную экономию при адаптации, но не раскрывает универсальную формулу пересчёта: полезность примера будет меняться вместе со сложностью задачи, типом робота, камерой, объектами и необходимой точностью.
Сама Skild подчёркивает, что текущая публикация сосредоточена на способности S1 к in-context learning, а описание обучения модели выйдет позднее. Поэтому сейчас нельзя независимо оценить состав pretraining dataset, степень пересечения тестовых сцен с обучающими или вычислительную стоимость общего pretraining. Корректный вывод уже опубликованных опытов уже: один video prompt позволил модели выполнить выбранные незнакомые последовательности без изменения весов.
Симуляция, синтетические данные и реальный цех
Skild построила S1 и провела исследование на NVIDIA AI infrastructure. Cosmos world foundation models используются для диверсификации данных и превращения видео в структурированные описания, а Cosmos Curator — для разметки, фильтрации и организации наборов. Omniverse и Isaac Sim дают физические виртуальные среды, где можно генерировать опыт, проверять edge cases и валидировать поведение до выхода на оборудование.
Reinforcement learning проходит в Isaac Lab поверх Newton physics engine, моделирующего силы, контакты, столкновения и давление. Skild и NVIDIA также совместно разрабатывают GPU-accelerated simulation solvers для захвата и манипуляций твёрдыми объектами; NVIDIA сообщает, что они позднее войдут в Newton и станут доступны другим разработчикам. На этапе развёртывания Nsight ищет узкие места, а TensorRT оптимизирует inference для более быстрой реакции робота.
Один production-oriented сценарий компании показывают вместе с Foxconn: Skild Brain управляет dual-arm manipulators при сборке систем NVIDIA Blackwell. В демонстрации робот устанавливает busbar и limit block, закручивает 16 винтов и корректирует последовательность после помех. Это свидетельство интеграции многошаговой модели с промышленным манипулятором, но публикация не приводит throughput, yield, время цикла или длительную статистику отказов линии.
Где проходит граница между демонстрацией и продуктом
NVIDIA сообщает, что через десять месяцев после первого коммерческого внедрения Skild достигла annual revenue run rate в $100 млн и сформировала более 60 deployment partnerships в производстве, логистике, инспекции, безопасности и приготовлении еды. Это операционные заявления самой компании и её инфраструктурного партнёра, а не раскрытая финансовая отчётность; число партнёрств также не показывает, сколько установок уже работает в постоянном production-режиме.
Механизм накопления опыта имеет отдельное ограничение: данные из коммерческих внедрений могут улучшать общий robot brain только там, где это разрешают соглашения с клиентами. Для предприятия это превращает вопросы владения video, телеметрией и неудачными эпизодами в часть архитектуры продукта. До внедрения потребуется определить, какие данные покидают площадку, как они обезличиваются и может ли новая версия модели использовать опыт другого заказчика.
Практическая новизна S1 состоит не в обещании робота, умеющего всё, а в смене интерфейса адаптации: задача задаётся примером поведения, а не новым кодом или полным набором teleoperation trajectories. Следующий уровень доказательности — воспроизводимые испытания на других embodiment, полный task success вместо успеха отдельного шага, стабильность на длинных горизонтах и измерение безопасности после непредвиденных изменений среды. Пока опубликованные результаты показывают сильный прототип такого подхода, но не заменяют site-specific validation.