Робототехника
2 048 миров вместо одного: NVIDIA перенесла физику MuJoCo на GPU в MuJoCo Warp
23 сентября 2026 года NVIDIA показала на примере манипулятора SO-101, как перенести сцену MuJoCo с CPU на GPU и масштабировать её до 2 048 параллельных сред MuJoCo Warp. Ценность здесь не в более быстром шаге одного мира, а в суммарной пропускной способности и в честном замере: детерминированное исполнение появилось в Warp 1.15 как опция.
От одного мира к батчу
23 сентября 2026 года NVIDIA опубликовала вторую статью цикла State of Simulation for Physical AI. В ней сцена MuJoCo с манипулятором SO-101 переносится с привычного CPU-процесса на GPU и масштабируется до 2 048 параллельных сред MuJoCo Warp.
MuJoCo Warp (MJWarp) — реализация физического конвейера MuJoCo на NVIDIA Warp: модель и батч независимых состояний размещаются на NVIDIA GPU, а один вызов mjw.step продвигает весь батч. Документация MJWarp описывает её как реализацию MuJoCo, написанную на Warp и оптимизированную под оборудование NVIDIA и параллельную симуляцию, которую NVIDIA и Google DeepMind развивают совместно.
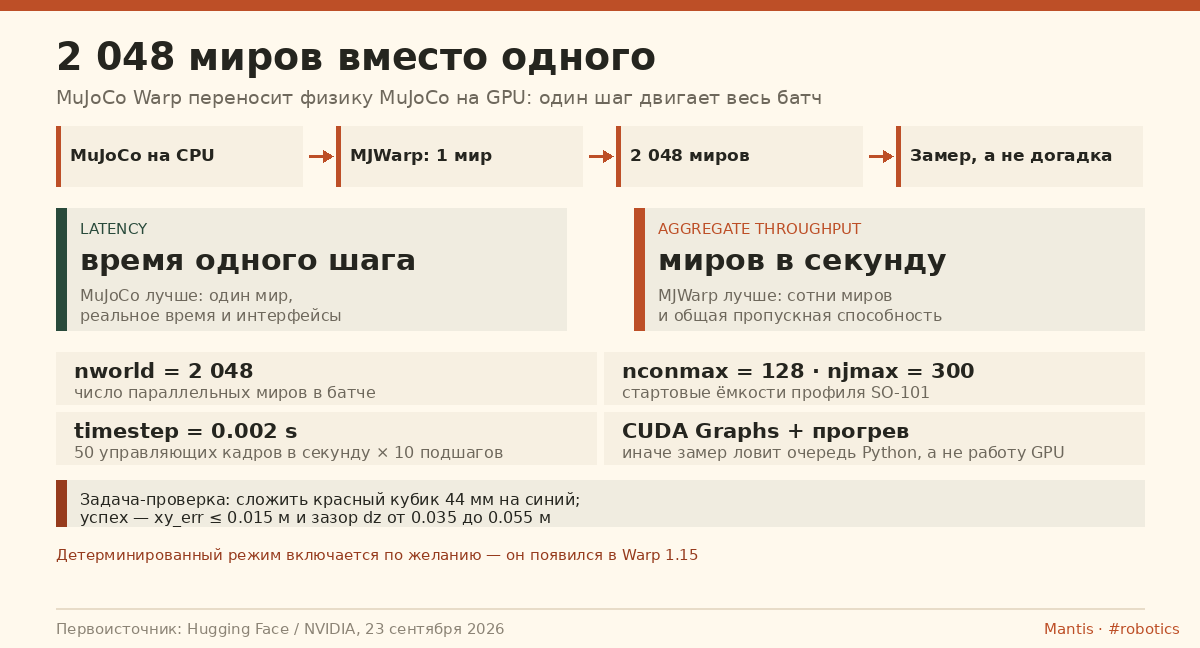
Ключевую оговорку авторы подчёркивают отдельно: ценность MJWarp не обязательно в более быстром шаге для одного мира. Она в возможности продвигать сотни или тысячи миров вместе, давая GPU достаточно параллельной работы, чтобы росла суммарная пропускная способность — общее число шагов миров за секунду.
Разделение здесь точное: latency — это время на один шаг симуляции, а aggregate throughput — сколько шагов миров выполнено за измеренную секунду. Документация MJWarp формулирует то же самое: MJWarp оптимизирован под пропускную способность, то есть число шагов симуляции за единицу времени, тогда как MuJoCo — под задержку одного шага.
Практический вывод из этого разделения тоже назван прямо: для обучения с подкреплением, где нужно много образцов, ставка на батч оправдана, а для задач реального времени вроде MPC и интерактивных интерфейсов выгоднее остаётся MuJoCo.
Что такое NVIDIA Warp
Warp — Python-фреймворк для написания высокопроизводительных ядер с ускорением на GPU. Разработчик пишет статически типизированные ядра на Python, а Warp компилирует их для исполнения на CPU или CUDA; первый запуск собирает и кеширует нативный модуль, а последующие его переиспользуют.
Warp обещает три вещи: производительность уровня нативного CUDA за счёт JIT-компиляции, слияния ядер и CUDA Graphs; удобство работы на чистом Python со встроенными векторами, матрицами, кватернионами, BVH, хеш-сетками, разреженными матрицами и тайловыми примитивами; и возможности вроде дифференцируемых ядер с интеропом в стиле DLPack, чтобы симуляция жила внутри цикла обучения.
Модель исполнения простая: один логический поток обрабатывает одну точку, поэтому один и тот же код масштабируется с двух точек до миллионов, не принося терминологию GPU в поток управления. CUDA-граф при этом повторяет запуски ядер против существующих буферов, но не сливает произвольные ядра.
Переход со MuJoCo на MJWarp
Переход по API невелик: mjw.put_model(mjm) создаёт модель на устройстве, mjw.put_data(mjm, d) переносит и батчирует существующее состояние, mjw.step(m, d) продвигает каждый мир в d, а host-массивы вида ctrl становятся батчевыми массивами устройства формы (nworld, nu).
Есть развилка между конструкторами: mjw.make_data() нужен, когда подразумевается состояние по умолчанию, а mjw.put_data() — когда через границу переноса должно перейти именно инициализированное состояние MuJoCo.
Размер батча задают три параметра. nworld определяет число моделируемых миров, а nconmax — ожидаемое число контактов на мир и, значит, общую ёмкость контактов примерно как nconmax, умноженный на nworld.
Число njmax задаёт максимум ограничений на мир, а альтернативный naconmax — глобальный максимум контактов по всем мирам; если заданы оба, приоритет у naconmax.
В документации оговорено и ограничение парсинга: значения nconmax и njmax не читаются из size/nconmax и size/njmax, поскольку эти параметры устарели, и должны передаваться в mjw.make_data или mjw.put_data.
Проверка на одной сцене
Сцена для проверки сама по себе обычный MJCF: манипулятор SO-101, стол и два кубика. Задача — схватить красный кубик размером 44 мм и поставить его на синий.
Успех здесь измеряется, а не предполагается: горизонтальная ошибка центров xy_err не должна превышать 0,015 м, а вертикальный зазор между центрами кубиков dz обязан лежать в диапазоне от 0,035 до 0,055 м. Оба условия проверяются после того, как кубики успокоились, поэтому успешный код возврата сам по себе задачу не подтверждает.
Частоты нужно согласовать. При 50 управляющих кадрах в секунду и 10 физических подшагах на кадр физический шаг равен 0,002 секунды. Выставить его следует до CPU-прогона и до загрузки модели через mjw.put_model, иначе расхождение унаследуют все последующие измерения — сравнение паритета, число пропускной способности и обученная политика.
Первый паритет проверяют на одном мире с host в цикле: модель загружается на устройство, батчевое состояние выделяется из инициализированного host-состояния, и у каждого массива устройства появляется ведущая размерность мира. Чтения вида.numpy() синхронизируют и копируют данные на host на каждом подшаге, поэтому это путь валидации задачи, а не замер пропускной способности.
Ёмкости контактов и ограничений
MJWarp выделяет буферы контактов и ограничений заранее, и превышение этих ёмкостей обнуляет прогон для верификации или бенчмарка — даже когда исполнение продолжается с предупреждением о переполнении вместо исключения.
Профиль SO-101 в статье использует nconmax=128 и njmax=300 как стартовые ёмкости, а вариант reBot — nconmax=256 и njmax=500. Подбирать их нужно по самому контактному моменту задачи: для pick-and-place это мгновение, когда обе губы захвата и стол касаются кубика, а не парящий в воздухе манипулятор.
Инструмент mjwarp-testspeed --measure_alloc сообщает, сколько контактов и ограничений сцена реально потребила, и прерывает прогон с идентификаторами проблемных миров при переполнении. Такие отчёты следует считать отказом — поднять лимит и прогнать заново, прежде чем доверять траектории или бенчмарку.
2 048 миров и честный замер
После паритета одного мира сцена переразмечается на целевую величину: в статье это 2 048 миров, состояние инициализации тиражируется по батчу через np.tile, и на каждом шаге через PCIe больше ничего не передаётся.
CUDA-граф переиспользует уже захваченные модель и буферы данных: управляющий вход обновляется на месте между повторами, а новый граф нужен после замены буферов, изменения nworld или перестройки модели.
Замер устроен строго, потому что GPU-запуски асинхронны и наивный таймер измеряет скорость постановки работы в очередь Python, а не её завершения на GPU. Сначала прогрев, затем синхронизация непосредственно до и после измеряемого участка: без неё измеряется очередь, а не работа.
Отчитываться нужно двумя числами вместе с размером батча: aggregate world-steps в секунду и миллисекундами на батчевый шаг. Именно по измеренной кривой видно, где добавление миров улучшает пропускную способность, а где упирается в память или вычисления, и сравнение задержки одного мира батчевую пропускную способность не доказывает.
Дифференцируемость и детерминизм
Две возможности Warp в этом сценарии SO-101 не используются, но о них стоит знать. Ядра Warp дифференцируемы: wp.Tape записывает прямые запуски ядер, выполненные внутри его контекста, и при вызове backward() воспроизводит их сопряжённые операции в обратном порядке.
Детерминированное исполнение опционально и появилось в Warp 1.15: по умолчанию атомарные операции GPU зависят от планировщика, поэтому повторы одного и того же ядра могут различаться, а опциональные детерминированные режимы обменивают часть производительности на воспроизводимый порядок в симуляции, валидации и регрессионных тестах.
Выпуск описывает и механизм: детерминированный режим меняет алгоритм исполнения и использует временное хранилище, поэтому его влияние на производительность зависит от шаблона атомарных операций и уровня конкуренции, а затронутые ядра рекомендуется измерить до широкого включения.
Куда дальше
Статья — вторая в цикле State of Simulation for Physical AI: первая описывала ландшафт симуляции для роботов, а следующая перенесёт ту же среду MJCF в Newton, где MuJoCo Warp будет решателем твёрдых тел, и покажет, что добавляют мультиформатные ассеты, сменные решатели, сенсоры и путь через Isaac Lab.
Авторы отдельно отмечают, что политику здесь не обучают: статья готовит и масштабирует среду симуляции. Обучать поверх физики MJWarp можно через mjlab, MuJoCo Playground через MJX с impl='warp' и Isaac Lab через Newton.