Робототехника
Qwen-Drive 1.0 объединила восприятие, вопросы и планирование движения
Исследовательская система на базе Qwen3.5-4B сохраняет исходную VLM-архитектуру и подключает отдельные модули для 3D-восприятия и построения траектории.
Одна основа для трёх задач
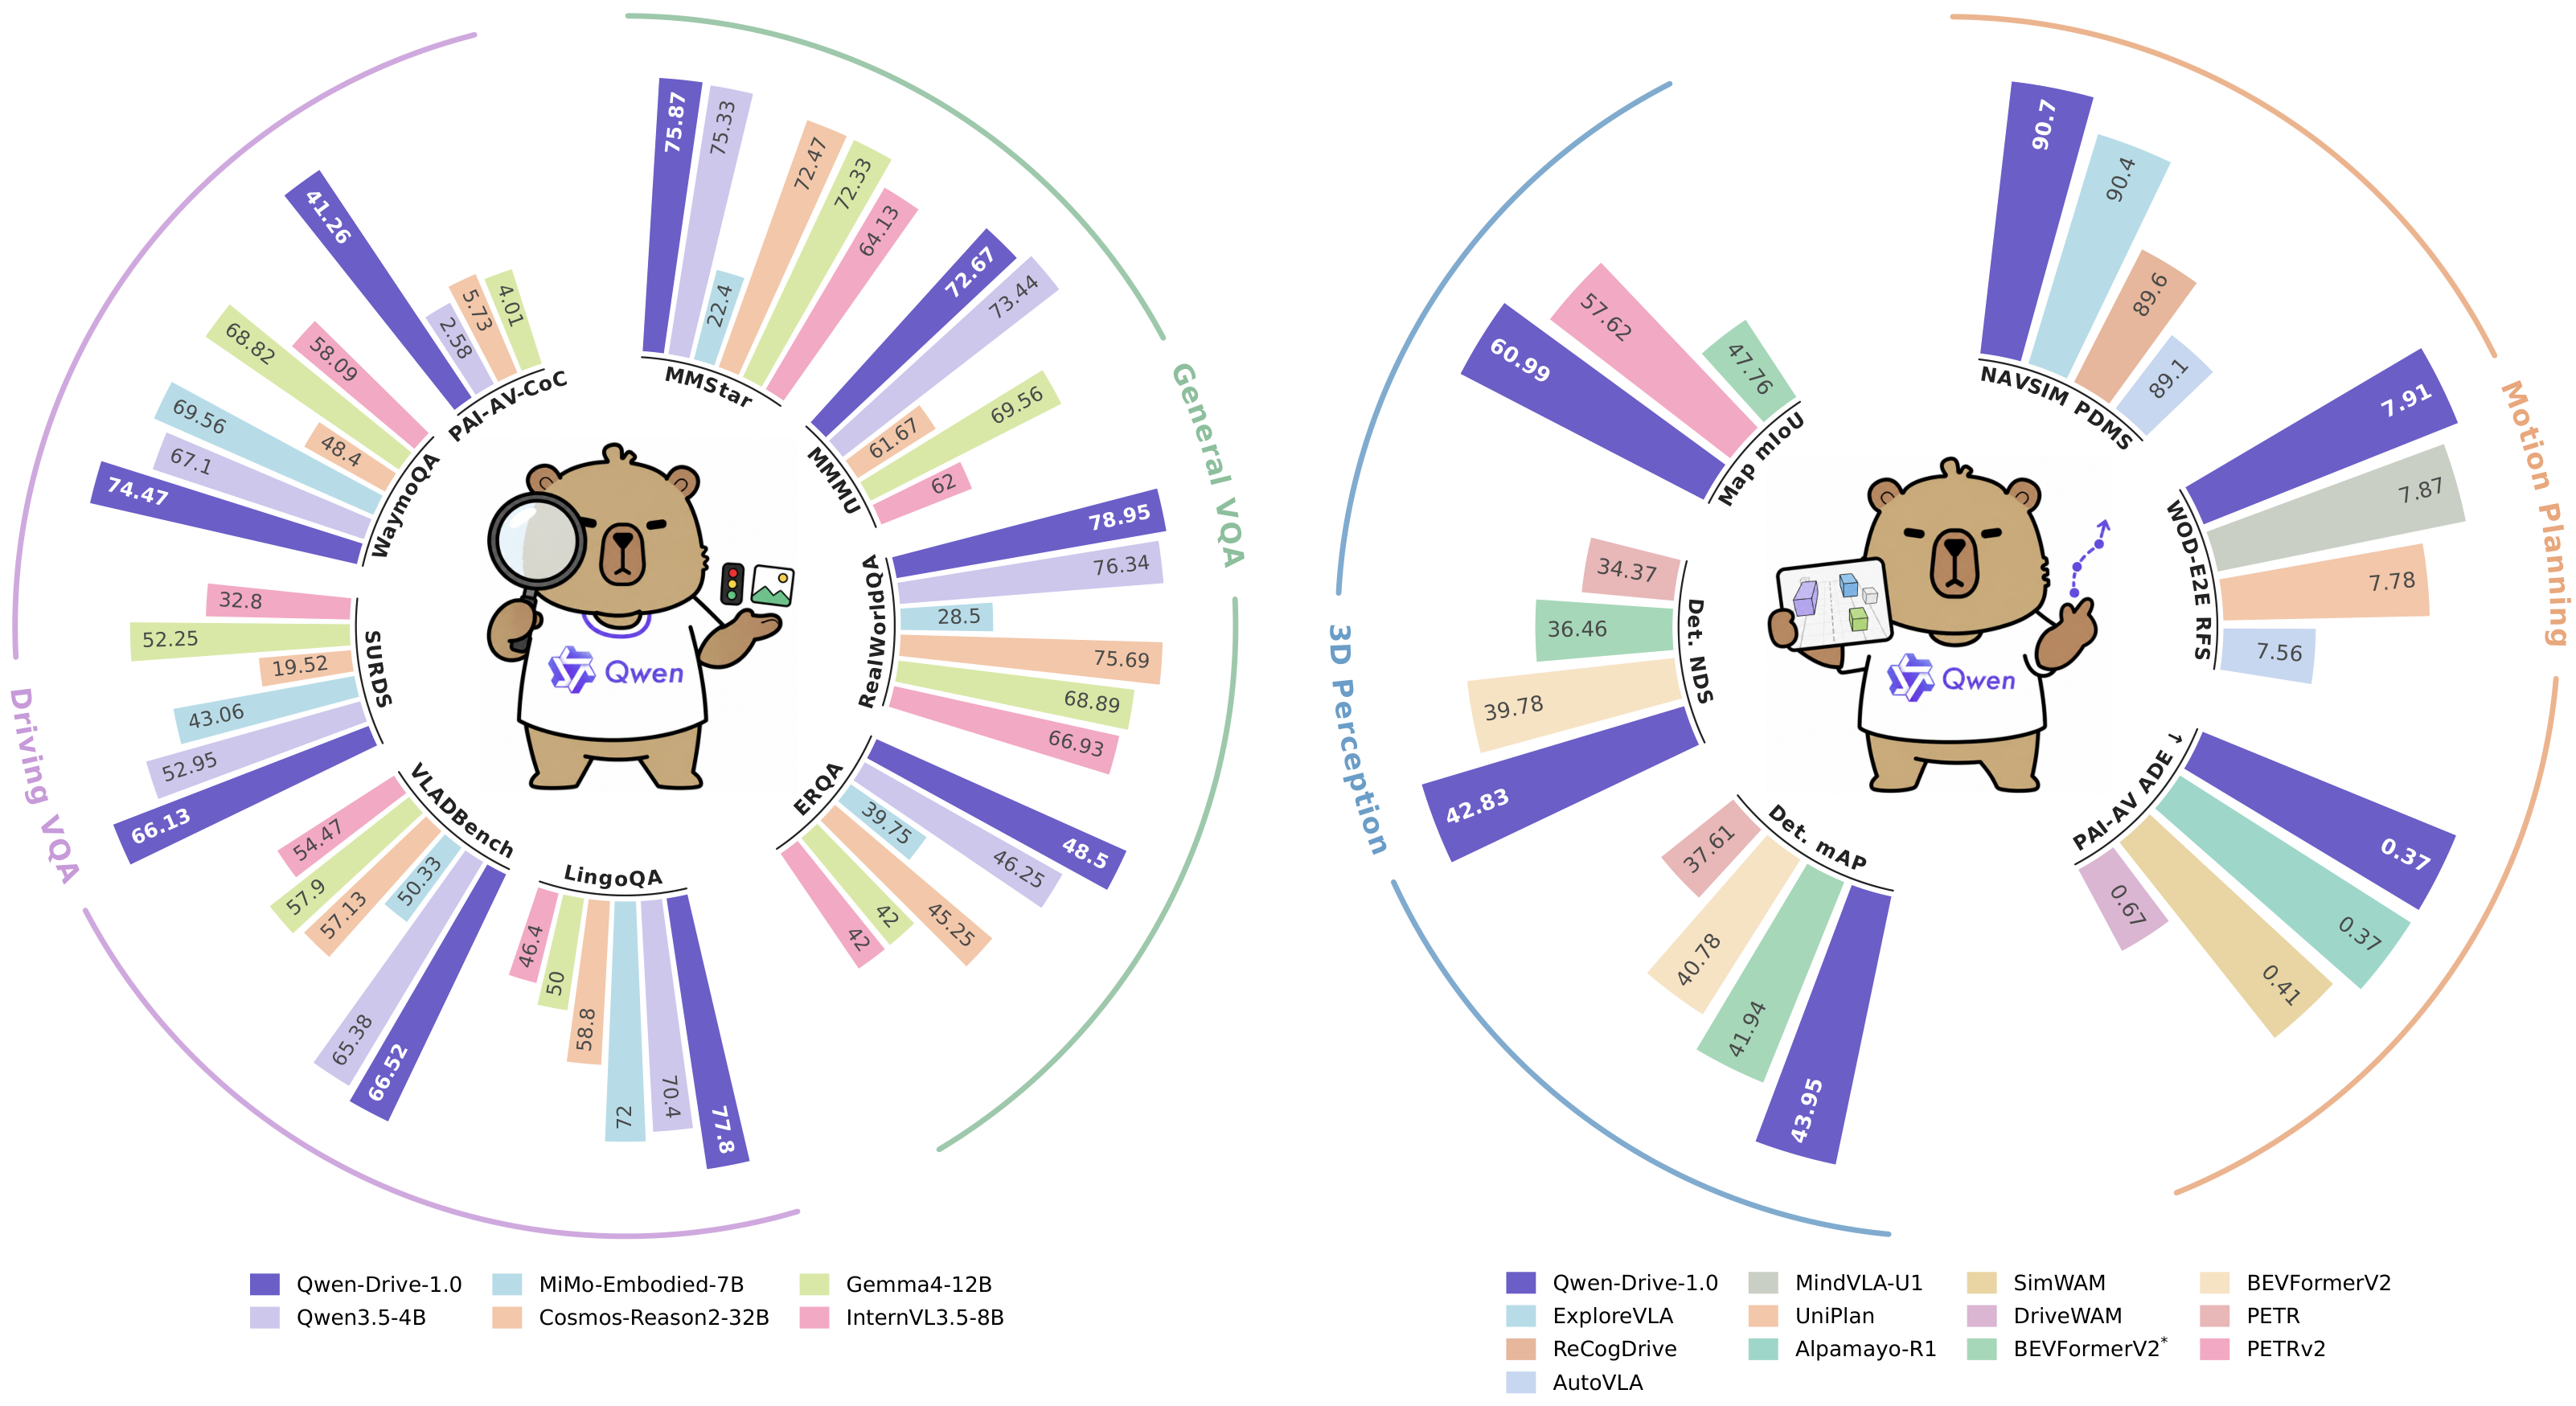
Команда Qwen представила Qwen-Drive 1.0 — исследовательскую vision-language систему для автономного вождения. Она объединяет 3D-восприятие, visual question answering и motion planning, сохраняя архитектуру предобученной Qwen3.5-4B без изменений.
Qwen3.5-4B служит общей VLM. К ней подключены два внешних компонента: BEV Perception Head для 3D-детекции объектов, semantic occupancy и сегментации карты с высоты птичьего полёта, а также Planning Expert, который по общим представлениям VLM строит будущую траекторию автомобиля.
При этом исходный LLM Decoder остаётся отдельным рабочим контуром для General VQA и Driving VQA. В результате одна визуальная основа используется и для свободных ответов о дорожной сцене, и для явного пространственного представления, и для планирования движения.
Почему архитектуру не переделывали
Ключевой инженерный выбор — не встраивать задачи вождения внутрь базовой VLM. Qwen называет Qwen-Drive 1.0 первой vision-language foundation model для автономного вождения, которая объединяет 3D-восприятие и visual question answering уже на этапе pretraining, затем добавляет motion planning и при этом оставляет предобученную архитектуру VLM нетронутой.
BEV-модуль даёт явный и доступный для инспекции интерфейс к структуре 3D-сцены. Это позволяет оценивать не только текстовое объяснение модели, но и отдельные результаты детекции, occupancy и картографической сегментации.
Planning Expert создаёт будущие ego trajectories. В опубликованном примере результат имеет форму `(6, 50, 3)`: шесть вариантов, по 50 точек с координатами `x`, `y` и heading — пять секунд движения с частотой 10 Гц.
Обучение без потери общих навыков
Команда использовала поэтапную схему обучения, которая совмещает задачи восприятия, языка и планирования. Driving-specific supervision смешивается с общими vision-language данными, чтобы специализация на дороге не уничтожила широкие визуальные знания и способность следовать инструкциям.
Единый data pipeline сводит разнородные аннотации восприятия к общему пространству меток, повторно размечает ответы Driving VQA ради единообразия формата и фактической согласованности, а траектории из нескольких публичных наборов приводит к единому waypoint-представлению.
Авторы публикуют результаты для planning, Driving VQA, общего VQA и spatial understanding. Эти цифры являются результатами команды Qwen по указанным протоколам, а не независимой дорожной сертификацией; репозиторий прямо направляет читателя к technical report и документации с полными настройками оценки.
Что именно доступно
Весовой набор Qwen-Drive-1.0-4B размещён на Hugging Face. Корневая VLM занимает 9,1 ГБ; рядом поставляются `planner-sft` и `planner-rl` по 2,1 ГБ, а также модуль `perception` объёмом 0,5 ГБ.
В официальном GitHub-репозитории находятся inference-код, документация и демонстрационные данные. Для запуска рекомендована GPU с памятью от 24 ГБ; demo включает четыре planning-сцены WOD-E2E и шесть perception frames.
`planner-sft` обучен имитацией и поддерживает direct planning и reasoning planning. `planner-rl` оптимизировали наградой только на reasoning-conditioned rollouts, поэтому команда предписывает использовать его в режиме reasoning planning.
Не готовый автопилот, а проверяемая платформа
Название technical report подчёркивает статус проекта: это «первый шаг» к vision-language foundation model для автономного вождения. Официальные материалы описывают исследовательскую архитектуру, benchmark-протоколы, веса и demo, но не заявляют о готовности к самостоятельной эксплуатации автомобиля на дорогах общего пользования.
Практическая ценность релиза — в возможности воспроизводить тесты и разбирать компоненты по отдельности. Исследователи могут сопоставлять ответы VQA, явную BEV-структуру и траектории, а также проверять, сохраняет ли specialised model общие vision-language способности.
Код и модель выпущены по Apache 2.0. Открытая поставка снижает барьер для воспроизводимых экспериментов и позволяет сопоставлять результаты на общей реализации с доступными настройками запуска. Но опубликованные benchmark-результаты не заменяют системную проверку безопасности, переносимости между регионами и поведения в редких дорожных ситуациях.