Технологии
TraceML 0.4.1 переопределила границу замера времени шага в Hugging Face Trainer
30 сентября 2026 года на Hugging Face вышла техническая заметка Абхинава Шривастава о том, как различить нехватку данных и нехватку вычислений в обучении PyTorch-моделей. Автор — участник открытого проекта TraceML, который раскладывает время шага обучения на отдельные фазы и показывает, где именно теряется производительность. В версии 0.4.1 границу замера переопределили: теперь измеряется вся группа оптимизационного обновления целиком, включая перенос тензоров на устройство. В контрольном прогоне на ResNet-50 и одном GPU T4 настроенный профиль загрузчика сократил медианное время обучения на 22,6%.
Почему обычная точка замера пропускала перенос данных
Hugging Face Trainer выполняет часть работы ещё до того, как сработает обычный колбэк шага: он собирает следующий батч — а при включённом накоплении градиентов сразу несколько микробатчей — и Accelerate может переносить эти тензоры на устройство уже на этапе сборки. Если измерение начинается только в колбэке, работа по переносу к этому моменту уже закончена и в отчёт не попадает.
Именно такую ситуацию воспроизвёл участник сообщества Hugging Face под ником John6666: независимые события CUDA фиксировали переносы host-to-device, тогда как TraceML в отчёте показывал H2D: 0.0 ms. Расхождение вскрыло реальный разрыв в интеграции и привело к тому, что границу замера в TraceML 0.4.1 переопределили.
Что изменилось в TraceML 0.4.1
Вместо одного колбэка новая версия отслеживает всю группу оптимизационного обновления. Ожидание DataLoader остаётся отдельным сигналом на стороне CPU; переносы host-to-device привязываются к той группе обновления, которая их потребляет; время прямого и обратного проходов складывается по всем накопленным микробатчам; время работы оптимизатора закрывает группу.
При включённом накоплении градиентов все микробатчи, которые идут в одно обновление, делят один измеряемый шаг TraceML. В повторном бенчмарке накопление было выключено, а пример с четырьмя микробатчами на схеме объясняет устройство реализации, а не служит отдельным результатом производительности.
Как это подключить к Trainer
Интеграция не переписывает существующий цикл обучения: ставится отдельный extra пакета — pip install "traceml-ai[hf]==0.4.1".
Затем один раз инициализируются хуки измерения, а в список callbacks тренера добавляется TraceMLTrainerCallback() — это обычный transformers.TrainerCallback. Минимальный код из заметки: from traceml_ai.integrations import huggingface as traceml_hf, затем traceml_hf.init() и trainer = Trainer(..., callbacks=[traceml_hf.TraceMLTrainerCallback()]) перед trainer.train().
Прогон запускается командой traceml run train.py --mode=summary: она поднимает агрегатор TraceML и обучающий скрипт вместе. В конце печатается разбивка по фазам, и та же телеметрия записывается в final_summary.json — с этим файлом можно сравнивать прогоны после изменения нагрузки, а не полагаться на то, насколько «занятым» выглядел GPU.
Автор отдельно описывает место инструмента: nvidia-smi показывает грубый симптом, torch.profiler даёт таймлайн уровня ядер, а TraceML — лёгкий первый проход, после которого понятно, какую часть обучения копать глубже. Официальная документация уточняет требования: extra «hf» ставит transformers>=4.46.1 и accelerate>=0.26.0, то есть минимальную версию Transformers для автоматического замера времени Trainer.
Контрольный прогон: DataLoader без воркеров
Калибровочным случаем автор выбрал заведомо известное узкое место — DataLoader с нулевым числом воркеров. В эксперименте использовались ResNet-50 и обучающий набор Imagenette в разрешении 320 px, а все прогоны шли с одинаковой ревизией модели, датасетом, seed, размером батча, точностью, 200 шагами оптимизатора, одним GPU T4 и прогретыми кэшами.
Сравнивались два профиля загрузчика: «текущий» — 0 воркеров и выключенное закрепление памяти; «настроенный» — 2 воркера, включённые pinned memory, persistent workers и prefetch factor 2. Настройки менялись как один практический профиль, поэтому эксперимент не приписывает улучшение какому-то одному флагу; порядок профилей чередовался, и каждый повторялся три раза.
Окружение зафиксировано как TraceML 0.4.1, PyTorch 2.11.0, Transformers 5.16.1, Accelerate 1.14.0, FP32 и размер батча 32.
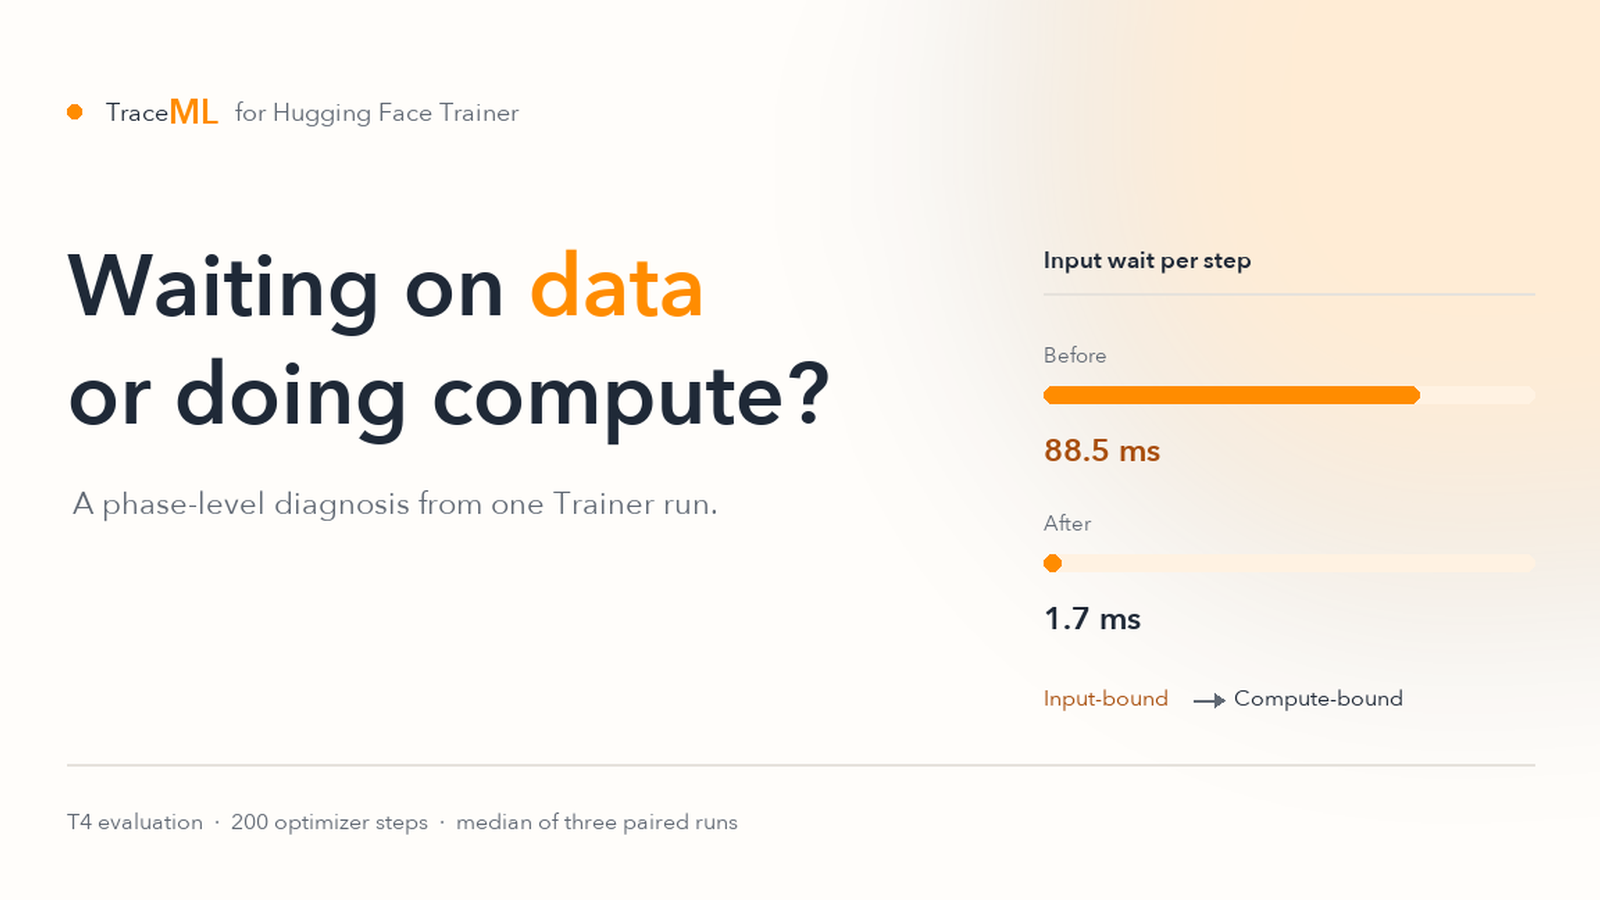
По медиане трёх прогонов время обучения Trainer сократилось с 76.284 до 59.052 секунды (−22.59%), время шага TraceML — с 380.531 до 294.362 миллисекунды (−22.64%), ожидание ввода — с 88.528 до 1.691 миллисекунды (−98.09%), а перенос host-to-device — с 4.065 до 3.170 миллисекунды (−22.02%).
Диагноз до изменения звучал как INPUT-BOUND (CRITICAL): ожидание ввода занимало 23% времени шага, и рекомендация предлагала увеличить воркеры, prefetch или пропускную способность хранилища. После изменения прогон стал COMPUTE-BOUND: вычисления заняли 96% времени шага, крупнейшей фазой оказался обратный проход, и дальше смотреть предлагается на вычисления модели, а не на загрузчик.
Накладные расходы и оговорки
Прежде чем доверять сравнению, автор измерил, насколько сам инструмент меняет прогон: настроенный профиль повторили три раза с включённым и выключенным трейсингом, и медианная разница составила +0.35% по train_runtime и +7.52% по времени всей команды. Полное время команды включает запуск, остановку и генерацию артефактов, поэтому на коротком прогоне в 200 шагов фиксированная работа заметнее.
Диагноз — это не автоматическая оптимизация, а способ выбрать следующий эксперимент. При нехватке ввода стоит проверять воркеры, препроцессинг, кэширование, prefetch и пропускную способность хранилища; при большом времени host-to-device — закрепление памяти, размер переноса и батчи, которые выдаёт препроцессинг; при нехватке вычислений — точность, форму батча, компиляцию и путь forward/backward; при ограничении по памяти — пики аллокаций до увеличения нагрузки.
Ограничения автор проговаривает сам: эксперимент шёл на стандартном HF Trainer с transformers>=4.46.1, а кастомный сбор батчей и отдельные стеки вроде TRL, FSDP и DeepSpeed он просит измерять отдельно.
Что здесь проверяемо, а что — заявление автора
TraceML — не разовая заметка, а открытый проект: репозиторий traceopt-ai/traceml опубликован под лицензией Apache-2.0, а пакет traceml-ai распространяется через PyPI, где версия 0.4.1, о которой идёт речь, выложена 24 сентября 2026 года, а актуальная 0.4.2 — 2 октября 2026 года.
Всё, что касается устройства измерения, кода интеграции и чисел бенчмарка, — это описание и результаты самого автора. Сравнительных замеров против других инструментов профилирования в заметке нет: есть калибровочный эксперимент с одним узким местом, оговорка о том, что профиль загрузчика менялся целиком, и приглашение присылать собственные результаты в issues проекта.
Практический смысл автор формулирует так: разделение времени на ожидание DataLoader, перенос host-to-device, прямой и обратный проходы и работу оптимизатора позволяет решить, что именно менять в текущем прогоне, вместо перебора настроек наугад.
Первоисточники
- Hugging Face — Abhinav Srivastav, «Diagnosing a slow Hugging Face Trainer run: data loading or compute?» (Community Article, 30 сентября 2026)
- TraceML — официальная документация, интеграция с Hugging Face Trainer
- TraceML — официальный репозиторий проекта (traceopt-ai/traceml, лицензия Apache-2.0)
- PyPI — пакет traceml-ai, история релизов (0.4.1 от 24 сентября 2026, 0.4.2 от 2 октября 2026)