Технологии
«Из провалов модели — в учебный план»: ServiceNow CoreAI показала AutoSynthData для агентов в корпоративных средах
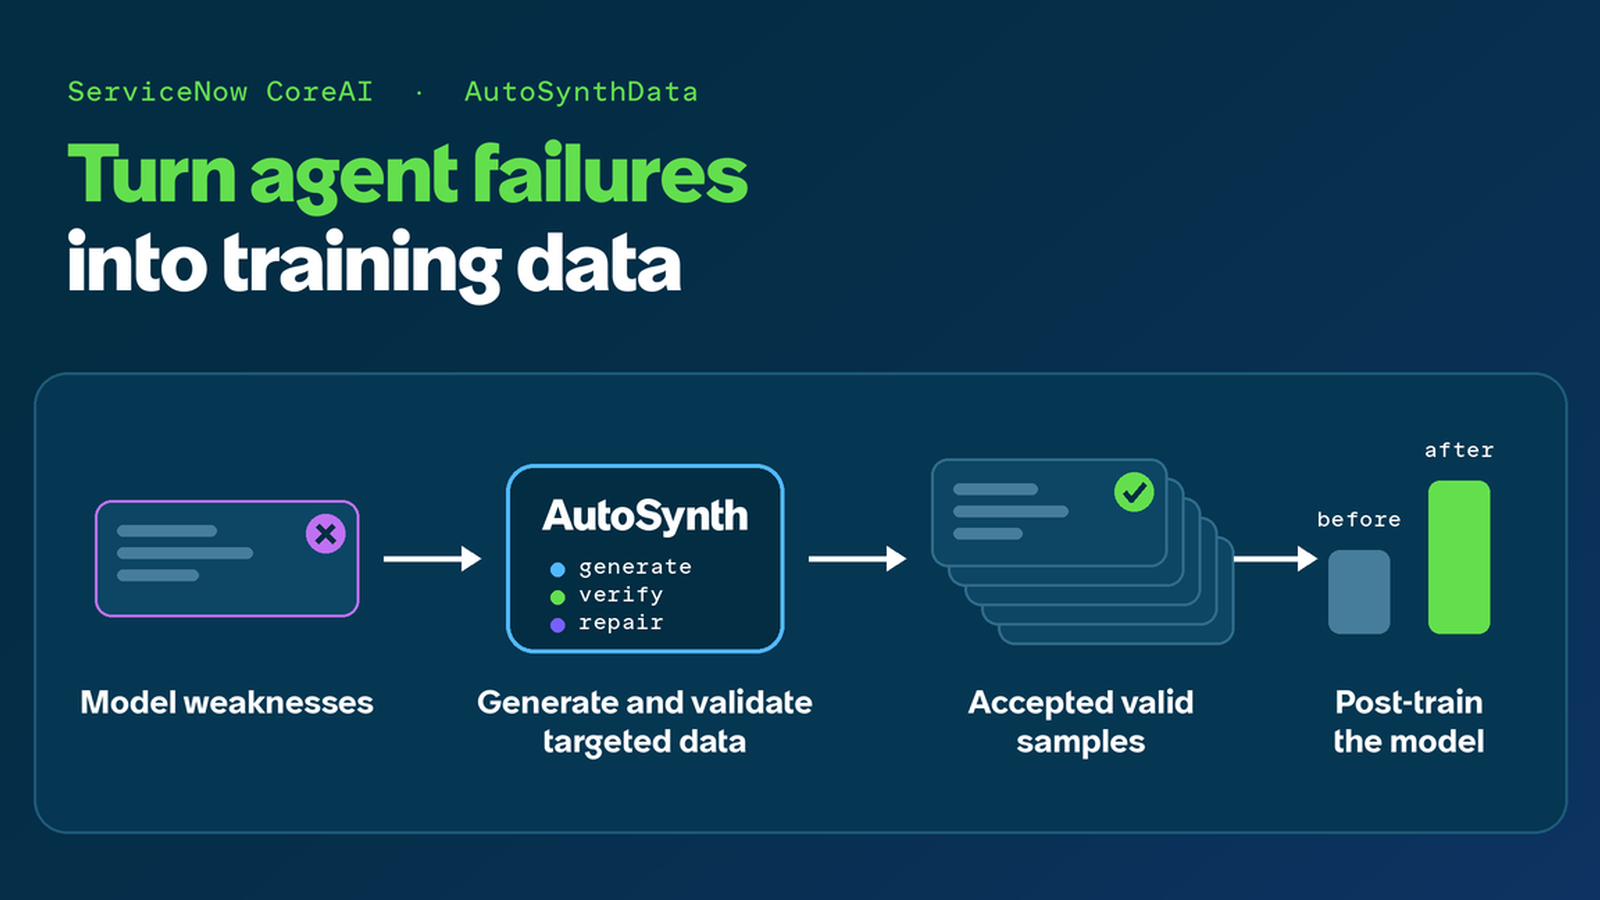
2 октября команда ServiceNow CoreAI описала AutoSynthData — конвейер, который берёт слабые места целевой модели и превращает их в новые обучающие задачи для агентов в корпоративных средах. Генерация идёт от «карточек способностей», без доступа к исходным промптам и траекториям, а готовые задачи отбираются проверками и точечным исправлением. В экспериментах на EnterpriseOps Gym 2 000 синтетических примеров подняли средний Pass@1 модели Gemma-4-26B-A4B-it на 7,2 процентного пункта.
Ограничение обычных синтетических данных
Публикация начинается с вопроса, что делает агентную задачу действительно полезной для обучения.
Авторы напоминают: наборы, собранные без опоры на слабости конкретной модели, легко скатываются к простым и повторяющимся задачам, которые не двигают способности агента.
При этом задача, корректная сама по себе, может оказаться неисполнимой в целевом окружении, её эталонное решение — не запускаться, а проверяющая программа — награждать не то конечное состояние.
AutoSynthData ставит цель иначе: не «сгенерировать побольше задач», а найти задачи вблизи границы возможностей целевой модели — достаточно трудные, чтобы вскрывать слабости, и достаточно решаемые, чтобы более сильный учитель дал надёжную демонстрацию.
Что делает задачу пригодной для обучения
Каждая задача в подходе раскладывается на три части: спецификацию системы, пользовательский промпт и верификатор.
От кандидата требуются три свойства: исполнимость — решение действительно выполнимо в целевом окружении, реализм — сценарий похож на настоящую рабочую ситуацию, и сложность — задача попадает в нужный диапазон трудности.
У верификатора свои три требования: согласованность с состоянием среды, корректность и полнота.
AutoSynthData проверяет эти свойства до того, как задача попадёт в обучающий набор.
Как устроен конвейер
Сначала диагностическая оценка определяет, где модель ошибается; успехи более сильного учителя на тех же участках подсказывают, чему её учить.
Затем слабости превращаются в «карточки спецификаций способностей» — они описывают, какой навык должен тренироваться, и не несут ни исходных промптов, ни траекторий, ни критериев оценки.
Генерация идёт в два приёма: целевая фаза создаёт базовые задачи, а фаза «умножения» расширяет их в новые варианты.
По умолчанию авторы берут задачи, которые целевая модель решает не более чем в одном случае из трёх попыток, а более сильный решатель — минимум в двух из трёх.
Проверка и исправление
Положительная проверка спрашивает, решает ли предполагаемое решение поставленную задачу: конвейер выполняет эталонную траекторию в целевом окружении и сверяет результат с верификатором кандидата.
Отрицательная проверка спрашивает обратное — действительно ли неверные исходы не проходят: часть ожидаемого результата мутируют и убеждаются, что проверка его больше не принимает.
Провалившиеся кандидаты не выбрасываются сразу: критик ищет в них несогласованное состояние, невыполнимые сценарии, ошибки построения задачи, плохие эталонные траектории или слабую логику проверки.
Дальше идёт точечный ремонт, и исправленная задача проходит все проверки заново; на число попыток есть фиксированный лимит.
Контроль на уровне партии
Даже по отдельности корректные примеры могут сложиться в однообразный и несбалансированный набор.
Мета-обзор смотрит на принятые и отклонённые образцы сразу по партии: какие семейства задач перепредставлены, какие способности не затронуты, не повторяются ли одни и те же примеры, не проваливается ли генерация на одних и тех же целях.
Контроллер следит за покрытием: сокращает генерацию на перепредставленных участках и перераспределяет усилия в пробелы.
Так балансируются полезный сигнал, качество задач, покрытие, разнообразие и низкая избыточность в рамках доступного бюджета генерации.
Результаты на EnterpriseOps Gym
Подход проверяли в EnterpriseOps Gym — среде с состоянием, где для корпоративных задач выделены домены Hybrid и ITSM.
В домене Hybrid целевой моделью была Gemma-4-26B-A4B-it, учителем — Qwen3.8-27B; конвейер сгенерировал 2 000 синтетических примеров примерно за 18 часов, лучшей контрольной точкой оказалась пятая эпоха.
Синтетический SFT-чекпойнт поднял средний Pass@1 на 7,2 процентного пункта — это 35% относительного улучшения, а успех верификатора вырос с 63,01% до 68,55%; так закрылось 59% исходного разрыва по Pass@1 между Gemma и референсной моделью.
Обучающие задачи генерировались заново из спецификаций способностей: генератор не получал исходные оценочные задачи.
В домене ITSM — с той же целевой Gemma-4-26B-A4B-it и учителем DeepSeek-V4.1-Flash — конвейер сделал 1 994 примера за 66 часов, а средний Pass@1 вырос с 18,77% до 27,18%.
Авторы поясняют, что ITSM-прогон занял больше времени из-за более крупного учителя и того, что он шёл до оптимизаций, которые позже ускорили конвейер.
Что подтверждено, а что — заявление команды
Все приведённые числа — результаты самих авторов внутри одного окружения EnterpriseOps Gym и в конфигурации дообучения с учителем; независимого воспроизведения публикация не приводит.
Разницу между ITSM- и Hybrid-прогонами авторы объясняют не только доменом, но и инженерными оптимизациями между запусками, поэтому её нельзя читать как чистый эффект метода.
Заявка на обучение с подкреплением пока остаётся планом: цель — генерировать задачи, которые бросают вызов текущей политике, тренировать, а затем сдвигать цель генерации вслед за обновлённой моделью.
Главная мысль публикации проста: наборы для агентов в корпоративных средах стоит строить от текущих слабостей модели, а не от объёма сгенерированного текста.