Технологии
«Инференс — это ещё не конец конвейера»: открытый Reef учит агента на живом трафике
15 сентября 2026 года на Hugging Face вышла статья команды Reef: авторы открыли исходный код инфраструктуры для непрерывного самоулучшения агентов. Обучение в ней ставится поверх живого сервинга, обновляются и модель, и harness, а каждый кандидат проходит оценку и попадает в аудируемую цепочку релизов.
Что открыли
15 сентября 2026 года на Hugging Face вышла статья «Your Inference Server is Secretly a Learner: Reef Infrastructure for Continual Self-Improving Agents». Её подписали девять авторов: Ao Qu, Bo Liu, Han Zheng, Zhou Zijian, Xuan Jiang, Simon Yu, zoedusy, kaichen-z и XINKAI ZOU. Публикация помечена как Community Article: это материал сообщества Hugging Face, а не анонс самой платформы.
Авторы открывают Reef — инфраструктуру, которая должна позволять агентам (harness + model) непрерывно развиваться на собственном опыте. Сами они используют «continual self-improvement» как более широкую и практичную рамку, чем RSI. Место для более рекурсивных форм самоулучшения авторы при этом оставляют.
Код проекта открыт в репозитории Human-Agent-Society/reef под лицензией Apache-2.0. Там лежат инструкции по запуску, конфигурации и примеры рецептов, а документация проекта — на reefinfra.ai. На момент проверки у репозитория около 1,7 тыс. звёзд и 108 форков.
Почему авторы пересобирают конвейер
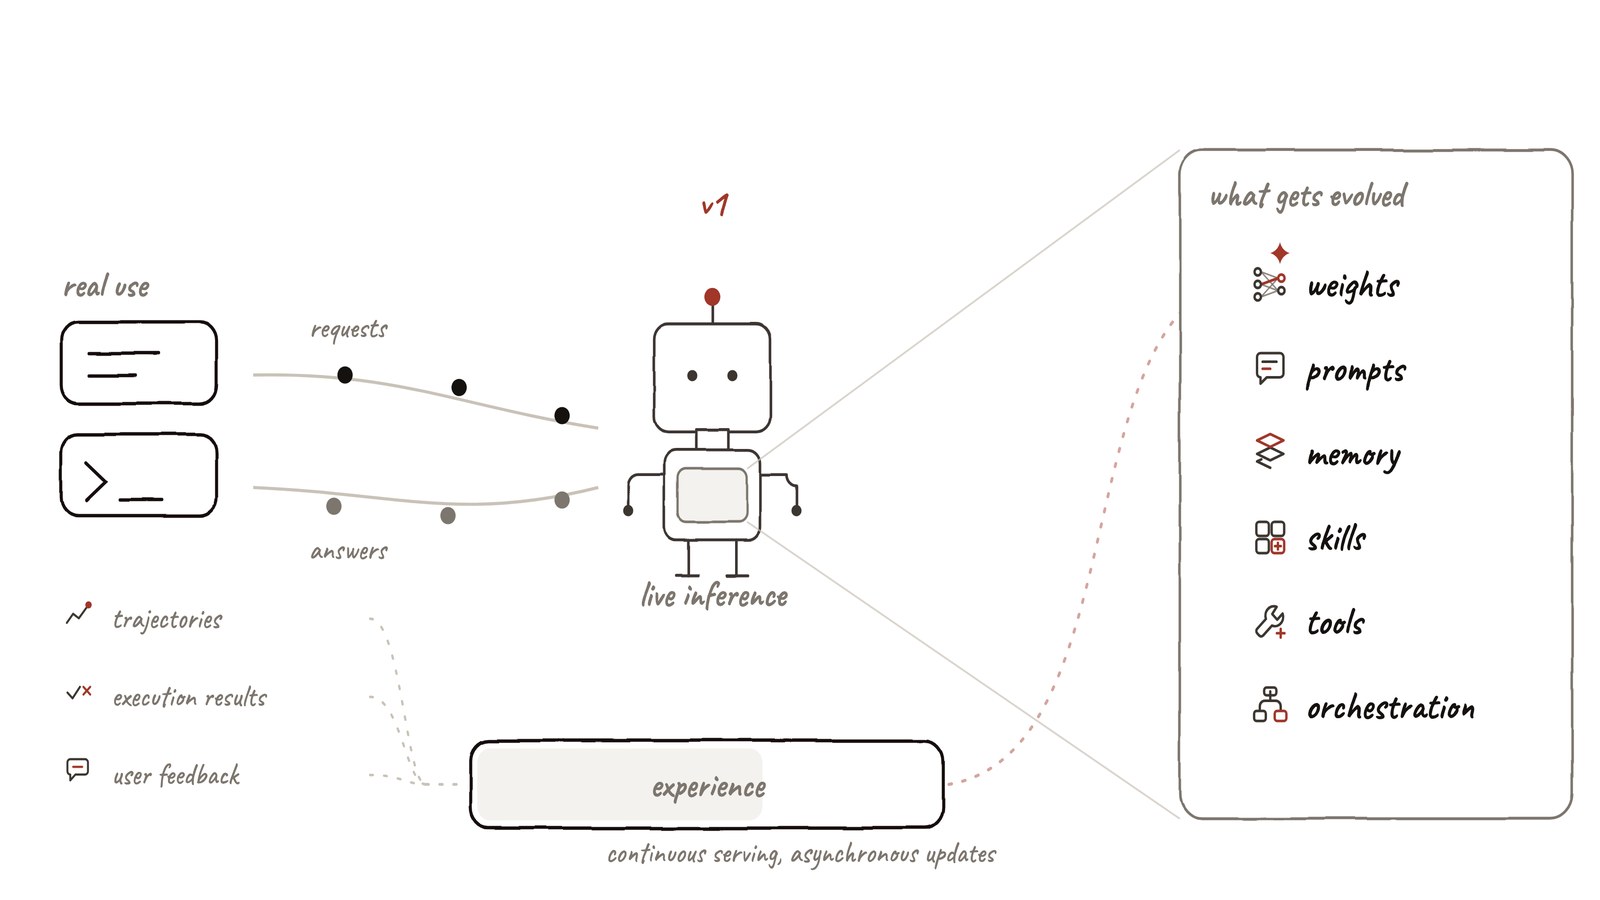
Отправная точка статьи — два допущения привычного жизненного цикла LLM: обучили, оценили, развернули, обслуживаем. Первое, по мнению авторов, больше не держится: inference перестаёт быть концом конвейера. Агенты во время работы порождают траектории, результаты исполнения и обратную связь — и это уже не выбрасывается, а становится частью обучения.
Второе: меняется не только модель. Промпты, память, навыки, инструменты и логика оркестрации тоже могут улучшаться на опыте, причём модель и harness усиливают друг друга.
Из этого вырастает непрерывная петля. Агент взаимодействует, накапливает опыт, меняет разные части себя, проверяет, стоит ли оставлять изменения, и возвращается в сервинг новой версией.
Отсюда и главное отличие Reef от RL-инфраструктуры. Проекты вроде Slime и veRL встраивают inference-движок, чтобы генерировать данные, но рассчитаны на обучение, а не на обслуживание. Вывод авторов — инфраструктура непрерывного самоулучшения должна быть сначала inference-инфраструктурой, а обучающую способность строить вокруг живого трафика.
Три зоны ответственности: опыт, агент, обновления
Требование к такой инфраструктуре авторы формулируют как «владеть тремя вещами от начала до конца»: опытом, агентом и обновлениями. Это значит учиться на живом трафике, обновлять и модель, и harness, а также оценивать, версионировать и контролировать выпуск обновлений.
На стороне опыта Reef даёт обычные inference-эндпоинты: вызов в формате OpenAI через /v1/chat/completions, причём идентификатор записи возвращается в заголовке x-reef-agent-record-id. К этой записи приложение может приложить награду или оценку проверяющего отдельным вызовом /reef/report.
Ключевое отличие от статичных inference-движков авторы называют stateful inference. Трассы и обратная связь складываются в структурированный поток опыта, а система сама решает вопросы устаревания off-policy, склейки сессий и дедупликации. Как этот поток обрабатывать, какой алгоритм обучения применять и когда оценивать обновление, задаёт рецепт.
Что обновляется: модель и harness
Harness в Reef обновляется отдельно: в роли «тренировочного бэкенда» выступает Cordis. Рецепт эволюции анализирует траектории и обратную связь и предлагает правки.
Готовую версию пользователь получает как устанавливаемое обновление — например, командой curl к локальному сервису Reef на порту 8900 с параметром adapter=pi. После этого трафик обёрнутого harness Pi идёт уже через stateful-эндпоинт Reef.
На стороне модели рецепты читают записи Reef и обновляют веса: обучение идёт асинхронно с живым сервингом на распределённом бэкенде, адаптированном из Slime, и даёт кандидатов вроде чекпоинтов или LoRA-адаптеров. Если кандидат прошёл оценку, Reef публикует его как новую версию артефакта и горячо подменяет веса в обслуживающем движке через синхронизацию по NCCL — без перезапуска сервиса.
Почему релизы проходят через оценку
Авторы исходят из того, что эволюция не обязана улучшать качество. Поэтому каждый кандидат оценивается до релиза: отклонённый не меняет сервинг, принятый публикуется как новый аудируемый релиз. Чекпоинт, LoRA-адаптер, дерево harness или политика маршрутизации описываются как артефакт под управлением версионного контроллера, а для тяжёлых артефактов вроде весов используется Git LFS.
У каждого сценария своя цепочка релизов — только на добавление. Указатель на текущий релиз сдвигается через compare-and-swap, так что устаревший публикатор не может перезаписать более новый релиз.
Рецепты вместо одной кнопки
Логика улучшения вынесена в модульные learning recipes. Авторы описывают общий шаблон для всего «зоопарка» методов — online reinforcement learning, test-time training, эволюции навыков и harness, self-play.
Сигнал, полученный во время работы, превращается в обновление той системы, которая породит следующее взаимодействие. Различаются рецепты по трём осям: откуда берётся обучающий сигнал, как добывается опыт и что именно меняется — модель, harness или оба.
Подключение рецепта описано как правка конфигурации. В serve.yaml указывается, например, recipes.sao.recipe:SAORecipe вместе с размером батча и допустимым устареванием, после чего сервис запускается командой reef serve -c. В публикации разобраны два примера — OpenClaw-RL и TTT-Discover — с разными стратегиями эволюции, но на одной инфраструктуре.
Как читать эту публикацию
Это статья сообщества и презентация собственного проекта, а не рецензируемое исследование. Измеримых результатов, сравнений с другими стеками и внешнего аудита в ней нет, а механизмы вроде горячей подмены весов описаны архитектурно. Проверять заявления стоит по коду и документации репозитория.
Отдельная оговорка авторов: Reef задуман для более широкой задачи, чем полностью рекурсивное самоулучшение, и оставляет место для более рекурсивных форм «поверх» себя.
Что дальше, видно по репозиторию: он активно обновляется, в нём есть роадмап, документация, примеры рецептов и Discord для обсуждений, а вклад сообщества приветствуется.