Технологии
Perplexity открыла Lily — специализированный inference engine для Apple silicon
Rust-runtime и custom Metal kernels запускают Qwen3.6-35B-A3B без PyTorch и MLX в execution path. На M5 Max Perplexity измерила в среднем 1,23× throughput в prefill и 1,35× в decode относительно MLX-LM.
Локальная часть Hybrid Compute получила собственный движок
Perplexity представила Lily — компактный inference engine для Apple silicon и одной конкретной модели, Qwen3.6-35B-A3B. Он используется в схеме Hybrid Compute: облачные модели выполняют research и reasoning, а локальная модель работает с приватными файлами и приложениями на Mac. Чтобы разделение не ощущалось как пауза между двумя системами, локальному runtime нужны быстрый prefill длинного запроса и устойчивый темп генерации.
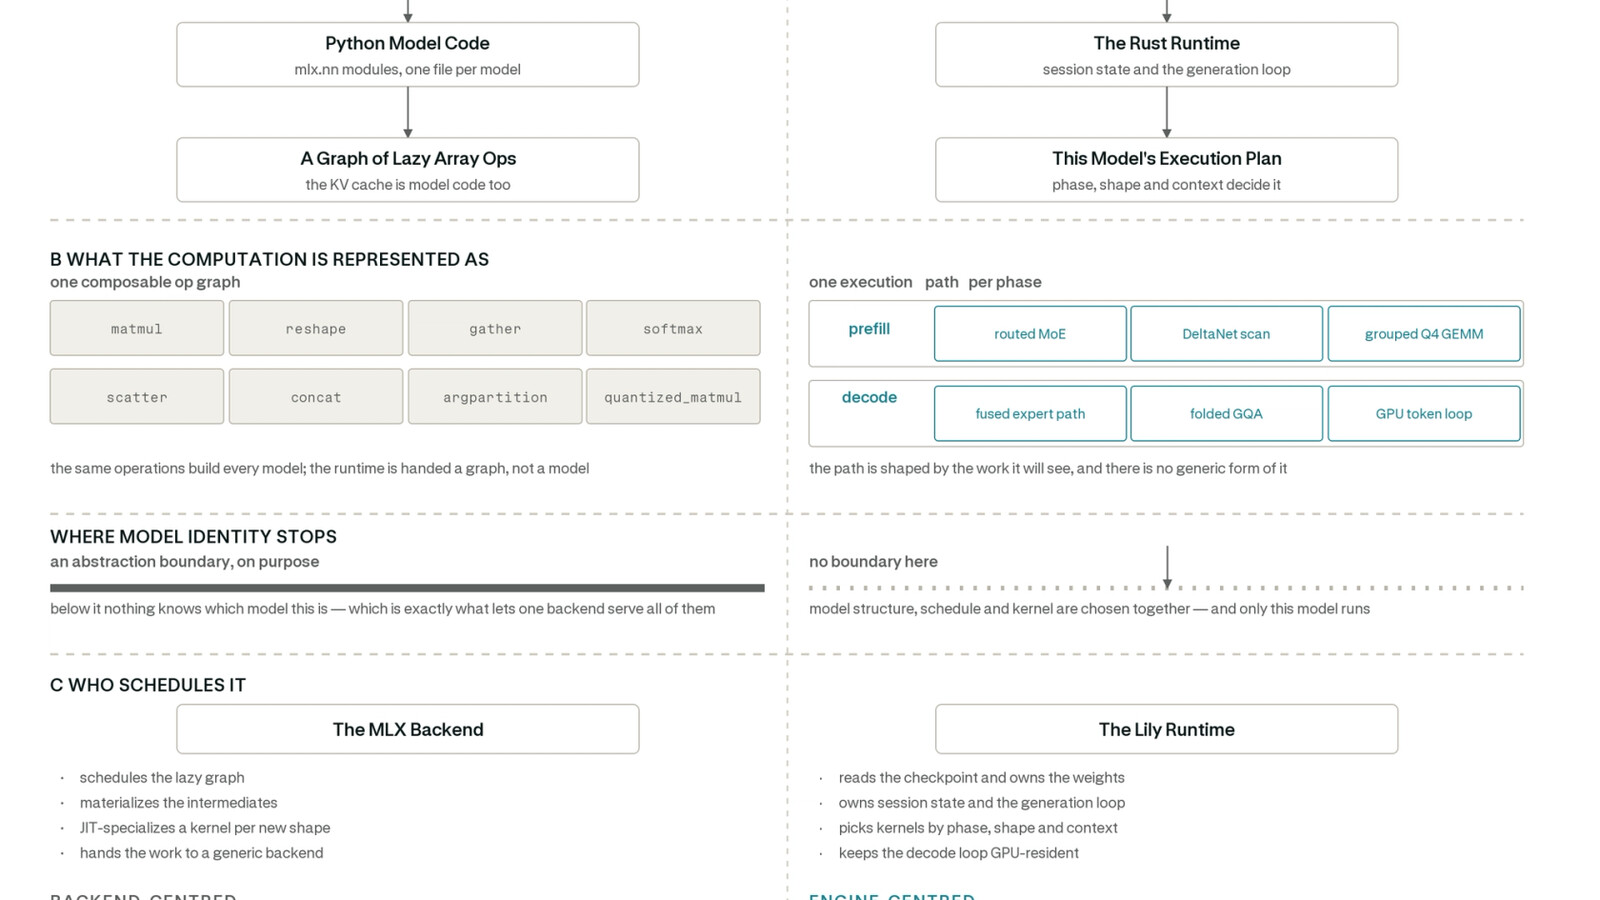
Компания опубликовала standalone-демонстрацию Lily в своём репозитории pplx-garden. Это не универсальная замена MLX-LM: реализация намеренно ограничена одной архитектурой, одним форматом 4-bit checkpoint и новыми поколениями Apple GPU. Узкая специализация позволяет заранее знать структуру модели и координировать kernels, перемещение данных и scheduling без общего слоя для множества моделей.
Rust управляет моделью, Metal выполняет вычисления
Lily работает в одном процессе. Rust-runtime загружает checkpoint, хранит состояние сессии и ведёт generation loop; OpenAI-compatible chat-completions API принимает запросы; специальные Metal kernels исполняют операции Qwen. PyTorch и MLX не находятся в execution path — в отличие от MLX-LM, где модель выражена через переиспользуемые MLX array operations.
Такой дизайн уменьшает число уровней абстракции, но делает движок существенно менее гибким. README прямо указывает поддержку только Qwen3.6-35B-A3B в MLX affine 4-bit с group size 64; dense, BF16, GGUF, AWQ, GPTQ, int8 и fp8 checkpoints не принимаются. Lily проверяет архитектуру и layout квантования во время загрузки, предпочитая ранний отказ попытке запустить несовместимую модель.
Prefill и decode оптимизируются как разные режимы
Perplexity отдельно измеряет обработку входного prompt и генерацию следующих токенов. Qwen3.6-35B-A3B сочетает mixture-of-experts routing, recurrent states и full attention, поэтому нагрузка нерегулярна: токены обращаются к разным expert weights, а recurrent state обновляется последовательно. Специализированный execution plan может учитывать эти особенности вместо того, чтобы собирать запуск из универсальных операций.
Тестирование проводилось на одном MacBook Pro с M5 Max, 40-core GPU и 128 ГБ unified memory. На десяти длинах prompt и десяти длинах decode context от 256 до 128K токенов Lily в среднем показала 1,23× throughput MLX-LM для prefill и 1,35× для decode. Это результаты авторов движка на одной модели и конфигурации, а не обещание такого же ускорения для другого Mac или workload.
OpenAI-compatible означает только небольшой совместимый слой
Сервер предоставляет POST /v1/chat/completions, GET /v1/models и GET /health. Но поверхность API намеренно строгая: поддерживаются текстовые system, user и assistant messages, max_tokens, stream: false и необязательный prompt_cache_key. Streaming responses, tools, multimodal content, response formats, sampling parameters и speculative decoding отвергаются.
Генерация всегда greedy, а thinking в шаблоне checkpoint отключён. Поэтому совместимость полезна для подключения простого chat-клиента, но не делает Lily drop-in backend для произвольного agent-приложения. Перед интеграцией нужно проверить не только формат endpoint, но и используемые приложением параметры, tool calling и ожидания от streaming.
Prefix cache рассчитан на повторяющиеся диалоги
Lily хранит два decode state в LRU cache. Состояние переиспользуется только тогда, когда сохранённая token sequence является строгим префиксом нового prompt; совпадение prompt_cache_key лишь помогает выбрать запись и не отменяет проверку токенов. Это ограничивает риск ошибочного смешения разных разговоров, одновременно экономя повторную обработку общей части истории.
Максимальная общая длина prompt и completion задаётся через --max-seq, не может превышать kernel limit в 262 144 токена и дополнительно ограничивается max_position_embeddings checkpoint. Большой теоретический предел не равен гарантии одинаковой скорости: с ростом контекста меняются объём состояния, пропускная способность памяти и задержка до первого токена.
Открытый код делает benchmark воспроизводимым, но не универсальным
Репозиторий включает Rust и Metal source, CPU-reference tests, API tests, shader compilation test, prefix-cache tests и отдельные сценарии, требующие полного 35B checkpoint. В README зафиксирована конкретная ревизия 4-bit модели, использованная для release benchmark, а performance reports содержат measurement contract и шаги воспроизведения. Это позволяет проверять заявленные цифры точнее, чем по одной диаграмме в анонсе.
Главный компромисс Lily прозрачен: скорость приобретается ценой широты поддержки. Для Hybrid Compute Perplexity это разумная инженерная ставка, потому что hardware и checkpoint заранее выбраны; для общей локальной платформы ограничения могут оказаться слишком жёсткими. Практическая оценка должна включать собственные prompt distributions, время prefill, decode throughput, память и совместимость API — отдельно от среднего ускорения в авторском benchmark.