Технологии
Perplexity раскрыла GPU-стек для быстрых embeddings: Ivy, Tulip и ROSE
Единый inference-контур обслуживает batch и online embeddings, лениво захватывает CUDA graphs и перекрывает работу CPU и GPU через LazyTensor.
Embeddings как отдельный профиль нагрузки
Perplexity описала внутреннюю инфраструктуру, на которой запускает embedding- и ranking-модели для Search, Computer и API Platform. Эти модели превращают документы и запросы в векторы, а затем помогают находить и ранжировать результаты; компания связывает этот контур в том числе с собственным pplx-embed и exabyte-scale поисковым индексом.
Один и тот же класс моделей должен выдерживать два разных режима. При построении или обновлении индекса batch embedding требует максимальной пропускной способности для больших массивов документов, а online embedding должен с минимальной задержкой обработать короткий запрос. После vector search отдельно возникает крупнопакетное scoring-нагружение, где важен баланс throughput и latency.
Perplexity сближает эти режимы с уже существующим LLM inference: большие batch embeddings похожи на compute-bound prefill, а короткие online-запросы — на memory-bound decode. Поэтому инфраструктура повторно использует оптимизированные prefill- и decode-kernels вместо отдельного полностью независимого стека для embeddings.
Три слоя: Ivy, Tulip и ROSE
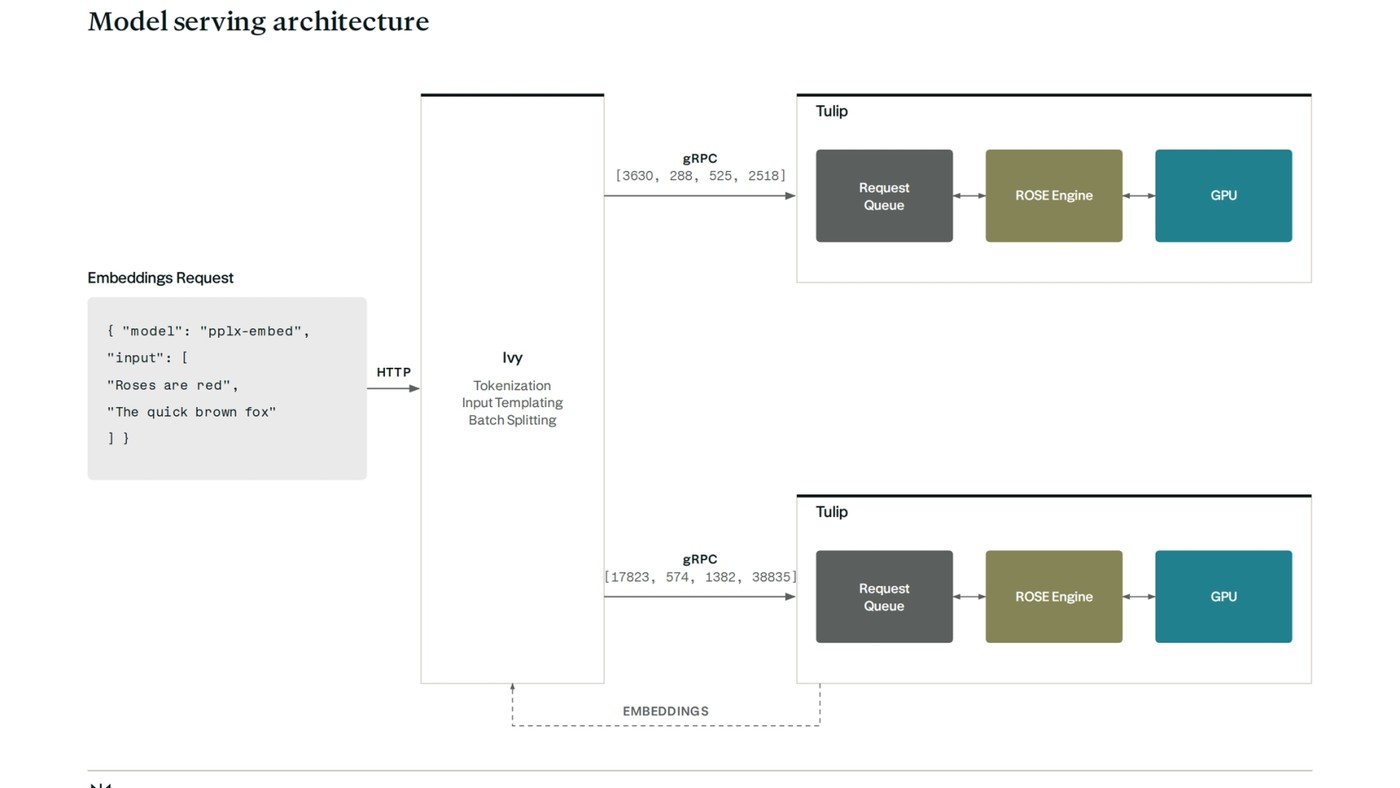
Внешний запрос сначала принимает Ivy — HTTP gateway на Rust. Он выполняет CPU-часть: разбирает JSON, токенизирует текст, применяет input templates, разбивает большие batch-запросы и переводит их в собственный gRPC-протокол для downstream-серверов. Параметры входной подготовки можно менять, не затрагивая тяжёлые inference instances.
Tulip — gRPC server interface на Rust, Tokio и Tonic. Он принимает inference-запросы, накапливает их, формирует batch и передаёт работу движку ROSE. Планировщик намеренно прост: ожидающие последовательности выбираются в порядке поступления, пока accelerator выполняет предыдущую работу.
ROSE реализует model inference преимущественно на Python и содержит kernels, layers, определения моделей и управление CUDA graphs. Связь с Tulip сведена к функции step(), которая принимает batch и возвращает ссылку на вычисление accelerator. Такая граница оставляет сетевое планирование в Rust, а модельную часть — в более гибком Python-слое.
Почему размер batch измеряется токенами
Для небольших embedding-моделей на используемых длинах последовательности Perplexity наблюдает доминирование линейной стоимости dense layers над квадратичной стоимостью attention. Из этого следует практическое правило: latency в основном зависит от числа токенов, а не от числа последовательностей в batch.
По измерениям компании, модель меньше миллиарда параметров насыщает GPU примерно на 512 токенах. После этой точки добавление новых последовательностей в уже достаточно крупный batch почти не повышает эффективность. Планировщику поэтому не требуется сложная оптимизация упаковки ради каждого дополнительного запроса.
На малых batch CPU-side запуск kernels может занимать больше времени, чем собственно GPU-работа. Для training или reindexing этот overhead скрывается крупными вычислениями, но в online-serving он напрямую увеличивает latency, поэтому основная оптимизация сосредоточена вокруг сокращения host launches и перекрытия стадий.
CUDA graphs захватываются только по мере надобности
Whole-model CUDA graph сохраняет метаданные всех kernel launches и позволяет запускать forward pass одним вызовом CUDA driver, не повторяя дорогой Python- и PyTorch-код. Perplexity использует такие graphs для всех embedding-моделей и, пока GPU выполняет текущий batch, готовит и ставит в очередь следующий.
Полный набор конфигураций заранее захватить дорого: для embeddings отдельный graph нужен сочетанию числа последовательностей и числа токенов. Токены округляются до buckets, кратных 64 или 256, но даже после этого получаются тысячи graphs и несколько минут startup work.
Компания выбрала lazy capture. Новая конфигурация сначала проходит eager warmup, при втором попадании захватывается graph, а все следующие запросы используют replay. Это временно влияет на p99 после запуска, зато распределяет минуты подготовки по часам и позволяет быстрее масштабировать deployment.
LazyTensor перекрывает CPU и GPU
CUDA выполняет GPU-работу асинхронно, но обычному host-коду пришлось бы синхронизироваться перед чтением результата. В ROSE объект LazyTensor вместо немедленного ожидания отслеживает page-locked host buffer и cudaMemcpyAsync через event; событие означает одновременно завершение forward pass и доступность результата на CPU.
Теперь step() возвращает LazyTensor сразу после запуска CUDA graph. Rust-задача может дождаться результата асинхронно, а система тем временем готовит следующий batch. В сочетании с graphs это убирает лишние паузы между CPU-подготовкой, GPU-execution и копированием результата.
ROSE при этом сохраняет общие kernels для embeddings и LLM: dense layers исполняются одинаково, а attention получает ragged-варианты без KV cache и лишнего padding. Ivy дополнительно делит крупные запросы между replicas, а выбор между FlashInfer 2, FlashInfer 3 и FlashAttention 4 делается по форме модели и размеру задачи.
Что показывают и чего не показывают benchmarks
Perplexity сравнивала свой стек с vLLM v0.22.0 на BF16, реальных model weights и входах из evaluation datasets. Перед timing runs выполнялись warmup-проходы с проверкой, что расхождение cosine similarity остаётся в пределах 0,1%; отдельно измерялись sequential latency, scoring, high-throughput batch и высокая concurrency с учётом Ivy tokenization и сетевого overhead.
В публикации вывод сформулирован как более низкая latency и более высокий throughput относительно off-the-shelf решений, но численные значения находятся на графиках и привязаны к конкретным batch sizes, sequence lengths и kernels. Их нельзя автоматически переносить на произвольную модель, GPU или профиль трафика.
Главный инженерный результат не сводится к одному kernel. Perplexity совместила Rust gateway и scheduler, Python model engine, whole-model CUDA graphs, lazy result tracking и балансировку replicas. Такой вертикальный контроль позволяет оптимизировать полный путь запроса, а общая кодовая база с LLM-serving снижает стоимость поддержки embeddings.