Технологии
Jalapeño: OpenAI показала первый собственный чип для быстрого AI inference
OpenAI заявляет преимущество Jalapeño одновременно по throughput на ватт и latency на трёх публичных моделях, раскрывает 700-ваттный рейтинг чипа и планирует начать deployment до конца 2026 года.
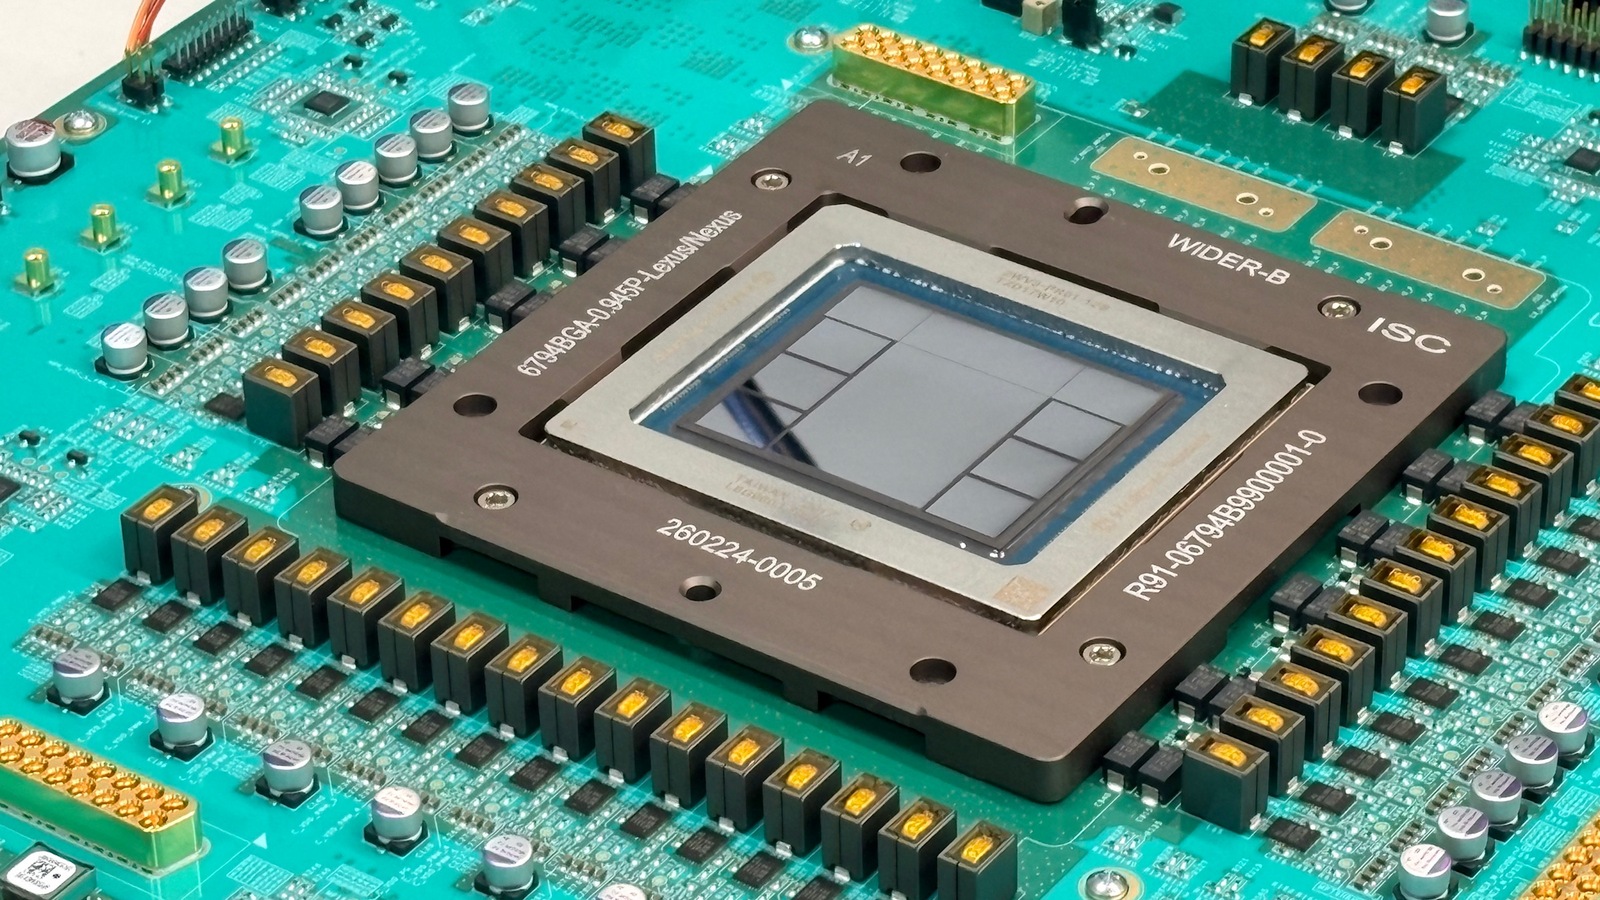
Первый silicon OpenAI вышел на измерения
OpenAI раскрыла первые результаты Jalapeño — своего первого специализированного inference chip и системы вокруг него. По заявлению компании, архитектура одновременно увеличивает объём AI-работы на единицу энергии и сокращает время ответа, тогда как существующим аппаратным системам часто приходится выбирать между высоким throughput и низкой latency.
Компания протестировала Jalapeño на GPT‑OSS 120B, DeepSeek R1 670B и Kimi K2.5 1T. В заявленном диапазоне результатов чип обеспечил от 1,5 до 1,9 раза больше работы на ватт при peak throughput и от 1,7 до 3,6 раза меньшую end-to-end latency относительно систем сравнения. Для наиболее интерактивных режимов преимущество по performance составило от 2,1 до 4,1 раза.
Это результаты самой OpenAI, а не независимый аудит. Тем не менее публикация содержит конкретные модели, operating points и сопоставляемые значения, а не только общую характеристику нового accelerator. Компания называет Jalapeño действующим first-party silicon и началом много поколенной платформы.
Как устроено сравнение
Измерения проводились на публичном benchmark InferenceX от SemiAnalysis, который охватывает полный процесс обслуживания AI-запроса. OpenAI сравнивала системы при согласованном пользовательском опыте: сколько полезной работы выполняется на единицу мощности при соблюдении требований по latency. Такой подход особенно важен для агентов, поскольку задержка каждого последовательного шага складывается в общее время задачи.
Результаты нормализованы по опубликованному power rating каждого accelerator. Jalapeño имеет рейтинг 700 W, но OpenAI сообщает, что измеренная устойчивая мощность на тестовых workloads не превышала 550 W. Для GPT‑OSS 120B в приложении указаны около 1,9 раза больше mixed tokens per second на kW и около 1,7 раза меньшая end-to-end latency против GB200.
В тесте DeepSeek R1 670B Jalapeño сравнивается с GB300: 19 641 против 11 781 mixed TPS/kW на пике и 1,65 против 5,99 секунды end-to-end latency. На Kimi K2.5 1T заявлены 18 195 против 11 862 mixed TPS/kW и 1,56 против 5,31 секунды. Эти цифры относятся к указанным конфигурациям и benchmark conditions, а не к универсальной скорости любого приложения.
Один accelerator для prefill и decode
Jalapeño проектировался специально под современные language-model workloads, где разные стадии имеют разные bottlenecks. Prefill интенсивно использует вычисления, decode сильнее ограничен memory bandwidth, а перемещение состояния между cores и chips добавляет коммуникационные паузы. Система, оптимальная только для одной стадии, может терять преимущество на другой.
Архитектура стремится минимизировать data movement. Состояние модели, включая KV cache, можно явно разместить и удерживать локально, активируя нужную комбинацию compute, memory и networking для конкретной фазы inference. Сеть является встроенной частью дизайна, чтобы полный workload оставался внутри одной связанной системы и меньше ждал передачи данных.
OpenAI описывает результат как balanced и fungible accelerator, способный работать и с prefill, и с decode, а также адаптироваться к изменениям их соотношения. Для agentic workloads это существенно: длинные цепочки действий чувствительны не только к пиковой пропускной способности, но и к стабильному времени каждого ответа.
AI участвовал и в создании, и в программировании чипа
По данным OpenAI, модели помогли пройти путь от начального дизайна до tapeout за девять месяцев: они использовались для перебора реализаций, сокращения циклов design, measurement и verification, а также оптимизации арифметических circuits. Более ранние поколения моделей участвовали в проектировании и bring-up, а новые — в программной оптимизации платформы.
Сам чип задуман как предсказуемая programming target для людей и AI. Инженер описывает работу через local tensors, explicit communication и predictable synchronization, после чего модель может оптимизировать mapping, placement, scheduling и координацию по системе. Такая структура должна сделать задачу parallel programming более удобной для автоматизированной оптимизации.
С Codex и GPT‑Astra команда за два месяца довела до высокой производительности три open-weight модели, которых не было в исходном production plan Jalapeño. Для выбранных attention- и mixture-of-experts blocks GPT‑OSS реализации, созданные AI, работали в 1,5–1,8 раза быстрее прежних human-expert implementations. OpenAI отдельно уточняет, что эти значения относятся к выбранным blocks, а не ко всей модели.
Не только peak throughput
Самые крупные множители в приложении возникают при сопоставлении систем на прежнем минимальном time between tokens. Для GPT‑OSS OpenAI приводит примерно 53,7 раза больше throughput на предыдущем TBT, для DeepSeek — 104,3 раза, для Kimi — 56,1 раза. Эти показатели не следует смешивать с 1,5–1,9-кратным преимуществом на пике: они отвечают на другой вопрос о работе при фиксированной интерактивной скорости.
Именно поэтому компания говорит о Pareto frontier — наборе режимов, в которых нельзя улучшить throughput, не ухудшив latency, или наоборот. Заявка Jalapeño состоит не в одном рекорде, а в сдвиге всей рабочей кривой: ultra-fast inference с эффективностью прежнего fast mode, fast mode с эффективностью batched mode и более эффективный batch.
Для клиентов это потенциально означает более быстрые ответы, более отзывчивых агентов и способность обслуживать растущий спрос. Для OpenAI экономический смысл сформулирован прямо: больше полезной работы на тех же power и hardware может позволить выручке и объёму задач расти быстрее, чем cost to serve. Реальный эффект будет зависеть от production qualification, software maturity и профиля модели.
Deployment до конца года и ещё два поколения
OpenAI планирует начать развёртывание Jalapeño в собственной compute infrastructure до конца 2026 года. Gen 2 уже находится в глубокой разработке, а Gen 3 формируется. До масштабной эксплуатации команда продолжает production qualification, дорабатывает software и проверяет performance на большем числе моделей.
Собственный chip не означает отказ от внешних ускорителей. Компания отдельно подтверждает намерение широко использовать NVIDIA и других партнёров как для training, так и для inference. Jalapeño добавляет вертикально интегрированный путь — модели, serving software, memory, network и silicon проектируются вместе, — но не объявляется единственной аппаратной платформой OpenAI.
Главный открытый вопрос теперь не в том, существует ли чип, а в том, как лабораторные и benchmark-результаты перенесутся в production fleet: на стабильность, yield, стоимость системы, software coverage и доступность мощностей. Публикация показывает измеренный первый шаг и конкретный график внедрения, но окончательную оценку платформе дадут эксплуатационные данные после начала deployment.