Технологии
GPT‑5.6 пришла в Kiro с упором на spec-driven разработку
Sol, Terra и Luna встроены в цикл от требований и технического дизайна до review и property-based testing; OpenAI и AWS делают ставку на стоимость завершённой задачи, а не отдельного токена.
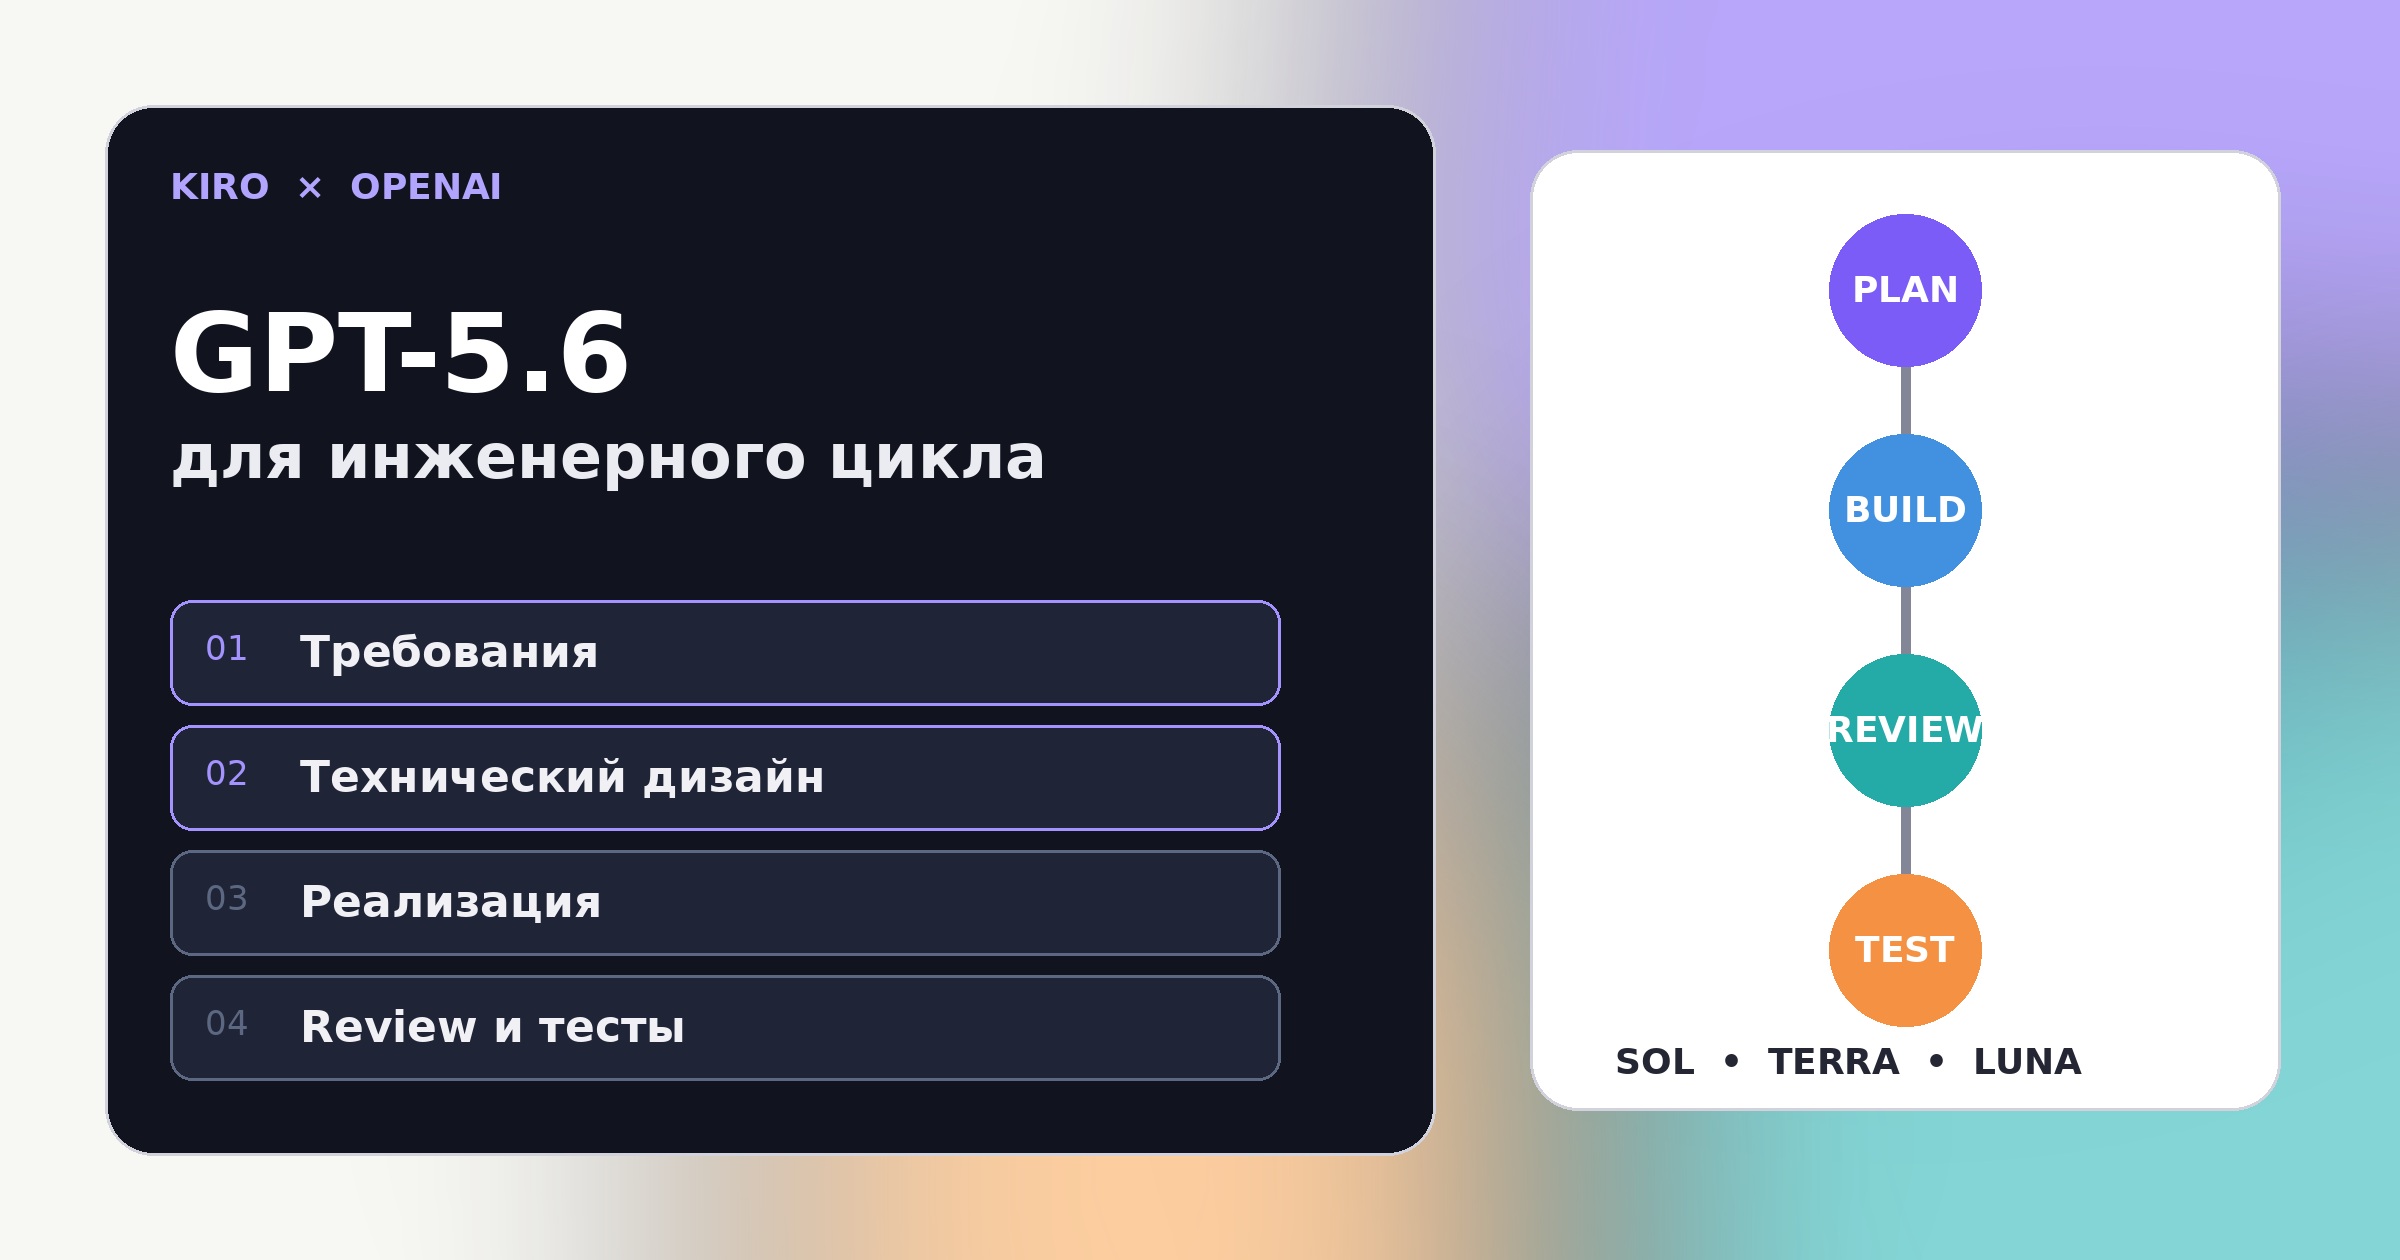
Три модели входят в единый инженерный workflow
OpenAI и AWS сделали семейство GPT‑5.6 доступным в Kiro — software development agent, который организует работу вокруг требований, технического дизайна, реализации, review и тестов. Пользователям предложены Sol, Terra и Luna. Идея интеграции не в отдельном окне для генерации кода: модели получают структурированный контекст о том, что строит команда, как должна работать система и каким критериям обязан соответствовать результат.
Kiro превращает высокоуровневое намерение в requirements, design и executable tasks. На этой основе GPT‑5.6 может выполнять длинные многошаговые задания, сверяться с codebase и стандартами команды, а разработчик — проверять результат в ключевых точках до внесения изменений. Такой workflow пытается сократить главную потерю AI coding: серию быстрых, но несогласованных итераций, где локально правдоподобный patch расходится с архитектурой или исходным запросом.
Spec-driven development задаёт границы до кода
В публикации spec-driven подход представлен как способ заземлить модель в явных требованиях и техническом дизайне ещё до реализации. Это меняет порядок работы. Вместо запроса «добавь функцию» агент сначала формализует ожидаемое поведение и раскладывает его на проверяемые задачи. Для большого изменения такой контекст помогает удерживать связи между модулями и снижает вероятность, что последующие шаги будут оптимизировать разные версии цели.
Разработчик при этом не исчезает из цикла. Kiro предусматривает review и refinement в контрольных точках до применения изменений. Практический смысл этой границы — отделить предложение модели от принятого командой решения. Чем дольше задача и шире область codebase, тем важнее фиксировать промежуточные artifacts: требования, design choices, task list, diff и результаты тестов. Интеграция GPT‑5.6 получает ценность именно внутри этого процесса, а не как автономный генератор большого объёма кода.
Plan, build, review и test используют разную цену ошибки
OpenAI описывает GPT‑5.6 как семейство с возможностью выбирать сочетание intelligence, speed и cost для разных стадий software development lifecycle. Sol, Terra и Luna дают команде не один универсальный режим, а несколько профилей для планирования, реализации, проверки и тестирования. Официальный материал не назначает жёсткую модель каждой стадии, поэтому routing остаётся инженерным решением: его следует строить по сложности, риску и цене повторного запуска, а не только по субъективному качеству одного ответа.
В списке поддерживаемых сценариев отдельно названы сложные multi-step coding tasks, работа с контекстом всей codebase, established team standards и property-based testing. Последнее особенно важно: агент должен не только написать ожидаемый example test, но и проверять свойства реализации на множестве входов. Однако сам факт поддержки не заменяет независимую test strategy. Security boundaries, migrations, совместимость API и необратимые операции всё равно требуют специализированных проверок и человеческого одобрения.
82% относится к стоимости успешной задачи
Совместное тестирование OpenAI и AWS показало, что GPT‑5.6 Terra выполняла успешные задачи Terminal-Bench 2.1 в Kiro примерно с 82-процентным снижением стоимости. Формулировка относится к cost reduction в данном окружении и benchmark, а не к универсальному снижению цены API или ускорению любого проекта. Публикация связывает результат со структурированным контекстом Kiro: ясные требования и design должны уменьшать число ошибочных ходов и повторных итераций до рабочего решения.
Для оценки интеграции полезнее повторить ту же единицу измерения — стоимость завершённой и принятой задачи. Цена токена сама по себе не учитывает неудачные попытки, ручное исправление, review time и regressions после merge. Команда может измерять долю задач, прошедших acceptance tests, число циклов возврата, latency до проверенного commit и суммарные затраты модели. Без такого собственного baseline цифра 82% остаётся результатом vendor testing на Terminal-Bench 2.1, а не готовым business case.
Длинная задача требует durable context
OpenAI подчёркивает complex и long-running development work, заземлённый в requirements, codebase и team standards. У такого режима есть важное эксплуатационное следствие: контекст должен переживать отдельный model turn. Требования и задачи нельзя хранить только в диалоге; они должны оставаться читаемыми artifacts, к которым вернутся review, тесты и следующий запуск. Иначе длинный workflow вновь превращается в цепочку импровизаций, только с большим context window.
Структурированные checkpoints также дают место для fail-closed поведения. Если tests не проходят, diff вышел за согласованный scope или design больше не соответствует требованиям, pipeline должен остановиться до применения изменений. Официальная публикация говорит о review и refinement перед implementation; production-команде стоит дополнить это branch isolation, обязательным CI, audit trail и точной фиксацией версии codebase, на которой агент начал работу.
Как проверять интеграцию в реальном репозитории
Пилот лучше начинать не с максимальной автономности, а с набора повторяемых задач: небольшой feature по спецификации, локализованный bug fix, refactor с invariants и тестовый coverage gap. Для каждой задачи заранее фиксируются acceptance criteria, разрешённые файлы, обязательные команды и условия остановки. Затем сравниваются Sol, Terra и Luna по доле принятых изменений, числу итераций, времени review и полной стоимости успешного результата. Такой эксперимент покажет, где routing между моделями действительно окупается.
Интеграция GPT‑5.6 в Kiro ценна как попытка связать model capability с дисциплинированным software lifecycle. Но официальный анонс не публикует разбивку Terminal-Bench по типам задач, исходный cost baseline или результаты на конкретных production repositories. Поэтому сильный вывод здесь архитектурный, а не универсально количественный: сначала требования, design и проверяемые tasks; затем model execution; после — review и property-based tests. Именно этот порядок превращает более мощную модель в контролируемый инженерный инструмент.