Технологии
«До 3,7 раза выше пропускной способности»: Vera Rubin NVL72 впервые вышел в MLPerf Inference v6.1
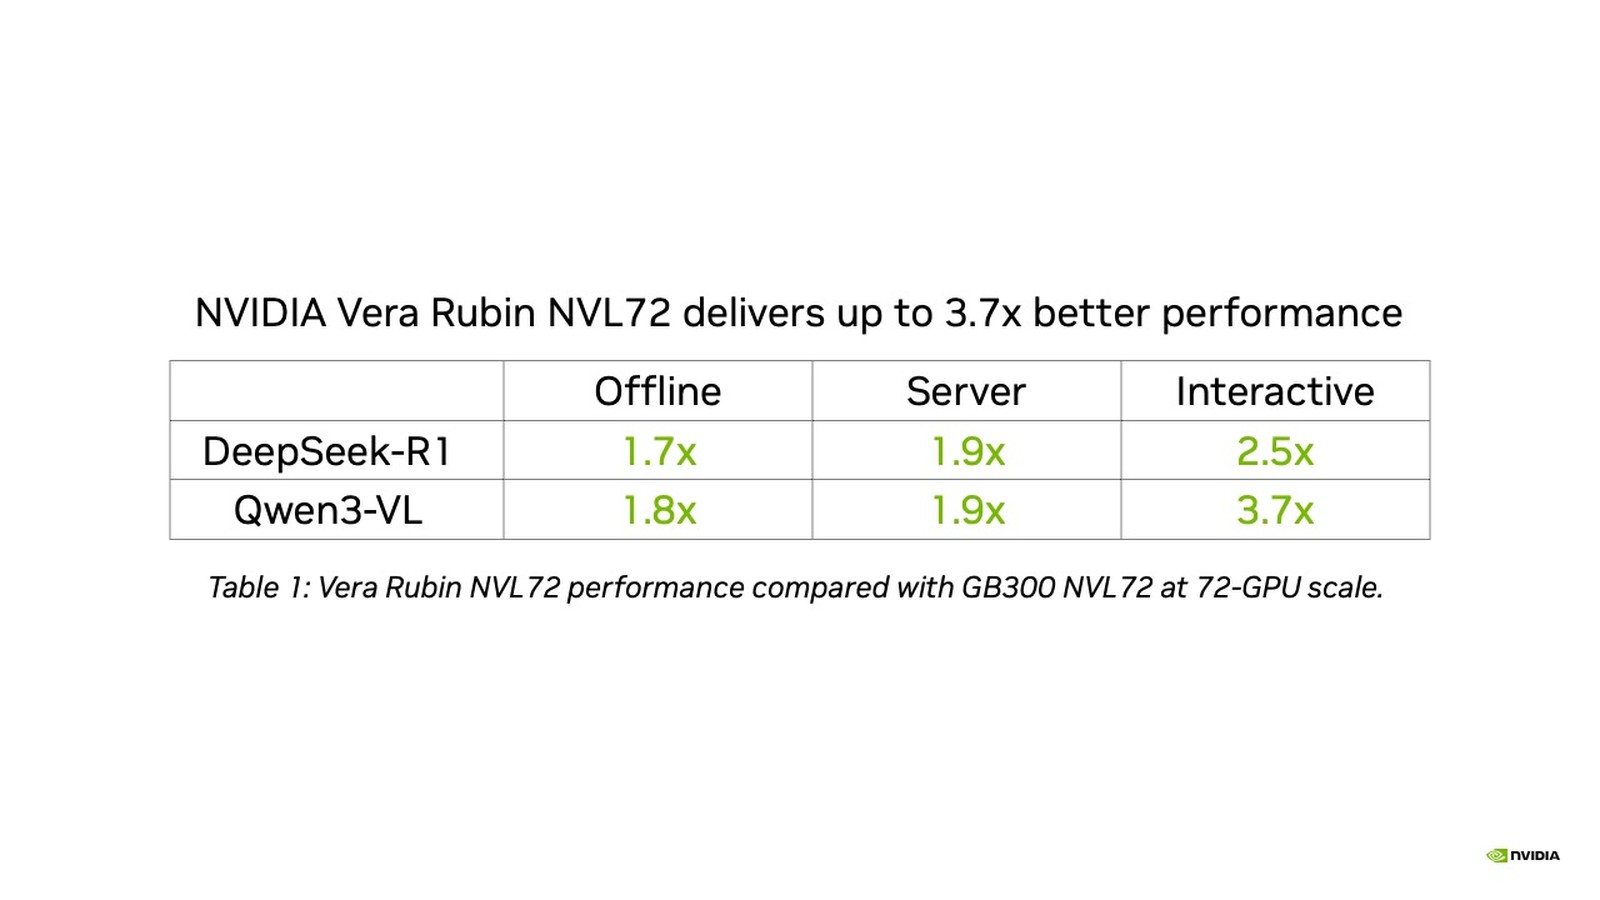
16 сентября 2026 года NVIDIA сообщила, что её система Vera Rubin NVL72 впервые участвовала в MLPerf Inference — в статусе preview-сабмишна — и на бенчмарке Qwen3-VL показала до 3,7 раза более высокую пропускную способность, чем GB300 NVL72, а на DeepSeek-R1 с TensorRT-LLM — до 2,5 раза. Четырёхраковая конфигурация GB300 NVL72 на 288 GPU при этом достигла 99 % эффективности масштабирования в offline-сценарии. Часть цифр относится к периоду после дедлайна подачи и ещё не проверена MLCommons — сама NVIDIA указывает это прямо.
Что NVIDIA объявила 16 сентября
16 сентября 2026 года NVIDIA опубликовала в корпоративном блоге разбор результатов MLPerf Inference v6.1, построив его вокруг трёх тезисов: производительность системы, эффективность масштабирования и скорость софтверных оптимизаций. Компания формулирует их как рычаги, определяющие экономику инференса: более высокая производительность означает больше сгенерированных токенов и, соответственно, выручки, эффективное масштабирование — что пропускная способность растёт пропорционально добавленному оборудованию, а непрерывная оптимизация — что вложения в инфраструктуру приносят больше отдачи.
Главная новость — дебют Vera Rubin NVL72: система впервые участвовала в MLPerf Inference, причём в статусе preview-сабмишна, и сразу по двум бенчмаркам — DeepSeek-R1 и Qwen3-VL. NVIDIA описывает их как «два из самых требовательных бенчмарков» набора v6.1.
Заявленные цифры выглядят так. На Qwen3-VL Vera Rubin NVL72 демонстрирует до 3,7 раза более высокую пропускную способность, чем GB300 NVL72, причём сразу в трёх сценариях — offline, server и interactive — на стеке vLLM с открытым фреймворком NVIDIA Dynamo. На DeepSeek-R1 с библиотекой TensorRT-LLM прирост скромнее: до 2,5 раза по сравнению с GB300 NVL72.
Сама NVIDIA аккуратно называет эти результаты ранними: по её формулировке, они показывают ускоренный темп инноваций и то, как производительность будет расти вместе с продолжающимися оптимизациями софта. Формальная привязка к MLPerf указана в публикации явно: Closed Division, результаты получены с сайта MLCommons 16 сентября 2026 года, записи 6.1-0106 и 6.1-0074.
99 % эффективности масштабирования на четырёх стойках
Второй сюжет публикации — не абсолютная скорость, а масштабируемость. Сабмишн NVIDIA на DeepSeek-R1 (DSR1) вырос с одной стойки GB300 NVL72 (72 GPU) до четырёх (288 GPU) и в offline-сценарии достиг 99 % эффективности масштабирования: пропускная способность выросла почти пропорционально добавленному железу.
NVIDIA объясняет, почему это отдельная метрика: дополнительные GPU не дают автоматически пропорционального роста, и если бы почти удвоение числа ускорителей приносило лишь единицы процентов прироста, стоимость инфраструктуры росла бы быстрее отдачи; для линейного роста должны совпасть архитектура, interconnect и софт.
Есть в отчёте и видео-бенчмарк: на WAN 2.2 в задаче text-to-video GB300 NVL72 выдаёт 0,65 видео 720p в секунду при 5,7 секунды на видео — это в 9 раз выше пропускная способность и в 7,5 раза ниже задержка, чем у одного узла.
Софт даёт до 1,6 раза — но часть цифр ещё не проверена
Третий сюжет — вклад программного обеспечения. На Qwen3-VL производительность GB300 NVL72 в v6.1 выросла до 1,6 раза по сравнению с результатами v6.0; прирост дали снижение точности KV-кэша, дополнительное слияние ядер (kernel fusion), улучшенные ядра и disaggregated serving с vLLM и NVIDIA Dynamo.
Здесь важна оговорка, которую делает сама NVIDIA: оптимизации продолжались и после дедлайна подачи v6.1, и результаты, полученные после сабмишна, — на моделях GPT-OSS-120B и DLRMv3 — показывают дальнейший рост, но ещё не проверены MLCommons. Это значит, что такие цифры нельзя считать подтверждёнными результатами MLPerf: они имеют статус внутренних измерений вендора.
Отдельный сюжет, который NVIDIA выносит вперёд, — агентные нагрузки. В бенчмарке SemiAnalysis AgentX, который компания приводит как пример нового класса измерений, Vera Rubin NVL72 в preview-тестировании показал в 30 раз лучшую производительность, чем GB300 NVL72. Это не результат MLPerf: AgentX — сторонний бенчмарк, а данные приводит сам вендор, а не организатор бенчмарка. NVIDIA добавляет, что стандартизировать измерение агентного инференса должен будущий бенчмарк MLPerf Endpoints.
Что стоит за цифрами
Техническая основа заявленных результатов — сквозной кодзайн железа и софта. По описанию NVIDIA, у Vera Rubin усиленные Tensor Cores и Transformer Engine ускоряют и prefill, и decode, а точность NVFP4 сокращает объём памяти под веса модели, внимание и KV-кэш, повышая пропускную способность при минимальной потере качества вывода. Сабмишны активно использовали disaggregated serving — разделение prefill и decode — и крупномасштабный expert parallelism для mixture-of-experts моделей вроде DeepSeek-R1 и Qwen3-VL.
Фундамент для этого — scale-up домен NVL72 на NVLink шестого поколения и NVLink Switch: по данным компании, они дают в 10 раз более высокую скорость обработки пакетов и в 3 раза меньшую задержку по сравнению с обычным Ethernet.
Экосистема в публикации описана широко: preview-результаты на Vera Rubin NVL72 подала и Nebius, а всего в MLPerf Inference v6.1 участвовали 19 партнёров NVIDIA, восемь из них — на многоузловых системах Blackwell NVL72, среди них ASUS, Azure, Cisco, CoreWeave, Crusoe, Dell Technologies, Fujitsu, Giga Computing, HPE, Inventec, Lambda, MiTAC Computing, Nebius, Oracle Cloud Infrastructure, Quanta Cloud Technology, Red Hat, ScitiX, Supermicro и Wiwynn.
Отдельная строка — периферия: NVIDIA также подала результаты Jetson AGX Thor на TensorRT Edge-LLM в новом бенчмарке Edge-Agentic с моделью Qwen3.6-27B.
Чего в отчёте нет
Публикация не содержит абсолютных значений пропускной способности: все сравнения даны относительно систем NVIDIA предыдущего поколения, а не относительно решений других производителей. Нет в ней и цен, а также сроков, когда Vera Rubin NVL72 станет доступен заказчикам в объёме, — речь идёт о preview-сабмишне, а не о серийных поставках.
Проверить цифры независимо можно только частично. MLCommons публикует результаты MLPerf Inference: Datacenter в интерактивной таблице и даёт доступ к сырым данным: на странице прямо сказано, что набор измеряет, насколько быстро системы обрабатывают входы и выдают результаты с помощью обученной модели, а опубликованные результаты иногда изменяются или аннулируются, о чём сообщается в changelog. При этом самих чисел v6.1 в тексте страницы нет: они живут в таблице результатов и в записях сабмишнов, на которые ссылается NVIDIA.
Контекст, которого в отчёте о MLPerf нет, но который важен для чтения цифр: 21 июля 2026 года NVIDIA сообщала, что производство Vera Rubin NVL72 наращивается, стойки уже работают у CoreWeave, Google Cloud, Microsoft Azure, Oracle Cloud Infrastructure и Nebius, а платформа опирается на 300 глобальных партнёров и более 350 заводских площадок в 30 странах. Иными словами, MLPerf-дебют preview-системы — это ещё и подтверждение уже начатой поставки.
Первоисточники
- NVIDIA Blog: «NVIDIA Vera Rubin NVL72 Delivers Leading Performance in MLPerf Inference v6.1 Debut» (16 сентября 2026)
- MLCommons — MLPerf Inference: Datacenter (официальные результаты и правила бенчмарка)
- NVIDIA Blog: «NVIDIA Vera Rubin Driving Performance Per Watt, Lower Token Costs for Partners Worldwide» (21 июля 2026)