Технологии
«Общий фундамент вместо проприетарных спецификаций»: NVIDIA открыла архитектуру Vera Rubin через OCP
12 октября 2026 года на OCP Global Summit в выставочном центре San Jose McEnery Convention Center NVIDIA объявила о новых партнёрствах и вкладах в Open Compute Project, нацеленных на общий фундамент для инфраструктуры ИИ следующего поколения. Компания передала в OCP проекты стоек и вычислительных лотков NVIDIA Vera Rubin через открытую архитектуру NVIDIA MGX, чтобы системные сборщики получили общую основу для разработки инфраструктуры ИИ-фабрик. В анонсе перечислены шесть направлений: открытые стандарты проектирования ИИ-фабрик и устойчивости энергосети, новые открытые компоненты ПО для NVIDIA DSX AI Factory, развитие открытых сетей вместе с Meta, проект 800-вольтовой ИИ-фабрики от Visionbay, стандарт USFP вместе с Cisco и поддержка Falcon Transport на будущих ConnectX-10 SuperNIC и BlueField DPU вместе с Google.
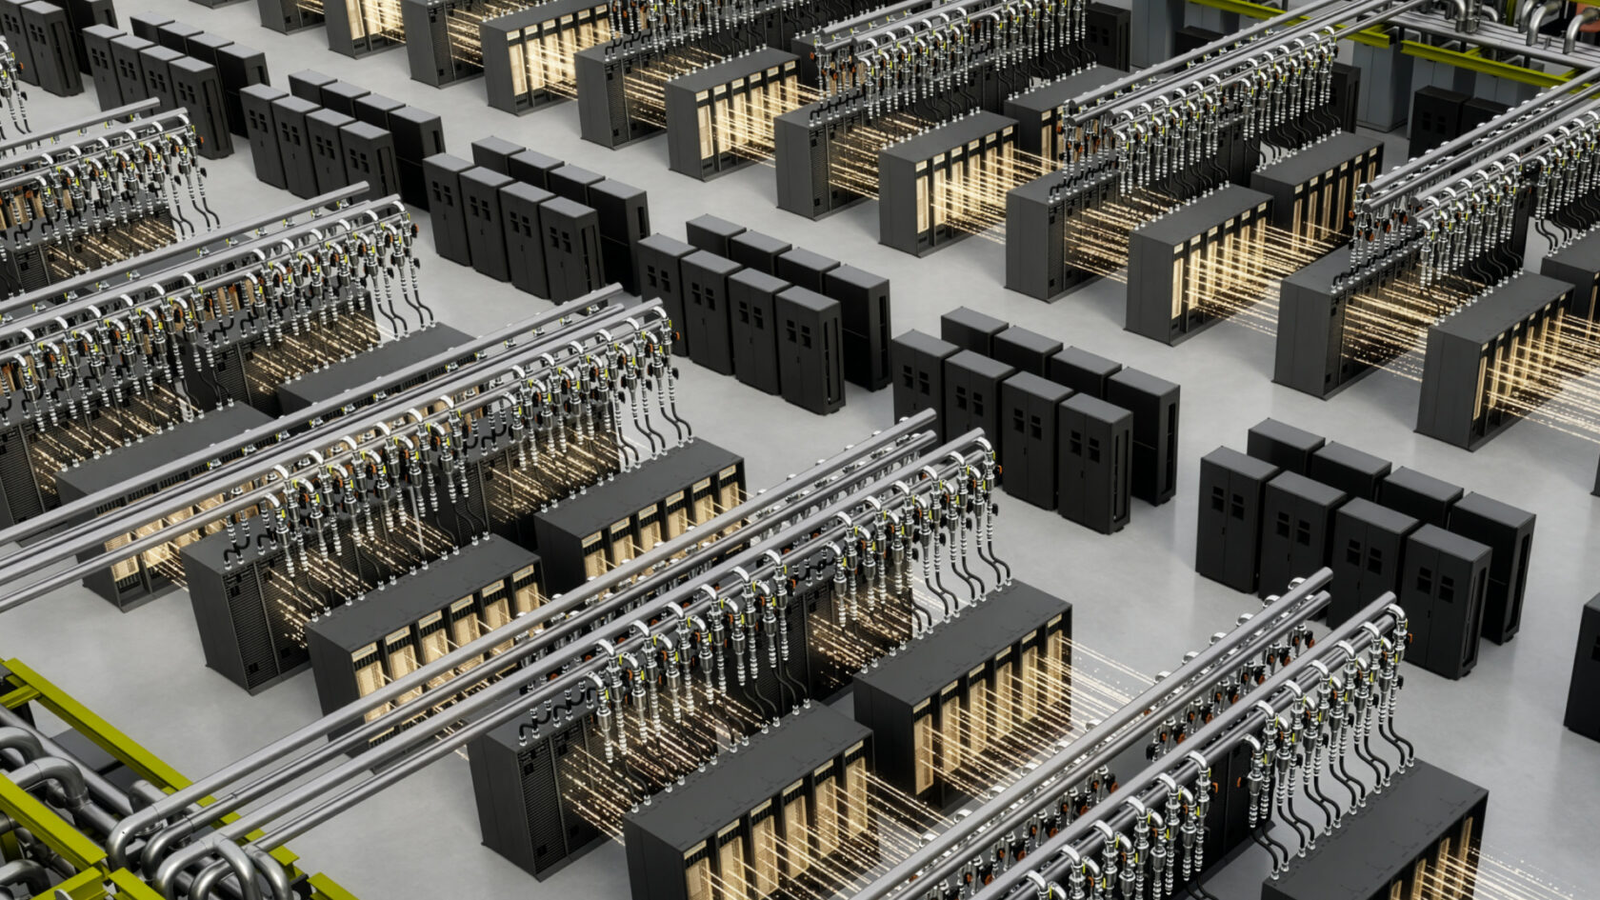
MGX 1.2: шина на 5 000 А и стойки до 250 кВт
Обновлённая спецификация MGX 1.2 расширяет открытую архитектуру ИИ-фабрик межстоечным соединением вслепую для жидкостного охлаждения, совместимыми межстоечными интерфейсами соединений и жидкостно-охлаждаемой шиной на 5 000 А, рассчитанной на более мощные системы. Спецификация добавляет нативную поддержку оборудования шириной 19 дюймов и более плотные конструкции стоек, а модульность расширяет настраиваемыми отсеками ввода-вывода, безвентиляторными жидкостно-охлаждаемыми вычислительными лотками и стандартизованными интерфейсами питания и охлаждения. Архитектура поддерживает развёртывания стоек мощностью до 250 кВт и при этом упрощает обслуживание, развёртывание и повторное использование инфраструктуры. Вместе с открытыми технологиями жидкостного охлаждения MQD и MQDB это должно превратить отработанные проекты ИИ-фабрик в отраслевые стандарты, которые другие могут внедрять, производить и масштабировать.
Стойка Vera CPU — под агентные задачи
Спецификация стоек Vera CPU выводит открытую архитектуру MGX за пределы ускоренных вычислений и описывает платформу под растущую эпоху агентного ИИ. Если стойка Vera Rubin NVL72 служит основой для крупномасштабного обучения и инференса, то стойка Vera CPU спроектирована под вызовы инструментов, оркестрацию и исполнение в песочницах — то, что нужно агентам для работы с приложениями, данными и сервисами в реальном времени. Она построена на стоечной архитектуре MGX третьего поколения и делит с ней общие принципы, объединяющие вычисления, сети, питание и охлаждение в общую модульную платформу.
Открытые компоненты DSX OS
NVIDIA расширила DSX OS открытыми компонентами для настройки сетей, валидации кластеров, управления стойками и провижининга «железа». В список вошли NVIDIA Config Manager, который автоматизирует конфигурацию коммутаторов в масштабе и позволяет развёртывать, проверять и поддерживать консистентные сетевые фабрики ИИ-фабрик почти без ручного вмешательства, и NVIDIA Cluster Readiness Engine, который стресс-тестирует GPU-кластеры симуляциями реальных нагрузок, чтобы гарантировать здоровье оборудования до старта обучения. К ним добавлены NVIDIA Rack Management Service — абстракция оборудования стойки, где стойка становится полноценной единицей управления прошивками в масштабе, — и Cluster API Provider для NVIDIA Infrastructure Controller, ускоряющий развёртывание «голого железа» и подключение арендаторов с дней до часов. Компоненты выросли из опыта эксплуатации NVIDIA DGX Cloud и позволяют облачным провайдерам и софтверным партнёрам встраивать возможности ИИ-фабрики прямо в свои мультитенантные платформы.
Спецификации дата-центра и устойчивости к сбоям энергосети
Вместе с AMD, Google и Meta компания опубликовала Open Data Center Specification v0.7 — единый чертёж для проектирования ИИ-фабрик следующего поколения, от архитектуры питания до инфраструктуры охлаждения и физической компоновки. Отдельно Google, Meta, Microsoft и NVIDIA опубликовали OCP Grid Resilience Specification, описывающую, как крупная ИИ-инфраструктура должна вести себя при возмущениях в энергосети: сохранять подключение, реагировать автоматически и восстанавливать почти полную нагрузку менее чем за две секунды. По словам авторов анонса, открытые стандарты дают производителям оборудования, площадкам колокейшна и операторам дата-центров общую цель для проектирования, изготовления и поставки инфраструктурного слоя — без ожидания проприетарных спецификаций от отдельных заказчиков.
Visionbay K-1: 800 В постоянного тока
Visionbay представила планы K-1 — платформы ИИ-фабрики, спроектированной вокруг архитектуры 800 В постоянного тока и рассчитанной на будущие развёртывания NVIDIA Vera Rubin. Проект сочетает референсную архитектуру NVIDIA на 800 В постоянного тока с силовыми и термальными технологиями Vertiv, чтобы получить масштабируемую основу для плотной ИИ-инфраструктуры. Архитектура строится вокруг кластерных центров питания, которые централизуют преобразование переменного тока в постоянный и подводят 800 В постоянного тока ближе к вычислительным ресурсам, упрощая доставку питания и оставляя возможность модульного расширения. По логике проекта, переход не требуется целиком в первый день: 800 В постоянного тока внедряются там, где это даёт наибольшую выгоду.
Сети: Meta, Spectrum-6 и N-IceCube
Meta переходит на Ethernet-коммутаторы NVIDIA Spectrum-6 с суммарной пропускной способностью 102,4 Тбит/с, чтобы строить более крупные ИИ-фабрики Vera Rubin на открытых сетях. По данным NVIDIA, Spectrum-6 даёт вдвое большую пропускную способность коммутации и вдвое большую пропускную способность на линию, чем Spectrum-4, и обеспечивает неразрушающую Ethernet-фабрику со скоростью 200 Гбит/с на линию с изоляцией производительности, чтобы трафик одной задачи не тормозил другую. Коммутатор Meta на базе Spectrum-6 под названием N-IceCube встаёт в IcePack — жидкостно-охлаждаемую сетевую стойку Meta — и работает на открытой сетевой ОС Facebook Open Switching System (FBOSS), которую Meta передала в OCP для эффективной работы сетей в гипермасштабе. В основе сотрудничества лежит Spectrum-X Multiplane: он распределяет трафик GPU аппаратно по восьми независимым сетевым плоскостям, позволяет масштабировать фабрику за пределы 100 000 GPU с меньшим числом уровней коммутации и при отказе компонента переносит трафик на оставшиеся плоскости. Омар Балдонадо, старший директор по дата-центрам и сетям ИИ в Meta, назвал операционную масштабируемость и производительность multiplane-фабрик критичным требованием и для собственных развёртываний компании, и для совместных облачных партнёров, а перенос FBOSS на ASIC Spectrum — способом запускать один и тот же программный стек по всей фабрике.
Falcon Transport на ConnectX-10
NVIDIA и Google объявили, что будущие SuperNIC ConnectX-10 и DPU BlueField получат поддержку Falcon Transport, что должно повысить эффективность сети для крупной ИИ-инфраструктуры. Falcon — транспортный протокол для надёжной доставки данных поверх Ethernet, который иначе теряет пакеты при перегрузке, и он поддерживает нагрузки ИИ и хранилищ через многопутевую балансировку, программируемое управление перегрузкой, аппаратное восстановление потерь и защиту на уровне соединения. Совместная работа объединяет аппаратное ускорение NVIDIA с программным стеком DOCA: сетевые карты NVIDIA и Google смогут общаться через общий транспорт, а приложения сохранят стандартные программные интерфейсы RDMA.
Что осталось за кадром
Стандарт USFP — модуль на 400 Гбит/с на линию — NVIDIA и Cisco анонсировали в тот же день отдельным релизом; в посте OCP он назван «первым в отрасли модулем для сетевых фабрик на 400 Гбит/с». В анонсе OCP нет ни дат поставок, ни цен, ни списка заказчиков, ни результатов испытаний на готовых изделиях: характеристики поданы как планы и спецификации. Иан Бак, вице-президент NVIDIA по гипермасштабируемым и высокопроизводительным вычислениям, в связи с анонсом говорил о том, что открытая инфраструктура становится критически важным ингредиентом для масштабирования ИИ-фабрик по всему миру, но конкретных цифр экономии в публикации не приводится.