Технологии
NVIDIA добавила Groq 3 LPX к Vera Rubin для быстрого decode AI-агентов
Groq 3 LPX берёт latency-sensitive генерацию токенов, Rubin GPU обрабатывают большой контекст, а Spectrum-X Multiplane масштабирует сеть до 512 000 GPU — NVIDIA собирает inference в единую rack-scale архитектуру.
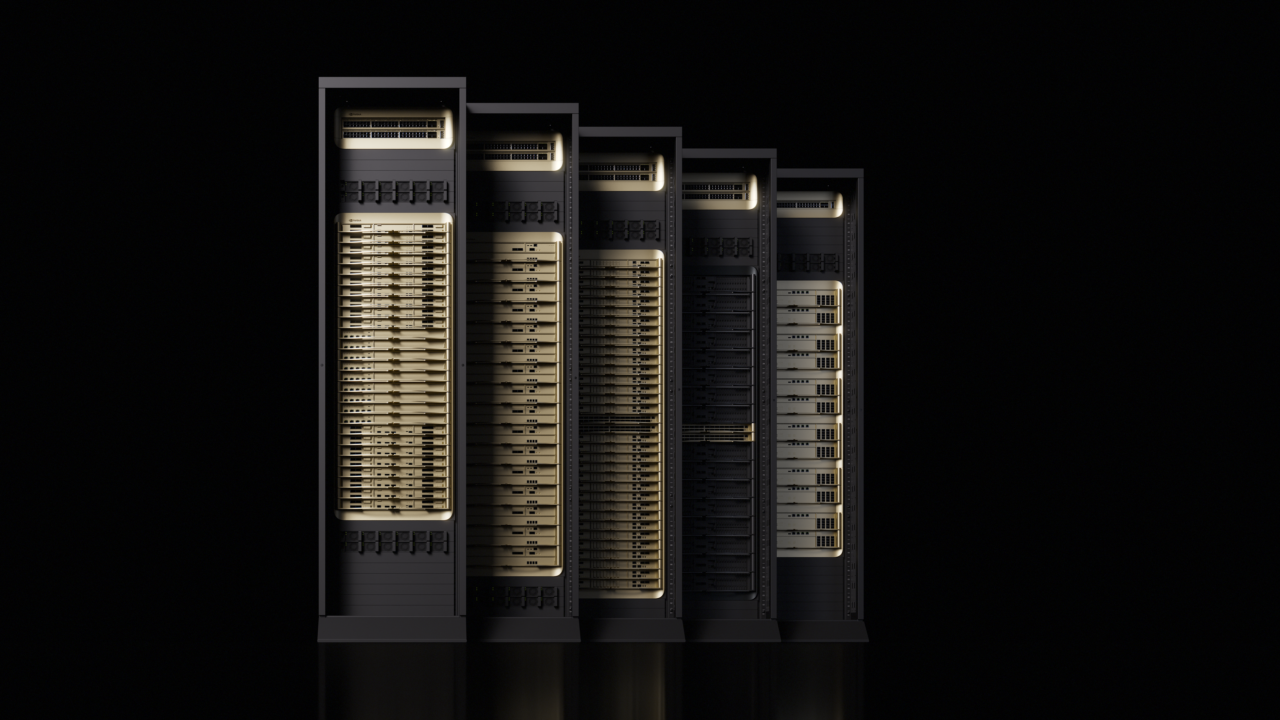
Groq 3 LPX переводит быстрый decode в production
NVIDIA сообщила, что rack-scale система Groq 3 LPX для платформы Vera Rubin находится в full production. Её задача — ускорять latency-sensitive decode в agentic inference: Rubin GPU обрабатывают большой контекст, а LPU генерируют последовательность выходных токенов. Компания рассматривает эти компоненты не как независимые ускорители, а как совместную систему, где контекст, коммуникация и generation оптимизируются под одну нагрузку.
В benchmark Artificial Analysis система на Gemma 4 31B при контексте 100 000 токенов показала 3 400 output tokens per second — в четыре раза больше ближайшей альтернативной платформы, согласно NVIDIA. Это конкретный vendor-reported результат для одной модели и профиля long-context. Он показывает целевой режим LPX, но не заменяет тестирование latency первого токена, стабильности под concurrency и качества модели в production.
Агенты превращают decode latency в системное ограничение
Обычная генерация создаёт токены последовательно, а агентная работа многократно повторяет этот цикл между reasoning, tool use и взаимодействием с другими системами. Даже небольшая задержка на одном шаге суммируется по длинной цепочке. NVIDIA позиционирует Groq 3 LPX как специализированный accelerator именно для этой части workload, чтобы обеспечить более предсказуемую и быструю генерацию после обработки контекста.
В rack-scale конфигурации может использоваться 256 ускорителей LP30, соединённых direct chip-to-chip links. NVIDIA описывает их как единый processor для deterministic inference. В отличие от standalone accelerator, LPX codesigned с Vera Rubin NVL72: GPU и LPU совместно вычисляют слои модели, пытаясь убрать традиционный выбор между низкой latency и высоким aggregate throughput.
Первые партнёры разделяют compute, cloud и network
Nebius названа первым AI cloud, который внедряет NVIDIA Groq 3 LPX. Ускорители войдут в Nebius Token Factory для interactive agents, coding systems и других real-time сценариев. CoreWeave уже развернула Spectrum-X Multiplane в production для соединения стоек Vera Rubin, а SpaceXAI планирует строить следующую agentic AI architecture на Vera CPU — от наземных дата-центров до orbital satellites.
У этих анонсов разные уровни готовности. NVIDIA прямо говорит о production deployment сети CoreWeave и full production для LPX, тогда как формулировка о SpaceXAI описывает будущий план. Vera CPU предназначен для CPU-intensive частей agent workflow: orchestration, tool use, code execution, data processing и simulation. Разделение статусов важно, чтобы не выдавать намерение партнёра за уже работающую инфраструктуру.
Spectrum-X Multiplane избегает третьего network tier
Для масштабирования AI factory Spectrum-X Multiplane делит сетевое соединение каждого сервера на несколько независимых planes. Каждый plane остаётся лёгкой двухуровневой сетью, а ConnectX SuperNIC распределяет трафик и переключает его при отказе. NVIDIA заявляет масштаб до 512 000 GPU без добавления третьего tier, который увеличил бы latency, jitter, стоимость optics, cabling и энергопотребление.
В eight-plane topology потеря одного plane, по данным компании, оставляет около 90% суммарной bandwidth. Hardware recovery заявлена в 11 раз быстрее software-based multiplane load balancing, а итоговый AI factory output — в 1,6 раза выше. В основе находятся Spectrum-6 Ethernet ASIC на 102,4 Tb/s и ConnectX-9 SuperNIC с поддержкой до 1 600 Gb/s на GPU. Все эти числа требуют сопоставимой topology и workload при независимой проверке.
BlueField-4 ускоряет инфраструктурные сервисы
Отдельный слой NVIDIA Scale-In переносит acceleration на сервисы, которые обслуживают shared AI infrastructure. BlueField-4 и DOCA должны выполнять multi-tenant networking, storage access, in-silicon security, elastic provisioning и real-time observability независимо от host compute. Цель — не отнимать CPU и GPU cycles у inference, когда растёт число пользователей, приложений и автономных агентов.
Scale-In компания называет пятым pillar своей AI networking architecture. Он соединяется через Spectrum-X Ethernet и преобразует традиционную north-south access network в отдельный accelerated domain. Это не ускоритель модели в узком смысле, а попытка включить безопасность, данные и operations в общий codesign. Реальная польза будет зависеть от того, какую долю ресурсов эти сервисы занимают в конкретном кластере.
NVLink Fusion открывает стек для custom XPU
NVLink Fusion позволяет hyperscalers и AI-native компаниям подключать custom XPU и CPU к scale-up и scale-out инфраструктуре NVIDIA. В набор входят NVLink шестого поколения, NVLink Switch и NVLink-C2C, а экосистема MGX предоставляет rack designs, manufacturing components, power, cooling и software для распределённых workloads. Идея — сохранить общую инфраструктуру, даже если оператор меняет пропорцию GPU и собственных accelerators.
Анонс показывает направление NVIDIA: производительность inference должна складываться из context processing, быстрого decode, network fabric и offload инфраструктурных сервисов, а не из одного chip benchmark. Для заказчика это одновременно преимущество и риск зависимости от tightly integrated stack. Оценивать систему стоит end-to-end: time-to-first-token, inter-token latency, throughput под параллельной нагрузкой, отказоустойчивость planes, энергопотребление и стоимость эксплуатации всего rack, а не только LPX.