Технологии
«Один гигаватт не станет двумя»: NVIDIA показала, как выжимать больше токенов из того же мегаватта
15 сентября 2026 года NVIDIA опубликовала разбор платформы DSX для AI-фабрик. Партнёрский оркестратор Emerald AI Conductor по сигналу энергокомпании Silicon Valley Power снижал потребление фабрики с 4 до 3 МВт без участия оператора, а на валидации Lambda кластер из 19 узлов выдал на 24% больше токенов в секунду в том же бюджете мощности — примерно с 4 до 5 миллионов токенов в секунду.
Что увидели в Санта-Кларе
В августовский вечер в Кремниевой долине, когда солнце село и нагрузка на кондиционирование выросла, энергокомпания Silicon Valley Power отправила на AI-фабрику сигнал снизить потребление. За этим по Zoom наблюдали около сорока человек: команда Варуна Сиварама (Varun Sivaram) из Emerald AI в конференц-зале в Сан-Франциско, инженеры дата-центра и представители самой энергокомпании. Никто ничего не трогал руками.
Сигнал принял Conductor — платформа оркестрации энергосистемы от NVIDIA-партнёра Emerald AI, которую в публикации называют ранним примером той гибкости, для которой строится NVIDIA DSX Flex. Логика простая: работа, которая может подождать, замедляется или переносится, а приоритетные сервисы продолжают работать. Мощность фабрики ушла с четырёх мегаватт на три автоматически, и, по описанию участников, решение сработало с первого раза, а сама команда смотрела на экран, затаив дыхание: это было первое развёртывание сразу на тысячах GPU NVIDIA.
Дальше это перестало быть экспериментом. С тех пор Silicon Valley Power отправила на эту фабрику больше 200 сигналов снижения нагрузки, и, по формулировке NVIDIA, это работало каждый раз.
MaxLPS: тот же бюджет мощности, больше токенов
Цифры к этой истории пришли в тот же день с кейноута на AI Infra Summit: Ян Бак (Ian Buck), вице-президент NVIDIA по гипермасштабной и высокопроизводительной части, поставил эффективность AI-фабрик в центр выступления, а облачный провайдер Lambda выпустил результаты первой валидации в среде развёртывания — фиксированный бюджет мощности позволяет обслужить на 24% больше токенов, если управлять им разумно.
Механика описана так: NVIDIA DSX MaxLPS следит за потреблением на уровне GPU и стоек и перераспределяет запас мощности между узлами в зависимости от типа нагрузки, возвращая ёмкость, которую статическое распределение оставило бы неиспользованной. Обучение и инференс расходуют энергию по-разному, и MaxLPS оптимизирует распределение на фабриках, где идут оба процесса.
В Lambda программное обеспечение запустили на кластере из пяти стоек и 19 узлов. Результат: 19 узлов в том же бюджете мощности, что и 16 узлов на полной мощности, дали на 24% больше токенов в секунду по кластеру — примерно с 4 до 5 миллионов токенов в секунду, — а производительность на ватт выросла на 23%.
Для следующего поколения фабрик на Vera Rubin NVL72 NVIDIA оценивает потенциал MaxLPS вплоть до 40% дополнительной ёмкости GPU в том же бюджете мощности — при подходящих условиях развёртывания.
Энергосистема, для которой фабрика — управляемый ресурс
История в Санта-Кларе — ещё не установка DSX Flex, а более раннее доказательство того, что схема работает в коммерческом масштабе. Фабрика Eos участвует в Flexible Load Interconnect Program Silicon Valley Power — первой коммерческой программе энергокомпании, в которой AI-фабрику рассматривают как управляемый ресурс сети.
Ключевая метрика здесь — скорость и предсказуемость ответа: в таблице результатов NVIDIA приводит реакцию менее чем за минуту и снижение спроса на 40% в этом же окне. Именно эта способность — быстро и обратимо снимать нагрузку — позволяет подключать фабрики к сети без ожидания новых линий электропередачи.
Первое выделенное коммерческое развёртывание DSX Flex заявлено в Манассасе, штат Вирджиния: фабрика на 96 мегаватт на Vera Rubin в NVIDIA AI Factory Research Center, после пяти предыдущих демонстраций на двух континентах.
Следующий слой: 800 вольт постоянного тока
Внутри нынешней фабрики резервы ещё можно выбрать; дальше вопрос в том, как подводить питание к более плотным стойкам. Нижковольтные пути усложняют преобразования и ограничивают распределение, поэтому NVIDIA продвигает архитектуру 800 V DC и включает её в референсные дизайны DSX. Компания оценивает выигрыш сквозной эффективности в 3–5% по сравнению с распределением 54 В, а вариант должен стать доступен вместе с Vera Rubin NVL72 в 2027 году.
Из чего состоит DSX
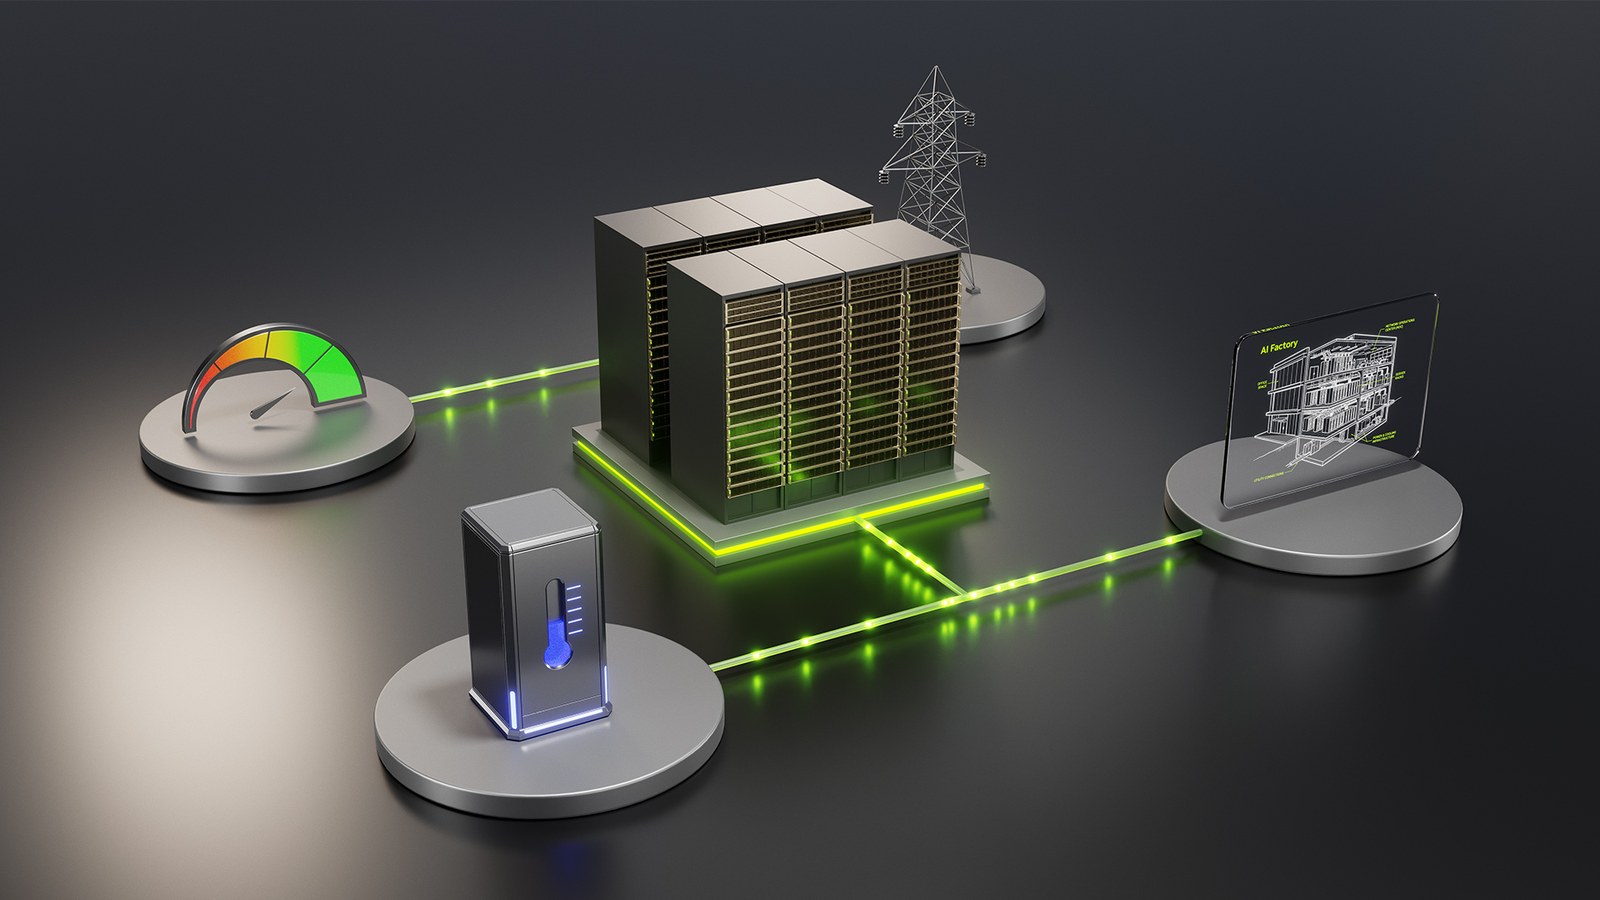
Платформа разложена на пять частей. MaxLPS отвечает за отдачу на мегаватт, включая динамическое распределение мощности между GPU и стойками в реальном времени; Flex принимает сигналы энергосистемы — сброс нагрузки, demand response, ценовые события — и перестраивает приоритеты нагрузок; DSX OS даёт открытое модульное программное обеспечение для управления жизненным циклом фабрики; DSX Sim позволяет проверять проекты в симуляции до физического развёртывания; DSX Reference Designs предлагает проверенные архитектуры под конкретное поколение железа. Платформа была представлена на GTC Taipei в мае 2026 года, а в Санта-Кларе речь шла уже о результатах по управлению мощностью и о работе фабрик в связке с сетью.
Почему по частям не получается
Отдельный компонент фабрику не оптимизирует: быстрый GPU всё равно ждёт сеть, а неверное распределение оставляет мощность неиспользованной. Масштаб виден по охлаждению: стойка GB200 NVL72 с прямым жидкостным охлаждением несёт около 120 кВт тепла, которое нужно отвести прежде, чем эта энергия дойдёт до вычислений.
Отсюда формула, которую в NVIDIA повторяет Дженсен Хуанг: фабрика на один гигаватт никогда не станет фабрикой на два гигаватта. Ограничение — мощность, а метрика — работа на гигаватт: сколько полезных токенов фабрика производит на каждый потреблённый мегаватт и сколько из этих токенов можно успеть выдать в тот момент, когда сеть просит сбросить нагрузку.