Технологии
Microsoft предложила считать «полезную отдачу» AI-инфраструктуры
На SEMICON Taiwan компания призвала оценивать не только введённую мощность, но и токены на доллар и ватт, throughput и latency всей системы.
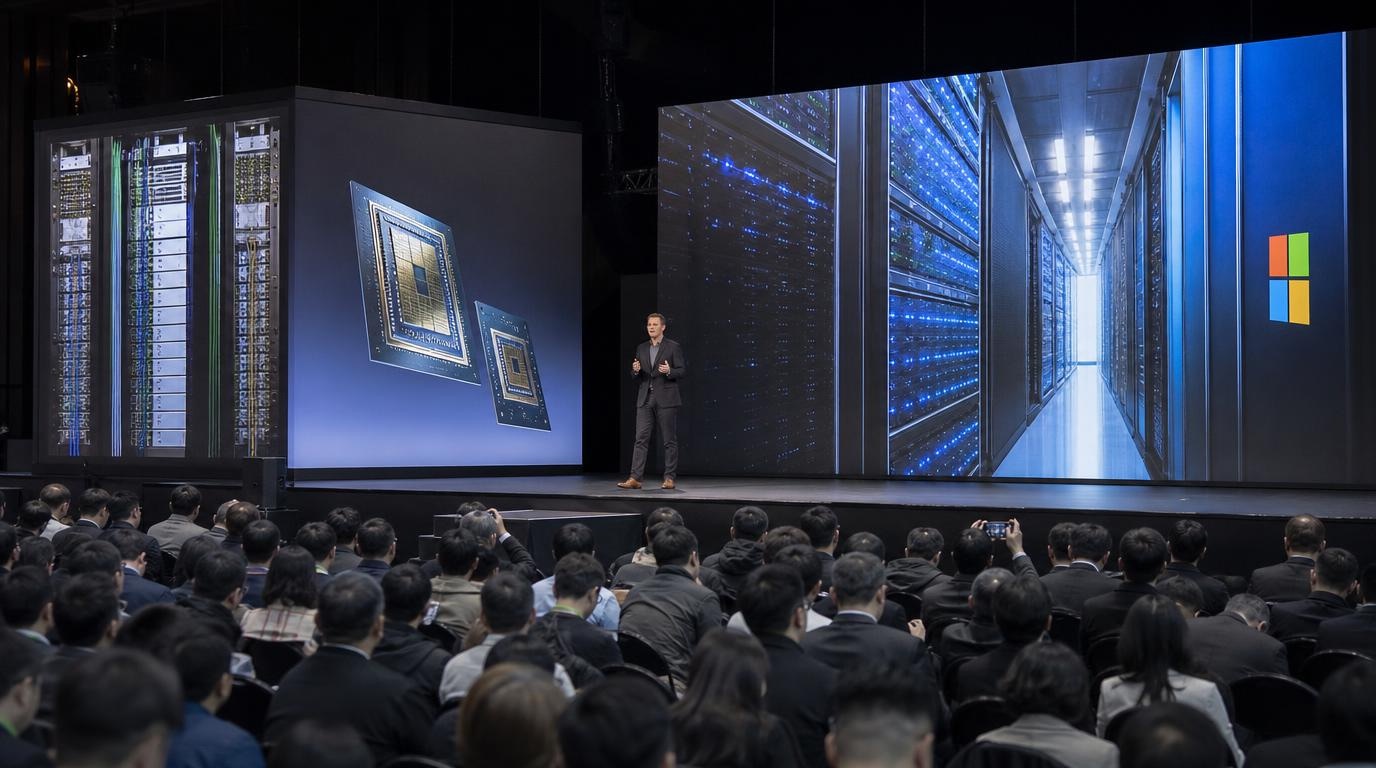
От масштаба строительства к результату
На SEMICON Taiwan 2026 президент Azure Hardware Systems and Infrastructure Рани Боркар предложила дополнить привычный язык мощности дата-центров показателем useful yield — тем, насколько эффективно silicon, memory, networking и power превращаются в полезный результат. Microsoft перечисляет практические измерители: больше tokens per dollar и per watt, выше throughput и ниже latency.
Это не призыв прекратить строительство. Боркар прямо говорит, что миру потребуется новая capacity. Но количество chips, megawatts или racks не показывает, насколько доступной и надёжной становится intelligence для пользователя. Инфраструктура может расти, одновременно теряя эффективность на памяти, сети, охлаждении, software stack или fleet operations.
Ограничение редко живёт на одном уровне
Microsoft связывает следующий прирост эффективности с cross-layer design. Вместо изолированной оптимизации accelerator, network или model команды должны рассматривать всю цепочку: silicon, memory, networking, power, cooling, software, models, workloads и эксплуатацию парка. Самое трудное ограничение нередко устраняется за пределами слоя, где проявился симптом.
Например, недостаточный throughput нельзя автоматически считать нехваткой accelerator capacity. Причиной может быть обмен с памятью, сеть между узлами, планировщик, форма workload или программная реализация модели. Точно так же снижение watts на одном component не гарантирует роста tokens per watt всей системы, если выигрыш съедается дополнительным data movement или охлаждением. Именно поэтому useful yield — системная, а не компонентная метрика.
Единица измерения всё ещё зависит от задачи
В сообщении Microsoft нет одной формулы, которая сводит качество, стоимость и скорость в универсальный коэффициент. Tokens per dollar хорошо подходят для массового inference, но сами по себе не отражают качество ответа. Throughput важен для batch workload, latency — для интерактивного продукта, а tokens per watt — для энергетической эффективности. Организации придётся выбирать набор метрик под конкретный service level и не путать объём генерации с полезностью результата.
Слово useful в данном случае задаёт направление, но не освобождает от product metrics. Если более дешёвая система выдаёт больше токенов, однако чаще ошибается или требует повторных запросов, её фактическая отдача может быть ниже. И наоборот, модель с меньшим raw throughput может выигрывать в workflow, если сокращает число шагов до принятого результата. В официальном материале Microsoft акцент находится на инфраструктурной эффективности, а не на методике оценки качества моделей.
Почему экосистеме придётся работать совместно
Cross-layer optimization невозможно выполнить одной компанией в полном одиночестве. Microsoft перечисляет component, equipment и materials suppliers, utilities, datacenter operators, model builders и software developers. Решение на уровне упаковки chip влияет на охлаждение; доступная power envelope — на конфигурацию rack; форма модели — на память и interconnect. Поэтому локальный максимум одного поставщика может ухудшить итоговую эффективность системы.
Такой подход меняет и разговор о закупках. Сравнивать только peak performance ускорителя недостаточно: заказчику нужны показатели работающего fleet с реальными workloads, включая загрузку, tail latency, энергопотребление и стоимость эксплуатации. Useful yield переносит внимание с презентационной спецификации компонента на производственный результат всей платформы.
Почему это важно
AI-инфраструктура становится одновременно капиталоёмкой и ограниченной доступной электроэнергией. В этой ситуации наращивание capacity без роста отдачи повышает стоимость intelligence и усиливает давление на энергосистему. Microsoft формулирует useful yield как следующий императив: прогресс определяется тем, что выходит из инфраструктуры, а не только тем, сколько ресурсов введено.
Практический вывод: владельцам AI-платформ стоит вести связанный набор production-метрик — tokens per dollar, tokens per watt, throughput и latency — отдельно по моделям и workload classes. Затем надо искать потери между слоями, а не оптимизировать каждый компонент в вакууме. При этом бизнес-результат и качество ответа должны оставаться внешним ограничением: больше дешёвых токенов имеет смысл лишь тогда, когда они дают принятую пользователем работу.
Для сравнения поколений hardware измерения должны проводиться на одинаковых workload, service-level objectives и правилах качества. Сырые peak-показатели для этого недостаточны. Иначе переход на более короткие ответы искусственно улучшит tokens per watt, а увеличение batch size скроет ухудшение интерактивной latency. Полезная панель связывает инфраструктурные показатели с accepted task, error rate и повторными запросами, сохраняя исходные значения по каждому слою. Тогда useful yield становится инструментом инженерного решения, а не новым маркетинговым числом.