Технологии
«40% больше токенов на мегаватт»: Microsoft показала Azure Maia 300 и переводит Maia на мультигигаваттные развёртывания
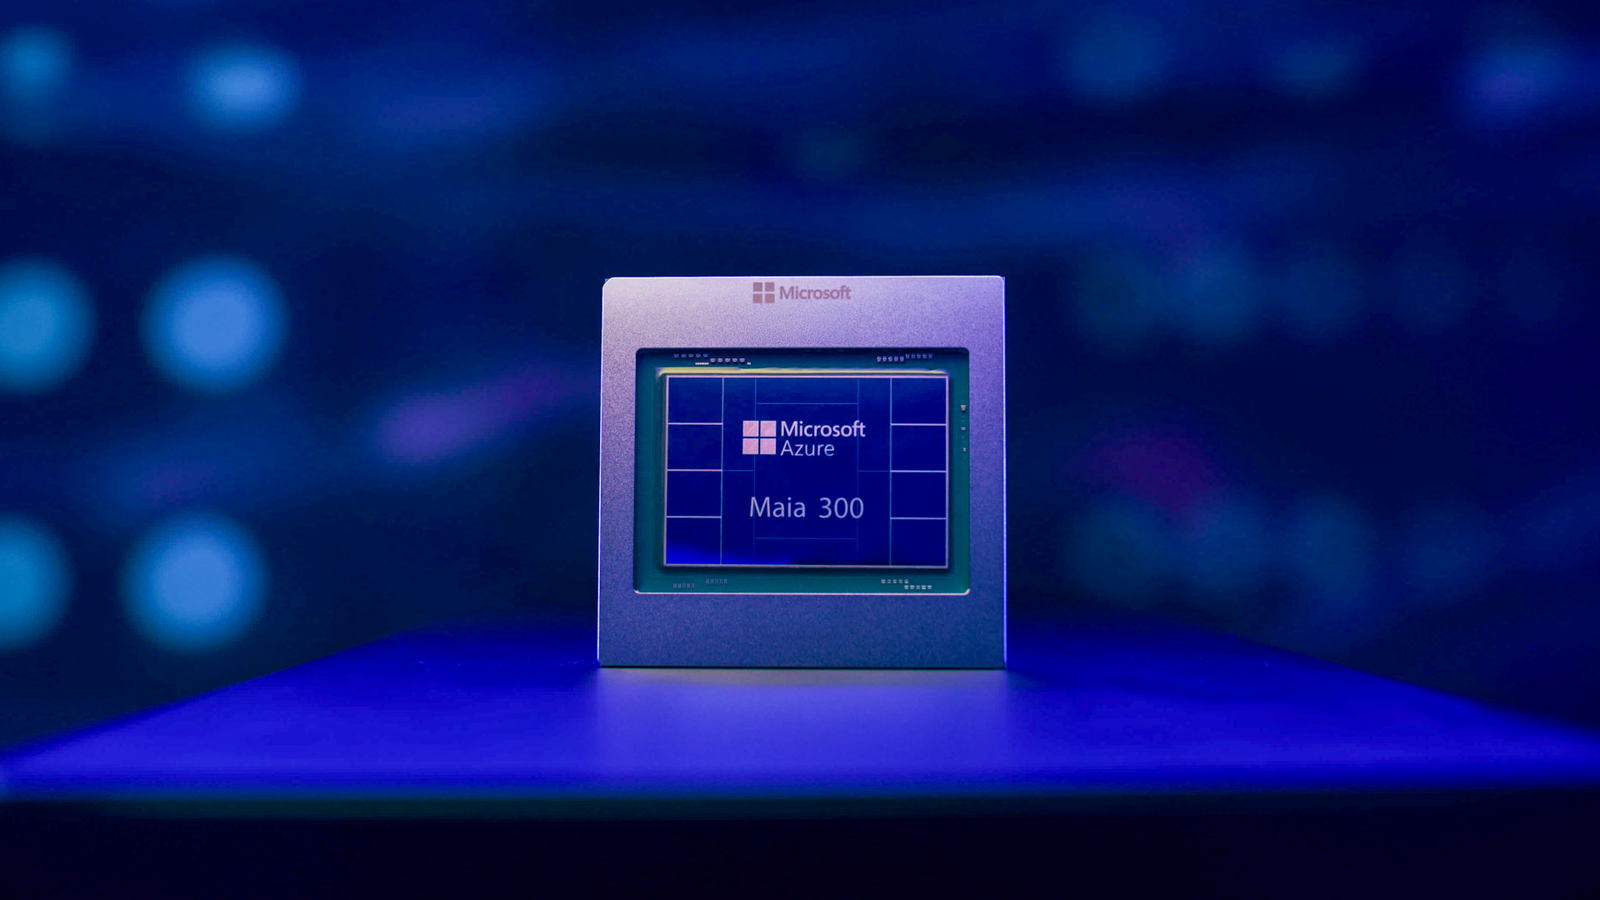
12 октября 2026 года Microsoft объявила, что масштабирует семейство Azure Maia до мультигигаваттных развёртываний начиная с 2027 года и делает Maia основной системой инференса для своих продуктов и сервисов. Первое поколение программы, Maia 200, уже обслуживает продакшн-нагрузки Microsoft, включая Microsoft Copilot и работу команды MAI над моделями следующего поколения, а GitHub Copilot и Microsoft Foundry должны подключиться до конца года. Третье поколение, Maia 300, описано как inference-first система под длинный контекст, чувствительные к задержке разговоры и длительные многошаговые агентные задачи: компания ожидает 40% больше токенов на мегаватт относительно ведущих GPU-систем и до 7-кратной пропускной способности стойки в сравнении с Maia 200. Поставки Maia 300 в продакшн-развёртывания начнутся в 2027 году, а техническая статья раскрывает архитектуру: мультичиплетную компоновку, восемь стеков HBM4, 96 ускорителей в стойке на 167 кВт и суперпод до 12 288 ускорителей.
Что объявила Microsoft
Microsoft переходит в новую фазу инфраструктуры: семейство Azure Maia масштабируется до мультигигаваттных развёртываний начиная с 2027 года, и Maia становится основной системой инференса для продуктов и сервисов компании. Об этом 12 октября 2026 года написал Скотт Гатри (Scott Guthrie), исполнительный вице-президент Cloud + AI, в посте, озаглавленном «Azure Maia 200 в продакшне; Azure Maia 300 — в 2027 году».
Многопоколенческая программа Azure Maia названа фундаментальным элементом стратегии Microsoft в области ИИ-инфраструктуры. Первое поколение, Maia 200, уже обслуживает продакшн-нагрузки Microsoft, включая Microsoft Copilot, и поддерживает команду MAI в разработке моделей следующего поколения; GitHub Copilot и Microsoft Foundry должны подключиться до конца года. На этих нагрузках Maia 200 исполняет модели OpenAI, собственные модели MAI от Microsoft и ведущие семейства открытых моделей.
Maia 300 описана как третье поколение программы и как «полная интеллектуальная система», спроектированная под типы ИИ-нагрузок, которые появляются сегодня: длинное рассуждение с большим контекстом, чувствительные к задержке разговорные сценарии и длительные многошаговые агентные задачи. Архитектура названа inference-first — оптимизированной под длинный контекст, память и декодирование, где балансируются вычисления, полоса памяти, сеть и энергоэффективность в облачном масштабе.
Ставка на перемещение данных, а не на пиковые флопсы
Обе публикации подчёркивают одну мысль: узкое место крупных инференс-систем — перемещение данных, а не сырая вычислительная мощность. «Эффективное перемещение данных, а не сырая вычислительная мощность, всё чаще оказывается узким местом в больших системах инференса», — формулирует это новостной пост.
Технический обзор описывает эту часть как Software Defined Locally Accessed Dataflow Architecture (SDLA): программное обеспечение явно координирует размещение, перемещение, преобразование и синхронизацию данных между специализированными локальными памятями, движками прямого доступа к памяти (DMA), вычислительными движками и сетью, а исполнение тракта данных программируется отдельно от управляющего. Если в Maia 200 память SoC была организована равномерно, то в Maia 300 она становится локально-неравномерной (NUMA) между чиплетами, чтобы ПО размещало данные рядом с использующим их вычислением, а не полагалось на кэширование.
Экономический смысл формулировки тоже заявлен прямо: цель — максимум «полезных токенов на ватт и полезных токенов на доллар», а не абстрактная производительность. На этом основании Microsoft ожидает от Maia 300 на 40% больше токенов на мегаватт по сравнению с ведущими GPU-системами, а в полной конфигурации из 96 ускорителей — до 7-кратной пропускной способности стойки относительно Maia 200.
Что меняется в железе
Новая мультичиплетная архитектура разделяет вычисления, контроллер памяти и функции ввода-вывода. Вычислительные чиплеты строятся на техпроцессе TSMC N2P, где, по формулировке обзора, достигается наибольший выигрыш в производительности на ватт, тогда как кристаллы под контроллеры памяти и ввод-вывод оптимизированы под полосу пропускания, связность и стоимость. Тот же обзор оценивает эффект так: вычислительные флопсы системы растут на 36%, полоса HBM — в 2.5 раза, полоса scale-up-соединений — на 14%.
Память: восемь стеков HBM4 дают 288 ГБ ёмкости и 18 ТБ/с на ускоритель, а новостной пост описывает ту же величину как 18.0 ТБ/с пиковой полосы памяти в рамках 950-ваттного TDP. Относительно Maia 200 это 2.5-кратная пропускная способность памяти, на 33% больше ёмкости и примерно вдвое больше полосы HBM на ватт. Специализированные ядра используют внутрикристальную SRAM как программно управляемый буфер, снижая давление на HBM.
Точность: заявлены расширенный формат MXFP4 и форматы хранения менее 3 бит. Узкие представления сокращают требования и к памяти, и к полосе — как для самих вычислений, так и для хранения KV-кэша, за счёт чего в тот же энергетический конверт помещаются большие окна контекста и более высокая пропускная способность. Векторный движок получил оптимизации под ключевые инференс-ядра, включая softmax и низкоразрядное приведение типов.
Стойка и суперпод
Стойка Maia 300 собирает 96 ускорителей в 24 лотка по четыре ускорителя в пределах 167 кВт, давая 27.6 ТБ ёмкости HBM и 1.7 ПБ/с совокупной полосы HBM в высокоскоростном scale-up-домене. Плотность ускорителей удвоена относительно Maia 200: у каждого лотка есть собственный хост-процессор, память, накопители и охлаждение, а отдельные хост-лотки убраны, чтобы питание и тепловой режим управлялись как одна система.
Сеть встроена в ту же архитектуру: контроллер ИИ-сети реализует собственный AI transport на базе Ethernet, а двухуровневая сеть собирает суперпод до 12 288 ускорителей. Внутри стойки связи электрические, между стойками — оптические: второй уровень соединяет до 128 стоек. Программе предъявляется одна модель коммуникации, и ускоритель может напрямую инициировать обмен с любым ускорителем суперпода, не задействуя хост или отдельный scale-out-адаптер.
Обзор описывает три латентностных домена: напрямую соединённая пара ускорителей, ускорители внутри пода в одном коммутационном переходе и любой ускоритель за пределами пода — в трёх переходах. Деление полосы между внутристоечным и межстоечным трафиком не фиксируется на этапе проектирования системы, а становится параметром под упаковку задач: ускоритель может выдавать до 750 ГБ/с любому соседу в суперподе, когда лишь часть ускорителей уходит за пределы стойки. Там же описаны независимое масштабирование prefill- и decode-воркеров с передачей KV-состояния прямо по scale-up-фабрике и использование горячего резерва из другой стойки при отказе ускорителей.
Сроки и что осталось за кадром
Maia 300 начнёт продакшн-развёртывания в 2027 году. Вместе два поколения должны поддержать более широкий набор сервисов Microsoft: многошаговую агентную работу для GitHub, облачное обслуживание моделей в Microsoft Foundry с разными архитектурами и средами развёртывания, инференс и генерацию данных для команды MAI, а также чувствительные к задержке сценарии Dragon Copilot. Maia 200 при этом продолжает развёртываться в США, Европе и Австралии и даёт до 1.7-кратного превосходства по токенам на ватт для встроенных ИИ-возможностей Microsoft Teams, Copilot и Cowork в сравнении с ведущей GPU-инфраструктурой.
Ближайшая публичная точка — Microsoft Ignite 2026 в Сан-Франциско и онлайн в следующем месяце, где компания обещает больше деталей о стратегии и технологиях. На сайте Maia 300 отдельно выложены фотографии и видео.
В обоих материалах нет ни цен, ни имён заказчиков, ни подтверждённых объёмов поставок, ни независимых замеров. Цифры «40% больше токенов на мегаватт» и «до 7-кратной пропускной способности стойки» — это ожидания Microsoft относительно ведущих GPU-систем и Maia 200 соответственно, а не измеренный результат на сторонних нагрузках.