Технологии
«llama.cpp в трее Windows 11»: Hugging Face выпустила Llama Windows — локальный запуск моделей без терминала и прав администратора
Hugging Face представила Llama Windows — бесплатное приложение с открытым исходным кодом, которое ставит llama.cpp в системный трей Windows 11: модель выбирается из Hugging Face Hub, скачивается одним щелчком и запускается локально прямо из области уведомлений, без терминала, шага сборки и прав администратора. Это Windows-аналог llama.app для macOS, приложение выходит с нативной поддержкой Windows on Arm и нового NVIDIA RTX Spark, скачать его можно с llama.app, а код лежит на GitHub в репозитории ggml-org/Llama-Windows.
Что именно выпустили
Hugging Face объявила о выпуске Llama Windows 13 октября 2026 года: это бесплатное приложение с открытым исходным кодом, которое запускает llama.cpp в системном трее Windows 11.
Модель выбирается прямо из Hugging Face Hub, скачивается одним щелчком и запускается локально из области уведомлений — без терминала, без шага сборки и без прав администратора.
Публикацию подписали сотрудники Hugging Face Морган Фунтович, Джефф Буде и Эмануил Русев, а код приложения открыт на GitHub в репозитории ggml-org/Llama-Windows.
Зачем это нужно локальным моделям на Windows
llama.cpp — самый распространённый движок для запуска открытых моделей локально, а формат GGUF, который он ввёл, стал стандартом локальных моделей на Hugging Face Hub.
На Windows вход в эту экосистему всё ещё начинался с терминала: нужно было подобрать правильный бинарник под своё железо, найти модель, выбрать между квантованными сборками и запустить сервер с нужными флагами.
Llama Windows превращает всё это в несколько щелчков. Приложение адресовано тем, кто хочет получить производительность llama.cpp в нативном для Windows виде, не жертвуя приватностью, и одновременно остаётся самым простым способом для любого пользователя Windows впервые запустить открытую модель на своём компьютере.
Трей, компактная панель и оверлей по Alt+Space
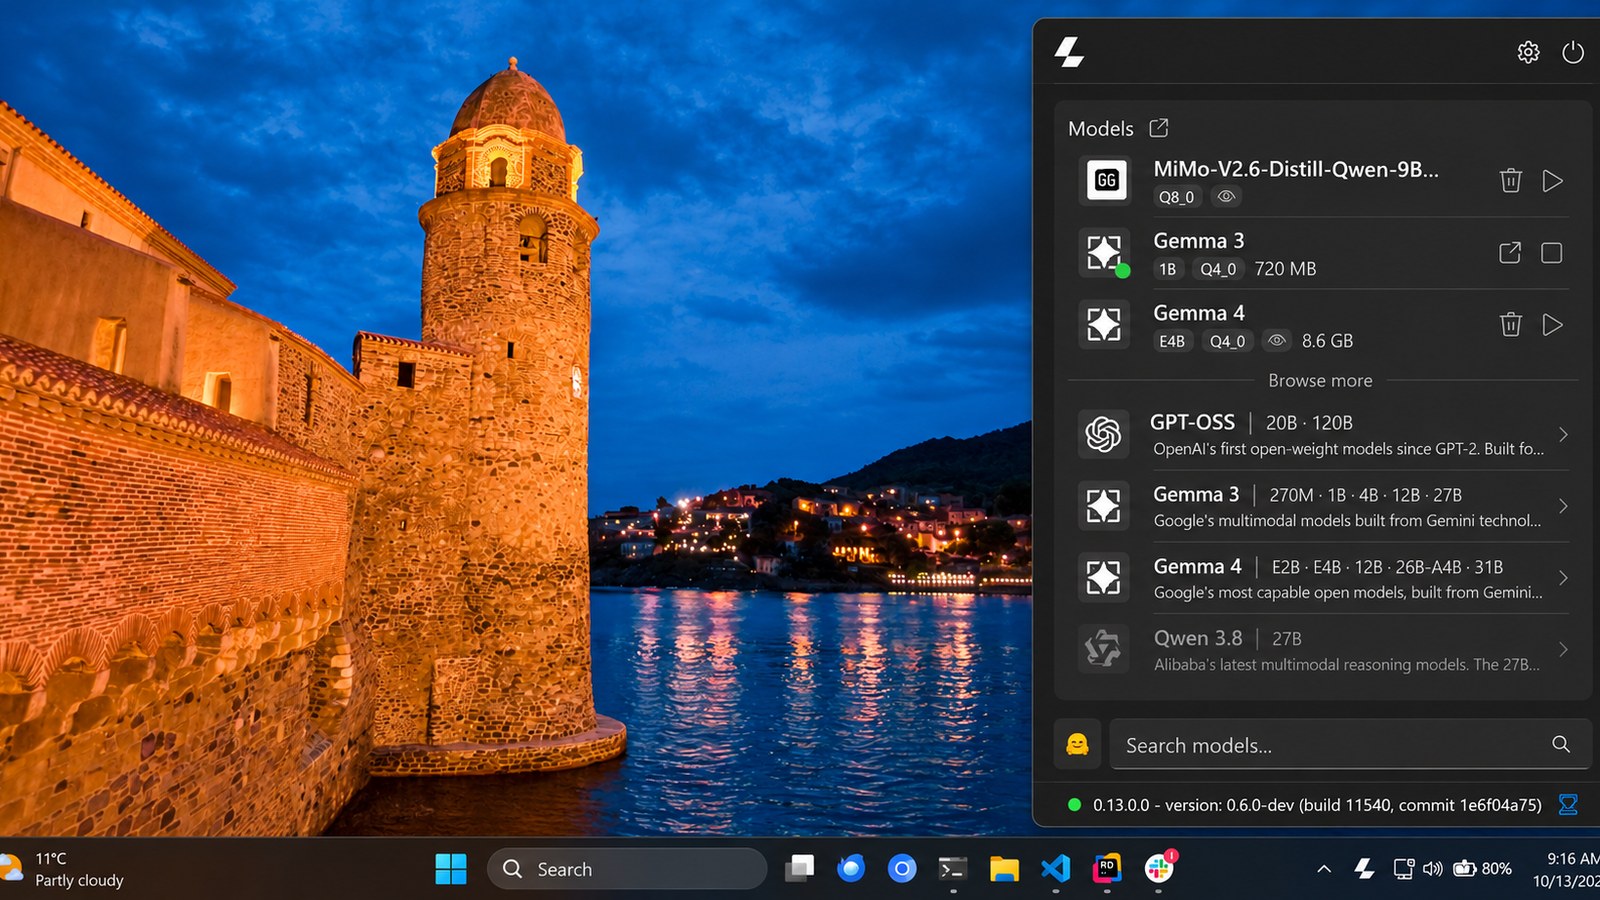
Llama Windows — нативное приложение на WinUI3 в оформлении Microsoft Fluent Design, которое живёт в области уведомлений. Щелчок по иконке ламы открывает компактную панель прямо над ней, окна на панели задач при этом нет, а правый клик по иконке открывает или закрывает приложение.
Отдельная особенность — оверлей: сочетание Alt+Space из любого места системы открывает чат с агентом, не переключаясь на другое окно.
Рантайм обслуживает себя сам. При запуске Llama Windows подключается к уже работающему серверу llama.cpp или запускает тот, которым управляет; если сервер не установлен, приложение ставит llama.cpp официальным инсталлятором — тоже без прав администратора.
Модели одним щелчком и панель уже установленных
Панель Recommended Models показывает готовые к запуску квантованные сборки популярных открытых моделей из Hugging Face Hub: для каждой указаны число параметров, размер на диске и поддержка зрения, то есть модель можно выбрать под свой компьютер ещё до загрузки.
Один щелчок запускает скачивание, а прогресс виден прямо в панели.
Вторая панель, Available, перечисляет модели, уже находящиеся на компьютере: модель загружается и выгружается из своей строки, после чего открывается веб-интерфейс llama.cpp для общения с ней, а строки обновляются на месте, так что панель всегда показывает, что делает сервер.
Локальный сервер на localhost:9931 и OpenAI-совместимый API
Для разработчиков llama.cpp остаётся локальным сервером на http://localhost:9931: свои приложения, скрипты и агенты могут обращаться к тем же моделям, что загружает приложение, через OpenAI-совместимый API.
Посмотреть доступные модели можно командой curl http://localhost:9931/models, а затем достаточно указать любой OpenAI-совместимый клиент на локальный сервер с base_url http://localhost:9931/v1 и api_key "not-needed", подставив идентификатор модели из этого списка.
Всё, что делается через Llama Windows, остаётся на машине: подключение к интернету не требуется, данные никуда не сохраняются.
Модели складываются в стандартный кэш Hugging Face — %USERPROFILE%\.cache\huggingface\hub — общий с llama.cpp и другими инструментами Hugging Face, так что модель можно скачать один раз и использовать везде, а сам кэш при желании переносится на другой диск.
Для закрытых и приватных репозиториев в настройках указывается токен доступа Hugging Face, а ежедневные логи хранятся семь дней в %LOCALAPPDATA%\LlamaApp\logs.
Windows on Arm и NVIDIA RTX Spark
Llama Windows выходит с поддержкой NVIDIA RTX Spark: приложение работает нативно на Windows on Arm, а llama.cpp исполняет модели на GPU RTX Spark.
Поскольку llama.cpp — сильно оптимизированный рантайм, вычислительные ресурсы и память RTX Spark используются полностью, без ручной настройки, а вся работа идёт на устройстве, поэтому подсказки и данные остаются на компьютере пользователя.
Hugging Face отмечает, что работала с NVIDIA, чтобы подготовить Llama Windows к RTX Spark в первый же день.
Как начать
Порядок из публикации такой: на компьютере с Windows 11 перейти на llama.app и скачать Llama Windows, запустить приложение и найти иконку ламы в области уведомлений — при необходимости в меню переполнения.
Затем нужно щёлкнуть по иконке, выбрать модель в разделе Recommended Models и скачать её, а после завершения загрузки — загрузить модель и открыть веб-интерфейс, чтобы начать общение.
Открытый код
Llama Windows распространяется бесплатно и с открытым исходным кодом: на GitHub это приложение на WinUI 3 плюс библиотеки.NET для сервера llama.cpp, клиента Hugging Face Hub и каталога моделей.
Авторы приглашают пробовать приложение, заводить issue и присылать pull request, а также спрашивают, какие модели и функции нужны следующими.