Технологии
Карты чувствительности тензоров: как bartowski переписал раскладку GGUF-квантов
Автор GGUF-сборок bartowski потратил около 96 часов и построил более 1000 квантов, чтобы выяснить, какие тензоры модели действительно чувствительны к сжатию. На этих данных появился solver, канареечные тесты и новое значение суффиксов S, M и L.
Проблема: правила, одинаковые для всех моделей
Главный недостаток и апстримного кода, и собственных правок bartowski формулирует прямо: они всегда остаются модельно-агностичными. Да, они зависят от формы тензора и используют хитрые проверки глубины модели, например use_more_bits, которая помечает слои в первой восьмой части, в последней восьмой или каждый третий слой посередине как «важные» — но дальше этого эвристика не идёт. Именно поэтому апстримная логика плохо справляется с MoE-моделями, где экспертов больше восьми, а маленькие тензоры shexp оказываются на удивление чувствительными.
Как собирали данные
Кампания заняла около 96 часов и дала более 1000 построенных и оценённых квантов разных размеров. Схема была двойной: прогоны degrade-one, где все тензоры стоят в q8_0, а один — в q2_k, и прогоны upgrade-one, где всё наоборот. Второй тип оказался почти бесполезным — большинство прогонов давали шум, — поэтому основу анализа дал первый.
Базовыми моделями стали Qwen3.5-0.8B и Qwen3.5-4B. Качество измеряли KL-дивергенцией между вероятностями токенов квантованной и bf16-модели через llama-perplexity с флагом kl-divergence на датасете wikitext-2-raw при контексте 512: чем меньше, тем лучше. Считать всё это помогал десктоп AMD AI Max+ 395 со 128 ГБ памяти, который прислала Framework, а каркас для экспериментов автор писал вместе с Claude.
Что показали измерения
Токеновые эмбеддинги доминируют по чувствительности: их вклад в повреждение примерно в 8 раз больше худшего весового тензора у модели на 0.8B и в 16 раз — на 4B. При этом значительную часть качества возвращает q4_k, так что q8_0 для эмбеддингов уже не обязателен.
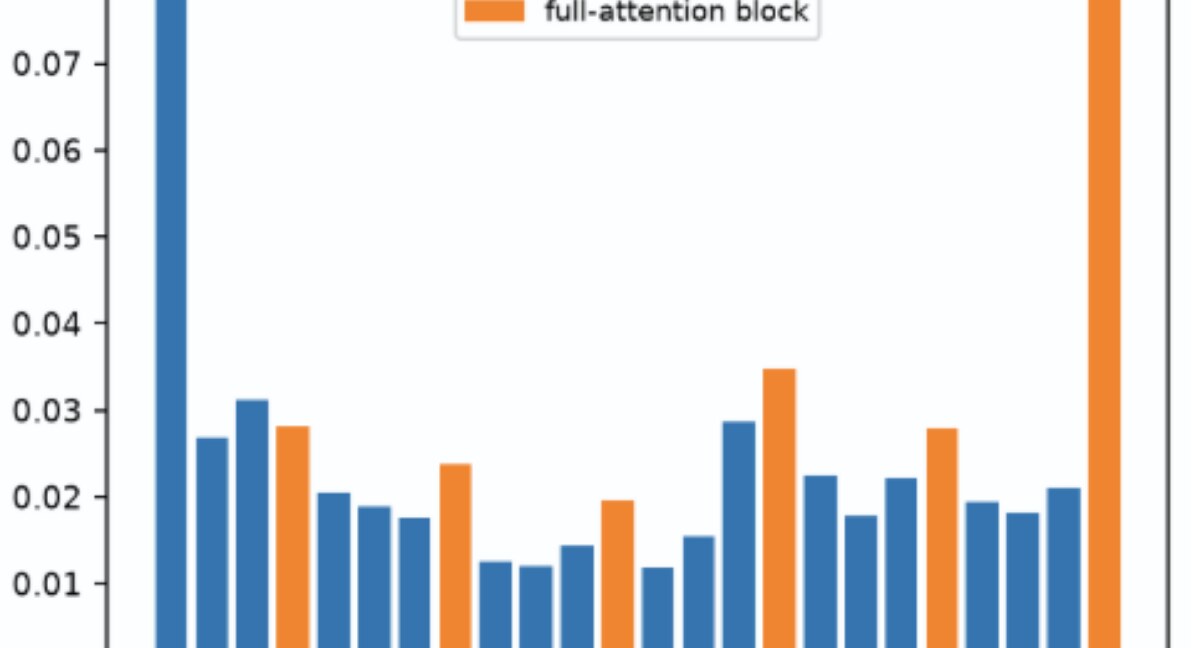
Глубина даёт U-образную кривую чувствительности. В расчёте на бит самыми чувствительными оказались небольшие проекции внимания — attn_v, attn_output, ffn_up и ssm_out выделяются на общем фоне, — а ffn_gate, по наблюдению автора, почти никогда не заслуживает дополнительных битов.
Solver: раскладка вместо эвристики
На этих данных появился solver: он получает на вход форму модели, предварительную карту чувствительности, базовые сведения о размерах блоков ggml и целевой тип кванта. Модель повреждения в нём аддитивная: damage(layout) = sum_i s_i * r(t_i), где s_i — чувствительность тензора из замороженной кросс-модельной карты, а r(t) — повреждение типа относительно q2_k.
Solver умеет не только повышать, но и понижать разрядность отдельных тензоров, хотя K-кванты почти никогда не выигрывают от понижения: разрыв между их типами слишком велик. Отдельная цель работы — вернуть предсказуемость именам вроде Q3_K_S: суффикс S должен означать, что не менее 90% тензоров тела модели относятся к заявленному типу. В карточках моделей правило описано проще: около 90% для S, 70% для M и 50% для L.
Обобщение и канареечный тест
На вопрос, работает ли метод за пределами двух Qwen-моделей, автор отвечает серией проверок: через них прошли Qwen-3.6-35B-A3B, Gemma 4 E4B, granite-4.2-8b, Ling 3.0 tiny и flash, MiniCPM5-2B, Muse Glimmer и DeepSeek-V2-Lite. Первый проход оказался неудачным: solver не выигрывал, а плотные раскладки с полным вниманием у granite и MiniCPM и модель DeepSeek-V2-Lite провалились сразу. Проблему сняли несколькими правками генератора и его предварительной карты, после чего решение удалось сделать обобщаемым. Отдельно отмечено, что ниже примерно 3 бит плотные модели идут практически вровень со старым методом.
Поэтому для каждой новой формы модели теперь прогоняется канареечный тест: кванты Q4_K_M, Q3_K_M и IQ2_XS (или самый мелкий целевой) строятся и по карте, и по правкам в llama.cpp, после чего шесть значений KLD наносятся на кривую «KLD на бит». Если квант по карте оказывается выше кривой заметнее шума, карта отклоняется, и система возвращается к собственной эвристике. Числа тестов публикуются вместе с моделью в разделе Per-tensor layouts — например, у сборки MiniCPM5-2B-GGUF.
Что меняется на практике
Суффикс L сменил смысл: раньше он означал «предыдущий квант, но с q8_0 для эмбеддингов и выхода», теперь Q4_K_L и Q6_K_L — это бюджет по типам тензоров. Из набора исчезли Q2_K_L, Q3_K_XL и Q5_K_L.
Размеры файлов тоже изменились: Q3_K_M для Qwen3.5-4B стал на 15% меньше. А Q4_K_M получил чуть худшую общую KLD, но стал более чем на 5% меньше, то есть выиграл в расчёте на бит. K-квантам запрещено смешиваться с IQ-тензорами ради совместимости, IQ-кванты такого ограничения не имеют, а очень маленькие тензоры принудительно переводятся в F32.
Ограничения и планы
Автор прямо перечисляет слабые места работы: KLD считалась только на wikitext, и не помешает проверить метод на другом датасете. Предварительная карта строилась по двум небольшим Qwen-моделям и granite, хотя тесты говорят в пользу её обобщаемости. Выше примерно Q5 повышения разрядности почти неотличимы от шума, и гипотезу о сохранении логики доказать трудно.
Дальше — полная карта для Qwen3.8-27B и сравнение KLD с исходной публикацией. В планах также гигантская n-gram-таблица PLE у Qwen3.8-Flash-Next и необычный gated MLA со sparse attention у Hy4-preview, к которым текущий скрипт пока не готов.
Первоисточники
- Per-tensor layout maps for GGUF quantization — bartowski, Hugging Face Blog, 10 сентября 2026
- llama.cpp v0.4.0 — src/llama-quant.cpp (эвристика llama_tensor_get_type_impl)
- quantization-config — layout/solver.py (per-tensor type solver)
- bartowski/MiniCPM5-2B-GGUF — раздел Per-tensor layouts с канареечными метриками