Технологии
«V100 всё ещё работает почти десять лет»: CoreWeave вывела Vera Rubin NVL72 в продакшн, а Cognition первой получила до 4,8 раза больше токенов
CoreWeave объявила о доступности систем NVIDIA Vera Rubin NVL72 с сетью Spectrum-X 102,4T Ethernet на своей конференции Fully Connected в Сан-Франциско, а Cognition — разработчик ИИ-инженера Devin — стала первым заказчиком, запустившим на этой системе продакшн-нагрузку. На бенчмарке, который поставили инженеры самой Cognition, суммарная пропускная способность токенов на инференсе SWE-2 выросла до 4,8 раза против базовой линии GB200 NVL72, а на нагрузках обучения с подкреплением выходных токенов стало в 3,8 раза больше. CoreWeave также обещает предложить NVIDIA Vera — первый CPU, спроектированный под AI-агентов, и запустила среду CoreWeave Forge.
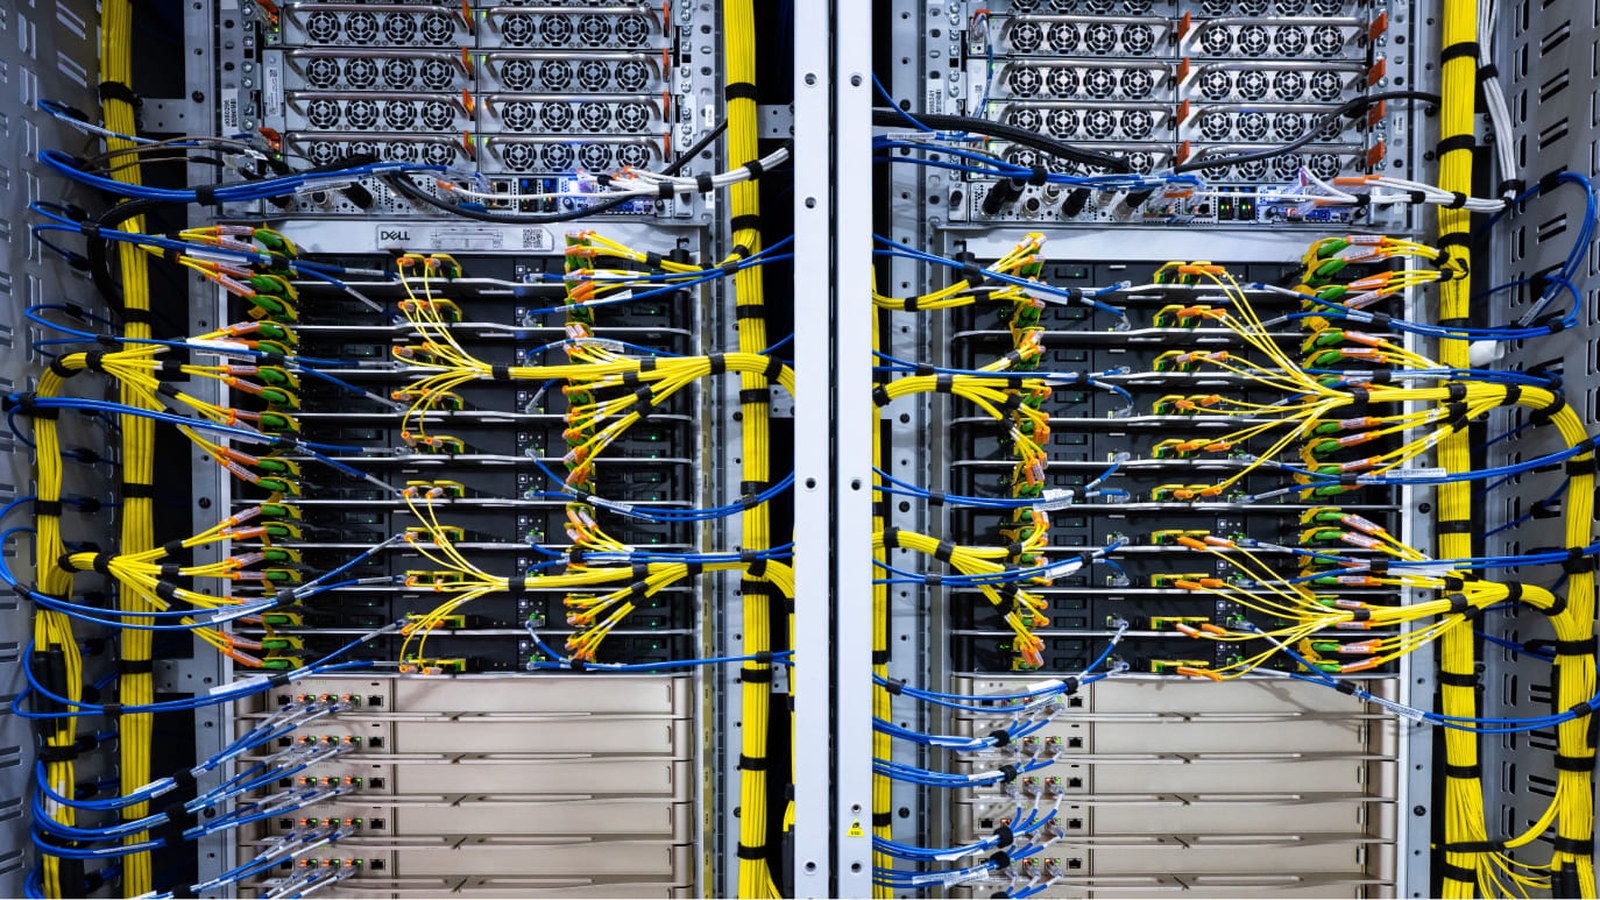
Что объявили две компании
30 сентября 2026 года NVIDIA и CoreWeave рассказали об одном и том же шаге с двух сторон: CoreWeave объявила о доступности систем NVIDIA Vera Rubin NVL72 с сетью Spectrum-X 102,4T Ethernet на своей конференции Fully Connected, которая проходит в Сан-Франциско. Первым заказчиком, запустившим на Vera Rubin продакшн-нагрузку, названа Cognition — прикладная AI-лаборатория, стоящая за ИИ-инженером Devin.
Вместе с системами CoreWeave обещает предложить NVIDIA Vera — первый CPU, построенный под AI-агентов, и объявила о запуске CoreWeave Forge, среды, в которой обучение, оценка и доработка моделей и агентов сведены в один контур. Эксплуатировать ёмкость можно через CoreWeave Kubernetes Service, SUNK, CoreWeave Mission Control, CoreWeave Sandboxes и CoreWeave Inference. Масштаб конференции CoreWeave оценивает более чем в 4 500 заказчиков, партнёров, разработчиков и AI-лидеров.
Почти десять лет на одном железе
Аргумент NVIDIA строится не на пиковых цифрах, а на сроке службы платформы. «Ускоренные вычисления NVIDIA приносят ценность через поколения», — приводит блог слова Ian Buck, вице-президента по hyperscale и высокопроизводительным вычислениям NVIDIA: GPU NVIDIA V100 всё ещё обслуживают клиентские нагрузки почти десять лет после выхода Volta, и в этом сила платформы — инфраструктура, которая «зарабатывает годами», плюс гибкость положить нужный GPU на нужную нагрузку.
CoreWeave называет ту же точку отсчёта: отношения с NVIDIA начались в 2017 году с поколения Volta, которое до сих пор в коммерческой эксплуатации в облаке CoreWeave. Единый программный стек — CoreWeave Kubernetes Service, SUNK, CoreWeave Mission Control, CoreWeave Sandboxes и serverless-инференс — даёт заказчикам одинаковый способ разворачивать нагрузки на разных поколениях GPU, сопоставляя каждую задачу с подходящей ёмкостью.
Cognition: 4,8 раза на своём бенчмарке
Cognition запускает на CoreWeave обучение, обучение с подкреплением и продакшн-инференс для Devin. По данным NVIDIA, компания выросла до тысяч GPU за девять месяцев; по формулировке CoreWeave — от bridge-ёмкости до тысяч GPU для обучения и инференса менее чем за девять месяцев.
Бенчмарк поставили инженеры самой Cognition: получив первые продакшн-стойки Vera Rubin NVL72, они сравнили инференс с базовой линией GB200 NVL72 на реальной нагрузке разработки ПО, для чего отобрали часть задач из FrontierCode и запустили на них AI-агентов. В ранних тестах прирост суммарной пропускной способности токенов на инференсе SWE-2 составил до 4,8 раза против GB200 NVL72, что для Devin означает более быструю генерацию кода в реальном времени и более отзывчивое многошаговое рассуждение.
CoreWeave уточняет, что это первый бенчмарк инференса Vera Rubin, выполненный самим заказчиком, и что помимо 4,8 раза на SWE-2 инженеры Cognition зафиксировали 3,8-кратный рост пропускной способности по выходным токенам на нагрузках обучения с подкреплением — без потери скорости генерации. «Агентное программирование — неумолимая нагрузка: длинные контексты, высокая конкурентность и быстрые рассуждения», — говорит Silas Alberti из Cognition, добавляя, что в агентной нагрузке, где каждый шаг ждёт предыдущего, такой прирост складывается в реальную работу, которую выполняет Devin.
Vera CPU: более 11 000 изолированных сред в одной стойке
Агентный AI давит на инфраструктуру с двух сторон: обслуживание агентов требует низкой задержки на масштабе, а доработка моделей — тысяч изолированных сред, работающих одновременно. Развёртывание Vera CPU у CoreWeave даёт 128 процессоров и 11 264 ядра в одной стойке — этого достаточно более чем для 11 000 одновременных сред по одному ядру каждая. Такие среды аппаратно изолированы, работают рядом с обучающими задачами, которые они поддерживают, а связь обеспечивают коммутаторы Spectrum-X Ethernet и DPU BlueField-4.
В тестах CoreWeave получила более чем трёхкратное ускорение запуска агентных песочниц на процессорах NVIDIA Vera. На Terminal-Bench прирост производительности на Vera CPU составил 1,7 раза по всем пройденным задачам. Сами песочницы — это слой исполнения для обучения с подкреплением, использования инструментов агентом и оценки моделей, позволяющий запускать код в изолированных средах.
Forge: из продакшна обратно в обучение
Идея Forge в том, что модели и агенты улучшаются в цикле: поведение в продакшне питает следующий прогон обучения, а каждая оценка уточняет следующую версию. Исторически этот цикл был разложен по инструментам разных поставщиков, и на каждой передаче сигнал терялся; Forge сводит Weights & Biases, экспертизу пост-тренировки из OpenPipe и открытый проект блокнотов marimo в одну связанную среду, оставаясь открытой для моделей, фреймворков и облаков.
Что доступно по итогам анонса: CoreWeave ARIA стала общедоступной — сервис помогает анализировать прогоны, предлагает эксперименты и изменения кода, сохраняет их в GitHub и возвращает доказательства; CoreWeave Agent Lens — новый сервис, превращающий наблюдаемость агентов в продакшне в постоянное улучшение, по данным NVIDIA он улучшает обнаружение сбоев на 20% и исправляет проблемы вдвое дешевле; CoreWeave Sandboxes стали общедоступными.
Серверный файнтюнинг с учителем и серверное обучение с подкреплением позволяют экспериментировать со своими рецептами: серверный RL, по заявлению NVIDIA, обучается в 1,4 раза быстрее и на 40% дешевле, чем самостоятельно управляемая конфигурация. Открытый фреймворк инференса NVIDIA Dynamo питает управляемый сервис инференса CoreWeave и RL Rollouts, которые находятся в закрытом превью: новая контрольная точка загружается в живое развёртывание на ходу, без перезапуска. Среди первых компаний, строящих на Forge, названы Canva, Capital One и MasterClass, а открытые модели NVIDIA Nemotron дают путь к кастомизации моделей под агентные сценарии.
Заказчики и позиции на рынке
В здравоохранении CoreWeave выбрала Ennoble Care — поставщик помощи на дому, обслуживающий около 50 000 пациентов Medicare с высокими потребностями в 15 штатах: он будет запускать клинический инференс на зарезервированной ёмкости GPU NVIDIA RTX PRO 6000 через CoreWeave Kubernetes Service для агентов клинической документации, поддержки решений и бэк-офисной автоматизации.
CoreWeave напоминает про рекордные результаты MLPerf в каждом раунде обучения и инференса, про единственный у облачных провайдеров платиновый рейтинг в SemiAnalysis ClusterMAX 1.0, 2.0 и 3.0 и про то, что её услугами пользуются девять из десяти ведущих AI-лабораторий. В собственном пресс-релизе CoreWeave добавляет, что вместе с Dell Technologies была среди первых облаков, развернувших Dell PowerRack с NVIDIA GB200 и GB300 NVL72, и одной из первых развернула NVIDIA Vera Rubin, а также опубликовала первые в отрасли измеренные показатели производительности кремния на этой платформе — 10-кратную пропускную способность токенов на мегаватт против NVIDIA GB200 NVL72 на модели рассуждений DeepSeek R1 при сопоставимой интерактивности.