Технологии
«Здоровая система — не то же самое, что выполненная задача»: AWS описала Trust in Depth — четыре слоя доверия к агентам
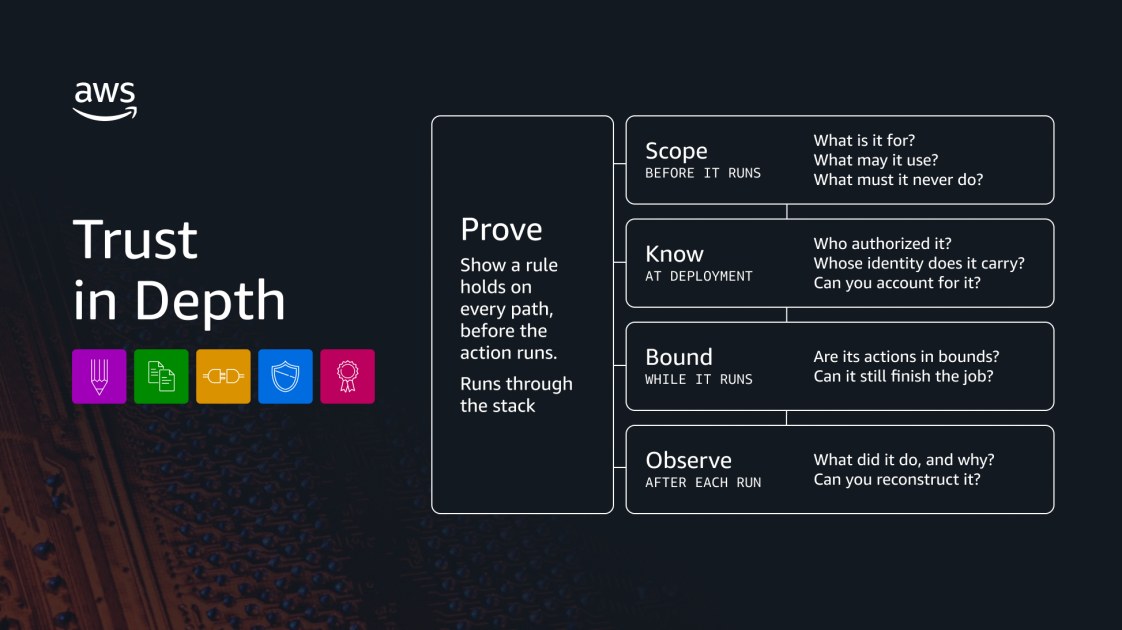
15 октября 2026 года AWS опубликовала в блоге Machine Learning программный текст о том, как дать агентам больше автономии, не потеряв контроль, и назвала свой подход Trust in Depth — «доверие в глубину». Каркас состоит из четырёх слоёв: Scope (очертить задачу и доступы до запуска), Know (знать каждую действующую от имени компании сущность), Bound (ограничивать действия во время работы) и Observe (восстанавливать, что именно сделал агент). Главный инструмент, на который опирается AWS, — автоматическое рассуждение: логика, которая проверяет, что правило выполняется в каждом возможном случае, и либо доказывает это, либо находит конкретный случай, где оно ломается. Пределы подхода компания называет сама: это её собственная рамка, доказуемо не всякое правило, и независимых замеров в тексте нет.
Суть предложения
Текст начинается с наблюдения, знакомого корпоративным заказчикам: агенты должны делать больше, но им не доверяют делать это правильно каждый раз. Причина сформулирована без смягчений: та же автономия, из-за которой агенты полезны, мешает их проверять — агент сам выбирает инструменты и последовательность шагов, две попытки одной задачи могут идти разными маршрутами, а пройденный сегодня тест мало говорит о том, что будет завтра.
Ответ «человек в контуре на каждое действие» AWS называет рабочим только в малом масштабе: при росте объёма одобрений накапливается усталость проверяющего, люди перестают замечать то, что действительно важно, а осторожность становится узким местом, из-за которого способные на большее агенты простаивают на ценной работе. Предлагаемая альтернатива — позволять агенту действовать самостоятельно там, где его действия можно проверить, и оставлять человеческое суждение для решений, которые его требуют.
Формально каркас описан как ответ на четыре вопроса по жизненному циклу агента: что это за агент, какие возможности требует его работа и чего он не должен делать никогда — до запуска; кто его авторизовал, какую личность он несёт и можно ли отчитаться за каждого действующего агента — при развёртывании; остаются ли его действия в заданных пределах и способен ли он при этом делать свою работу — во время работы; можно ли восстановить, что агент сделал и почему — после каждого запуска.
Название выбрано по аналогии с Defense in Depth — многослойной защитой, которую индустрия практикует два десятилетия. Разница сформулирована в одну фразу: где Defense in Depth ограничивает то, что может пойти не так, новый подход расширяет то, что можно безопасно разрешить.
Scope: правила до запуска
Первый слой AWS считает самым дорогим по усилиям и самым выгодным: ошибки, пойманные здесь, дёшевы в исправлении. Очертить агента означает решить, какую работу он ведёт, к каким инструментам, данным и сервисам имеет доступ, каким правилам следует и какие решения остаются за человеком. Отдельно названа типовая ошибка: выдать административную роль под одну задачу и тем самым позволить агенту унаследовать права на всю среду.
В этом слое AWS называет два своих инструмента: Kiro — агентную систему для разработки, которая превращает намерение в спецификацию требований и применяет автоматическое рассуждение, чтобы выявить противоречия, неоднозначности и пробелы до того, как написан код, и вывести проверки свойств, тестирующие реализацию на широком диапазоне входов; и Strands — открытый набор инструментов для описания модели, инструкций и инструментов агента вместе с управляемым рантаймом.
Правила, заданные на этом слое, применяются через Policies в Amazon Bedrock AgentCore: доступные инструменты, API и данные описываются обычным языком, а автоматическое рассуждение проверяет политику на пробелы — например, на правило, дающее слишком широкий доступ, — и на противоречия, из-за которых правило не может быть выполнено никогда, ещё до того, как оно вступит в силу.
Отдельно стоит отметить, что обе поверхности Mantis описывала и раньше: AWS Agent Registry — 6 августа 2026 года, а Policy в AgentCore — в разборе контрактного интеллекта 29 сентября. Новое в этом тексте — не отдельная возможность, а попытка собрать их в один именованный каркас и явно назвать ответ на каждый из четырёх вопросов.
Know: у каждого агента своя личность
Второй слой исходит из того, что нельзя управлять тем, чего не видно: команды создают агентов быстрее, чем кто-либо успевает их учитывать, а агент, о котором никто не знает, никем не контролируется. Требование сформулировано буквально: у каждого агента должна быть своя личность, проверяемая при каждом действии, чтобы не оставалось действий без владельца и можно было сказать, какой именно агент что сделал и кто его на это уполномочил.
Для этого AWS ссылается на AWS Agent Registry — управляемый каталог одобренных агентов, серверов Model Context Protocol, инструментов и навыков организации: администраторы используют процесс одобрения, чтобы решать, что становится доступным для обнаружения, и убирать то, что больше не соответствует требованиям безопасности, соответствия и качества. Каталог при этом лишь описывает, что существует; личности агентам выдаёт AgentCore и проверяет их на каждом запросе, чтобы каждое действие отсылало к конкретному агенту с известными полномочиями.
Bound: границы вне рассуждений агента
Третий слой отвечает на риск, который AWS иллюстрирует примером: агент может сделать десять одобренных шагов и всё равно прийти к результату, которого никто не хотел — раскрыть чувствительные данные, уйти от темы или сложить разрешённые действия в запрещённую комбинацию. Вывод сформулирован прямо: пусть агент сам выбирает, как выполнять задачу, но не полагайтесь на то, что он сам будет следить за своими ограничениями — пределы должны жить в среде вокруг агента и проверяться детерминированно, по всей последовательности действий, а не по одному шагу.
Технически это Policy в AgentCore: политика применяется на каждом вызове инструмента, проходящем через AgentCore Gateway — защищённую точку входа для агентов, инструментов и моделей. Поскольку проверка находится вне рассуждений агента, те же проверки сохраняются, даже если агент содержит ошибку, скомпрометирован или получил внедрение в промпт: он не может отключить контроль, который сам не исполняет. Полномочия при этом не обязаны оставаться неизменными — временные политики учитывают, что уже произошло в сессии, и корректируют права по ходу работы.
Тем же слоем AWS относит Amazon Bedrock Guardrails, который управляет тем, что агент говорит и что ему сообщают: фильтрует вредное содержание и уводит от темы, скрывает чувствительные данные. Автоматические проверки рассуждением идут дальше — они доказывают, что ответ согласуется с заданной политикой, а не с интерпретацией политики моделью. Отдельно упомянут Strands Box, открытая песочница, которая ограничивает доступ агента к файлам, сервисам и учётным данным извне его инструкций, причём одинаково от первой локальной сессии разработчика до продакшена.
Observe: здоровье системы — не выполненная задача
Четвёртый слой построен на различении, которое AWS формулирует одной фразой: здоровая система — не то же самое, что выполненная задача; агент может ответить за миллисекунды, без единой ошибки и при всех зелёных дашбордах, и всё же сделать не то. Причины перечислены: неверно найденная информация, не тот инструмент, неожиданный маршрут. Чтобы это ловить, нужно восстанавливать, что агент действительно делал: полученный контекст, вызванные инструменты, применённые решения политик и результат.
Для этого назван Amazon CloudWatch Omni: он записывает каждую трассу и раскладывает шаги агента — от вызовов модели до обращений к инструментам — на временную шкалу, которую команда может разбирать. Встроенные оценки проверяют ответы по тому, что обычный мониторинг пропускает: корректность, верность источнику и правильность выбора инструмента. Трассы, где агент ошибся, становятся набором данных для проверки исправления — то есть эксплуатация агента и его улучшение опираются на одни и те же доказательства.
Тестирование до развёртывания при этом не отменяется: продакшен, по формулировке AWS, добавляет доказательства о поведении в реальных условиях и даёт операторам то, что нужно для разбирательства, вмешательства и улучшения.
Пример: уход сотрудника
Вторая половина текста — разобранный сценарий. Менеджер поручает агенту поддержки оформить уход аккаунт-менеджера: снять доступы, передать его почтовый ящик преемнику и освободить лицензию, которую компания больше не использует. Осложнение в том, что в письмах уходящего могут быть доказательства для клиентского спора, поэтому неверная последовательность либо оставит доступ после ухода, либо поставит доказательства под угрозу — и требования есть у четырёх подразделений сразу, хотя полный регламент никто не написал.
Правил всего два: вход сотрудника должен быть заблокирован до того, как его ящик станет общим, а до смены лицензии агент обязан проверить наличие судебного удержания и подтвердить, что изменение сохраняет защиту записей. В слое Scope эти правила записываются политиками в AgentCore, и агент получает ровно шесть инструментов — заблокировать вход, проверить удержания, наложить удержание, преобразовать ящик, дать доступ преемнику и сменить лицензию; инструмента удаления аккаунта у него нет, потому что общий ящик требует его существования.
Дальше сценарий показывает, как слои работают вместе: агент пытается преобразовать ящик раньше блокировки входа — политика на AgentCore Gateway останавливает вызов, потому что старые учётные данные продолжили бы открывать ящик; агент блокирует вход и повторяет; затем переходит к освобождению лицензии, но шлюз блокирует и это, потому что список судебных удержаний никто не проверял. После проверки агент накладывает удержание, подтверждает его действие и только потом меняет лицензию — компания возвращает себе более широкую лицензию, сохраняя доказательства. Задачу агент завершает без пошагового одобрения человеком, а записанные шаги позволяют проверить, что доступ был закрыт, преемник получил ящик, а записи остались защищены.
Границы применимости
AWS сама обозначает предел подхода: автоматическим рассуждением можно проверить не всякое правило. «Только менеджер может одобрить доступ» доказуемо, «сохранять дружелюбный тон» — нет. Там, где доказательство неприменимо, компания предлагает ограничивать доступ и действия агента, оценивать его поведение и отдавать настоящую неоднозначность человеку.
Ещё одна оговорка касается силы доказательства: результат автоматического рассуждения верен ровно настолько, насколько верны правила и допущения за ним, поэтому самая сложная работа приходится на этап до запуска агента. Автономию предлагается расширять постепенно — по мере того как подтверждается, что нужные правила действительно исполняются, агент стабильно справляется с задачей, а сбои обнаруживаются и обрабатываются.
Из опыта приведена одна цифра: автоматическое рассуждение AWS использует в продакшене более десяти лет — от IAM, обслуживающего свыше 2,1 млрд запросов в секунду, до AWS Nitro Hypervisor, Amazon S3 Block Public Access и VPC Reachability Analyzer. Замыкает текст приглашение, адресованное не только клиентам AWS: компания считает, что ответить на четыре вопроса с доказательствами должна уметь любая организация, разворачивающая агентов на любой платформе.