Технологии
SageMaker направляет одинаковые prompts к тёплому KV cache
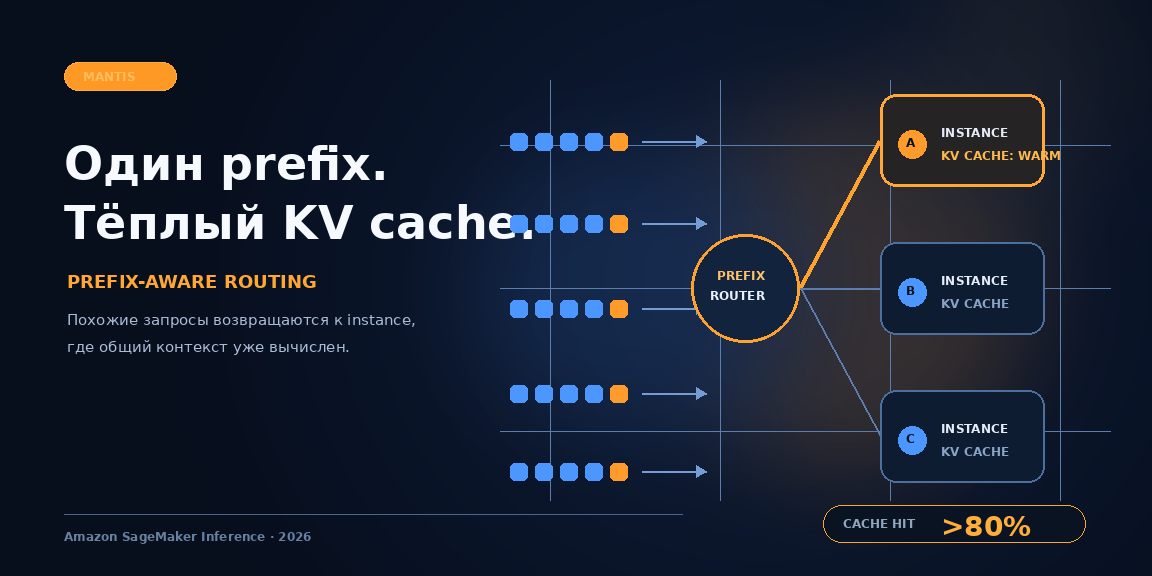
Prefix-aware routing закрепляет запросы с общим началом за одним instance, но уступает перегруженный traffic свободному узлу. В тестах AWS длинный общий контекст сократил медианное время до первого token на 71–77%.
Одинаковый prefix перестаёт блуждать между instances
Amazon SageMaker Inference получил стратегию PREFIX_AWARE для real-time endpoints. Она анализирует начало запроса и старается направлять payload с тем же prefix на тот же instance. Так локальный KV cache serving framework повторно использует уже вычисленные key-value pairs, а модель обрабатывает только изменившийся хвост prompt. Для типового assistant это может быть постоянная system instruction, большой справочный документ или накопленная история диалога.
Обычное случайное распределение мешает prefix caching на fleet из нескольких машин. Один и тот же контекст последовательно попадает на разные instances, каждый вычисляет его заново, а локальные caches получают слишком мало повторений. Prefix-aware routing переносит знание о сходстве запросов в endpoint layer: приложение не обязано вручную ставить affinity tag каждому prompt.
Это не общий распределённый cache и не перенос KV tensors между GPU. Выигрыш возникает потому, что похожие запросы чаще возвращаются к локальному состоянию конкретного instance. Поэтому стратегию нужно оценивать вместе с жизненным циклом replica: cold start, scale-in и смена model version по-прежнему могут удалить накопленное состояние.
Баланс защищают overflow и устойчивое перераспределение
Жёсткое закрепление популярного prefix могло бы создать hot spot, поэтому AWS добавила overload protection. Параметр ConcurrencyThreshold задаёт предел одновременных запросов на целевом instance; после него новый запрос уходит менее загруженной машине. На этом вызове вероятен cache miss, зато одна очередь не блокирует весь endpoint.
При добавлении или удалении instances стратегия сохраняет прежнее размещение для большей части traffic и перемещает только долю запросов, необходимую для новой конфигурации fleet. Это снижает массовое охлаждение caches во время autoscaling. Однако стабильность маршрута не равна гарантии cache hit: разные serialization, изменённые первые символы или переполнение выбранного instance всё равно меняют фактический путь.
SageMaker теперь предлагает три стратегии. RANDOM остаётся default и равномерно распределяет взаимозаменяемые запросы; LEAST_OUTSTANDING_REQUESTS выбирает instance с наименьшим числом незавершённых вызовов; PREFIX_AWARE оптимизирована для LLM workload с повторяющимся началом и включённым prefix caching. Стратегия задаётся для production variant в endpoint configuration и может быть изменена обновлением конфигурации без повторного deployment модели.
Длинный контекст дал крупнейший выигрыш в benchmark AWS
AWS сравнила новую стратегию со случайной маршрутизацией на Llama 3.1 70B Instruct, семи ml.p5.48xlarge instances и vLLM с включённым prefix caching. Шестнадцать конфигураций охватывали single-model и inference-component endpoints, native Invoke API и OpenAI-compatible API; все тесты завершились со 100% success rate.
Для нагрузки с общим prefix длиной 8 000 tokens, работавшей один час, P50 time-to-first-token сократился на 71–77%, P90 — на 33–37%, throughput вырос на 15–16%, а KV cache hit rate поднялся примерно с 25% до более чем 80%. В получасовых ShareGPT-style диалогах с коротким переменным контекстом P50 улучшился на 13–16%, P90 — на 24–37%, throughput — на 1,7–2,0%, а hit rate вырос примерно с 30% до 80%.
Routing logic добавила 1,3–1,9 ms на запрос при TTFT модели от 63 до 280 ms. Нагрузка при этом оставалась распределённой: каждый из семи instances получил 13,3–15,4% запросов. Эти результаты показывают потенциал механизма в выбранной конфигурации AWS, но не являются универсальным SLA. Реальный эффект зависит от длины общей части, частоты повторения, размера fleet, очередей и поведения конкретного serving engine.
PrefixLength требует одинаковой сериализации
Настройка состоит из RoutingStrategy, PrefixLength и ConcurrencyThreshold. PrefixLength допускает значения 1024–65536: для native Invoke API это число bytes от начала request body, а для OpenAI-compatible API — число characters извлечённого message text. ConcurrencyThreshold принимает 1–1024 и определяет момент overflow на менее загруженный instance.
При native API даже whitespace, порядок JSON keys и форматирование влияют на routing key. AWS рекомендует сериализовать одинаковые prompts единообразно: иначе логически тот же контекст может попасть на разные machines. Слишком короткий PrefixLength собирает много traffic на одном instance и чаще включает overflow, слишком длинный захватывает изменчивые параметры и дробит группу, которая могла бы использовать один cache.
Для multi-tenant isolation можно добавить X-Amzn-SageMaker-Prefix-Aware-Id в native API или prompt_cache_key в OpenAI-compatible API. Идентификатор объединяется с prefix, поэтому tenants с одинаковыми инструкциями маршрутизируются раздельно. Механизм также работает с inference components и dynamic LoRA adapters, выбирая instance внутри sticky set уже загруженного adapter.
Включить routing недостаточно — cache должен работать в container
Prefix-aware routing действует полностью на уровне endpoint и не требует изменения model container или способа вызова InvokeEndpoint. Но serving framework обязан сохранять и повторно использовать KV cache; без включённого prefix caching новая стратегия лишь группирует похожие запросы, не устраняя повторное вычисление. AWS также указывает, что endpoint должен иметь минимум два instances, иначе выбирать маршрут не из чего.
Подход особенно подходит для RAG по одному документу, длинных multi-turn conversations, assistants с объёмными постоянными инструкциями и code completion, где содержимое текущего файла повторяется между запросами. Для проверки production-эффекта нужно одновременно наблюдать P50/P90 TTFT, cache hit rate, overflow, баланс нагрузки и изменения после scaling. Одна низкая медиана может скрыть ухудшение хвоста или перегрузку группы с самым популярным prefix.
Безопасный rollout начинается с отдельного production variant и реального распределения prefixes, а не с синтетического prompt, повторённого тысячу раз. Сначала нужно зафиксировать baseline RANDOM, затем включить PREFIX_AWARE с консервативным concurrency limit, проверить стабильность сериализации и масштабирование, после чего сравнить не только latency, но и throughput и стоимость. Новая маршрутизация сокращает повторную работу только там, где запросы действительно разделяют значительный и устойчивый контекст.