Технологии
AWS измерила преимущество G7 над G5 и G6 на двух 30B MoE-моделях
В тесте Qwen3-Coder-30B инстанс G7 дал 391,3 выходного токена в секунду и снизил P99 latency на 20,2% относительно G5. Для Nemotron-3-Nano-30B самый дешёвый вариант G7 оценён от $0,90 за миллион выходных токенов.
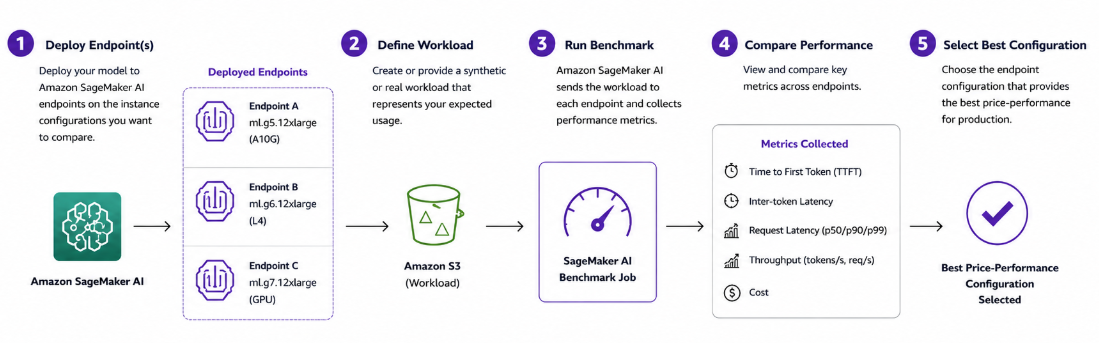
Одно поколение GPU проверили двумя разными способами
AWS опубликовала два benchmark-сценария для inference 30B Mixture-of-Experts моделей в Amazon SageMaker AI. Первый вручную сравнивает уже развёрнутые endpoints с Qwen3-Coder-30B-A3B-Instruct-FP8 на G5, G6 и G7. Второй просит Generative AI Inference Recommendations подобрать конфигурации G6, G6e и G7 для NVIDIA Nemotron-3-Nano-30B-A3B-NVFP4.
Разделение принципиально. Benchmarking workflow отвечает на вопрос, как ведут себя заранее выбранные endpoints под одинаковой нагрузкой. Recommendation workflow начинает с модели, candidate instances, профиля запросов и цели оптимизации, измеряет жизнеспособные варианты на реальных GPU и ранжирует их. В опубликованном опыте целью второго теста был throughput, а стоимость токена рассчитывалась дополнительно.
Оба результата благоприятны для G7 с NVIDIA Blackwell, но AWS прямо ограничивает область вывода конкретными моделями, quantization, token lengths, concurrency, serving frameworks и регионами. G7 в описанном сервисе доступна только в US East (Ohio) и US West (Oregon), поэтому цифры нельзя переносить на другую модель или deployment без повторного измерения.
Qwen3-Coder: 391,3 токена в секунду на двух GPU
Qwen3-Coder-30B-A3B-Instruct-FP8 запускали в DJL Large Model Inference 28.0. Каждый non-streaming тест состоял из 100 запросов с concurrency 4, средними 128 входными и 128 выходными токенами. G5.12xlarge и G6.12xlarge имели по четыре GPU и 96 ГБ совокупной памяти, тогда как G7.12xlarge — два RTX PRO 4500 Blackwell и 64 ГБ.
G7 достиг 391,3 output tok/s против 346,3 у G5 и 243,4 у G6. Средняя request latency составила 1 315,8 мс, тогда как G5 показал 1 475,2 мс, а G6 — 2 109,7 мс. На хвосте распределения P99 был 1 501,1 мс у G7, 1 881,1 мс у G5 и 3 315,7 мс у G6.
В относительных величинах AWS сообщает для G7 рост throughput на 13,0% против G5 и на 60,8% против G6. Средняя задержка снизилась соответственно на 10,8% и 37,6%, P99 — на 20,2% и 54,7%. То, что более новая конфигурация использовала вдвое меньше GPU, не означает автоматически меньшую цену endpoint: в этой части публикации сравниваются производительность и latency, а не полный счёт за обслуживание.
Streaming-тест отделил первый токен от темпа продолжения
Для интерактивного coding assistant AWS отдельно включила streaming на G7. Медианный Time To First Token составил 117,9 мс, средний — 118,9 мс, а P99 — 286,0 мс. Средний Inter-Token Latency был 8,9 мс; совокупный output throughput достиг 408,1 tok/s.
Эти показатели описывают разные стороны восприятия скорости. TTFT определяет, как долго пользователь ждёт появления первого фрагмента, а ITL — насколько равномерно продолжается генерация. Один высокий aggregate throughput не гарантирует быстрого первого ответа, особенно при batching и длинной очереди, поэтому для IDE и copilot-интерфейсов нужны обе метрики.
В benchmark использовалась короткая синтетическая нагрузка и всего четыре одновременных запроса. Production-профиль может включать значительно более длинный код, tools, speculative decoding, переменную очередь и строгие SLA. Поэтому 118 мс — измерение указанного endpoint, а не гарантированная задержка любого приложения на G7.
Nemotron показал разницу между максимумом throughput и минимумом цены
Во втором сценарии Nemotron-3-Nano-30B-A3B-NVFP4 работал через vLLM. AWS задала два профиля: chat с 512 входными и 256 выходными токенами и RAG с 3 500 входными и 200 выходными. Более длинный prompt снизил абсолютный throughput и повысил стоимость сгенерированного токена даже для той же модели.
На chat-профиле g7.48xlarge показал максимальный измеренный throughput — 2 397 output tok/s, а g7.2xlarge дал минимальную расчётную стоимость — $0,90 за миллион выходных токенов. Для RAG-профиля лидеры сохранились: 816 tok/s у g7.48xlarge и $2,29 за миллион выходных токенов у g7.2xlarge.
При сравнении самых экономичных вариантов протестированных семейств G7 оказался примерно в 1,4 раза дешевле G6e на токен в обоих профилях. Относительно G6 преимущество составило около 4,9 раза для chat и 5,6 раза для RAG. Это derived metric по цене инстанса и измеренному throughput, а не фактический совокупный TCO с хранением, сетью, простоями и инженерным сопровождением.
Blackwell получает структурное преимущество на NVFP4
AWS связывает часть результата с пропускной способностью памяти и нативной поддержкой низкой точности. Во время decode MoE-модель активирует только часть experts, поэтому перенос весов часто ограничивается memory bandwidth. Формат NVFP4 хранит вес примерно в четырёх битах, а аппаратную поддержку FP4 Tensor Cores среди сравниваемых поколений имеет только G7.
G5 и G6 могут запускать NVFP4 weights без такого ускорения, что заранее создаёт преимущество Blackwell именно во втором кейсе. Поэтому benchmark одновременно сравнивает инстансы и то, насколько конкретный формат модели совпадает с аппаратными возможностями поколения. Для BF16, FP8, dense architecture или иной реализации kernels относительный порядок и величина выигрыша могут измениться.
Практический вывод AWS осторожнее заголовка о победителе: инфраструктуру нужно выбирать по собственной нагрузке. Для уже развёрнутой модели полезно прогнать одинаковый endpoint benchmark с реальным распределением токенов и concurrency. Если конфигурация ещё не выбрана, recommendation job может исследовать кандидатов, но команда всё равно должна заранее определить цель — throughput, latency или стоимость. Иначе самый быстрый и самый выгодный по токену варианты окажутся разными ответами на неуточнённый вопрос.
Цифры воспроизводимы, но не универсальны
AWS приложила notebook и описала версии контейнера, модели, workload и формулу стоимости: цена инстанса в час умножается на миллион и делится на output tokens per second и 3 600. Такая прозрачность позволяет повторить процедуру и заменить synthetic profile собственными данными.
Но публикация не является независимым сравнением облачных провайдеров и не оценивает качество ответов после quantization. Она показывает serving performance двух моделей внутри SageMaker AI. Перед миграцией нужно дополнить тест проверкой качества на целевых задачах, доступности capacity, времени cold start, устойчивости tail latency и стоимости при неполной загрузке.
Подтверждённый результат уже достаточно конкретен: в заданном Qwen3-Coder тесте G7 была быстрее и стабильнее G5 и G6, а в Nemotron-рекомендациях разные размеры G7 заняли первое место по throughput и цене токена. Всё остальное — от экономии production-сервиса до выбора поколения для другой модели — требует собственного измерения тем же принципом.