Технологии
«Знание не привязано к архитектуре»: Amazon Science переносит веса обученного Transformer в гибридные SSM-модели за 0,5% бюджета претрейна
Amazon Science представила priming — способ строить гибридные архитектуры не с нуля, а из весов уже обученного Transformer: качество восстанавливается менее чем за 0,5% его токенного бюджета претрейна, а гибрид на 32 млрд параметров отдаёт до 2,06 раза больше токенов в секунду на контексте 128 000 токенов. Вместе с разбором выложены модельный зоопарк на 8 и 32 млрд параметров, код обучения, оптимизированные ядра Triton и плагин для vLLM — всё под лицензией Apache 2.0.
Зачем вообще отказываться от части attention
Ключевой аргумент статьи начинается с того, что агентные системы растут: сессии длиннее, цепочки рассуждений глубже, автономности больше, — а архитектура Transformer под ними продолжает платить «налог на память», который тем выше, чем больше токенов проходит через модель. Attention даёт то, что авторы называют эйдетической памятью: дословное воспроизведение любого прошлого токена, и именно на этом свойстве держатся обучение по контексту, работа с длинными документами и генерация с дополнением из поиска. Но цена этой возможности растёт вместе с числом входных токенов.
Дальше авторы разделяют слои attention по назначению: одни действительно ведут дальний поиск по десяткам тысяч токенов, другие работают локально — отслеживают текущую клаузу, копируют соседние токены и подобное. Локальным слоям растущий кэш не нужен: им достаточно компактной сводки прошлого фиксированного размера, которую в статье называют затухающей памятью. Гибридные модели и соединяют оба режима: слои attention с эйдетической памятью и растущим кэшем остаются там, где нужен глобальный доступ, остальные заменяются слоями пространства состояний с фиксированным состоянием. Результат — меньший след в памяти при сохранении дословного доступа там, где он важен.
Transformer как частный случай пространства состояний
Главная идея priming держится на структурном наблюдении: Transformer сам является частным случаем реализации пространства состояний. Выход и слоя attention, и слоя SSM можно записать как результат умножения последовательности значений на «смешивающую» матрицу, которая определяет вклад каждого прошлого токена в каждый текущий. Attention вычисляет эту матрицу перемножением матриц запросов и ключей, а SSM строит её рекуррентно через состояние.
Из этого следует практический вывод: если SSM с состоянием фиксированной размерности способен построить смешивающую матрицу, достаточно близкую к матрице слоя attention, то проекции query, key и value исходного Transformer можно переиспользовать как входные проекции SSM, и обучать придётся только специфичные для SSM параметры. Авторы прямо формулируют: «Знание не привязано к архитектуре» — накопленное в весах Transformer знание можно перенести в другую схему вычислений, если она воспроизводит то же смешивание.
Три шага и дешёвый прокси для выбора слоёв
Проверка, какие слои поддаются такой замене, не требует обучения: авторы используют дешёвый эмпирический прокси — подменяют слой скользящим окном, которое сохраняет лишь долю контекста, и измеряют деградацию. Слои, которые такую подмену терпят, оказываются естественными кандидатами на конвертацию в SSM: их смешивающие матрицы не обязаны улавливать дальние связи, поэтому состояние SSM способно достоверно представить их работу. Авторы связывают этот приём с формальной величиной из теории динамических систем — рангом Ганкеля смешивающей матрицы слоя, который измеряет, сколько информации должно пройти через состояние.
Сам priming идёт в три стадии. Сначала выбираются слои, которые можно достоверно сжать в состояние фиксированного размера, остальные остаются attention. Затем выполняется перенос весов и выравнивание: слои SSM инициализируются из соответствующих весов attention, после чего проходит короткая дистилляция, при которой каждый SSM подстраивается под поведение заменяемого слоя. На третьей стадии вся гибридная модель дообучается сквозным образом на предсказании следующего токена, чтобы все слои согласовались между собой. Весь конвейер расходует менее 0,5% токенного бюджета претрейна исходной модели и работает с разными семействами Transformer (Qwen, Llama, Mistral), разными классами моделей (плотные и Mixture-of-Experts) и разными масштабами — от 8 до 32 млрд параметров и выше.
GKA, GDN и Mamba-2: иерархия, предсказанная теорией
Как только все варианты стартуют из одной сильной инициализации и требуют минимального дообучения вместо полного претрейна, пространство проектирования становится доступным для контролируемых сравнений — по типу слоя, доле гибридности и размещению слоёв. Первый вопрос, который авторы смогли задать при одинаковых данных, бюджете и соотношении эйдетических и затухающих слоёв: какой именно тип SSM лучше работает в гибриде.
Сравнивались три семейства. Mamba-2 применяет единое скалярное затухание ко всему состоянию на каждом шаге: новый токен записывается, а все предыдущие записи ослабляются с одинаковой скоростью — просто и эффективно, но без разбора. Gated DeltaNet (GDN) добавляет к равномерному затуханию адресные правки: перед записью нового значения он может избирательно стереть значение, связанное с конкретным ключом (правило дельты), и потому выразительнее Mamba-2. Gated KalmaNet (GKA) идёт дальше: направление стирания зависит не только от текущего ключа, но и от статистики всех прошлых ключей — правка учитывает накопленную структуру всего, что модель видела.
Теоретическая иерархия выразительности GKA > GDN > Mamba-2 предсказывает эмпирическую: GKA в целом обходит GDN, а тот всегда обходит Mamba-2. Разрыв расширяется на длинноконтекстном рассуждении, где качество сжатия важнее всего, и сужается на коротких задачах. На масштабе 32 млрд параметров гибрид с GKA оказывается в пределах 1% от исходного Transformer, обученного на тех же данных, при вдвое меньшем KV-кэше на инференсе. В абстракте статьи те же числа сформулированы так: гибрид GKA на 32B улучшает исходную Qwen3-32B в среднем на 3,8 пункта на рассуждательных бенчмарках, оставаясь в пределах 1% от Transformer, дообученного на тех же данных, и даёт до 2,3 раза больший throughput декодирования.
Почему сжатая сводка побеждает окно
Контринтуитивная часть результата касается прямого сравнения гибридов на SSM с гибридами на скользящем окне attention, которые хранят фиксированное окно недавних токенов дословно, а не сжимают прошлое в состояние. Казалось бы, дословное воспроизведение — пусть и в пределах окна — должно быть точнее сжатия, ведь внутри окна не теряется ничего. Но каждый протестированный SSM-гибрид обошёл соответствующего SWA-гибрида на длинноконтекстных бенчмарках, причём даже когда окно получало в два-четыре раза больше памяти, чем состояние. Авторы формулируют вывод афористично: хорошая сводка всего оказывается лучше идеальной записи недавнего прошлого.
Ручка «скорость — точность» без переобучения
У GKA есть свойство, которого нет ни у Mamba-2, ни у GDN: переменные вычисления на этапе инференса. Mamba-2 и GDN тратят одинаковый бюджет на каждый входной токен независимо от его содержания, а GKA решает задачу регрессии итеративно, и число итераций можно менять при обслуживании без переобучения. На практике обслуживание GKA с 10 итерациями вместо обычных 30 стоит примерно 1% точности на AIME 2025 и даёт на 10% более быстрое декодирование. Одна обученная модель покрывает несколько точек на границе «скорость — точность», так что провайдер может предлагать разные уровни задержки, не поддерживая отдельные варианты модели. Авторы связывают это с уже обсуждавшимся у них ранее принципом: интеллект — это способность выделять усилие соразмерно сложности.
Ускорение по времени ответа, а не по токенам
Скорость на токен описывает не всю картину: модель дешевле на токен всё равно может оказаться медленнее от начала до конца, если рассуждает слабее и тратит больше токенов. Поэтому авторы мерили не только пропускную способность, но и то, как быстро гибрид достигает целевой точности по настенным часам на AIME 2025 — сложном математическом олимпиадном бенчмарке, сравнивая свою модель GKA-Primed-HQwen3-32B-Reasoner с исходной Qwen3-32B, обученной по тому же рецепту рассуждений. Длина цепочек рассуждений у моделей сопоставима — медиана около 14 000 токенов на полном наборе и 28 000 на самых сложных задачах, то есть ответы одинаковой глубины. При реалистичном уровне параллелизма, когда KV-кэш Transformer насыщает память GPU, гибрид достигает порогов точности в 1,2–1,4 раза быстрее на полном бенчмарке и до 1,6 раза быстрее на самых трудных задачах; причина — фиксированное состояние SSM-слоёв, которое примерно вдвое уменьшает память на последовательность и позволяет вести больше параллельных операций на том же оборудовании. Разрыв в пропускной способности растёт с длиной контекста: 1,50 раза на 16K токенов и 2,06 раза на 128K для модели на 32B (GKA с 10 итерациями), а у моделей на 8B выигрыш ещё больше — от 1,94 раза на 16K до 2,29 раза на 128K.
Выигрыш выходит за пределы обслуживания: в конвейерах дообучения с подкреплением пропускная способность определяет, как быстро политика порождает правильные траектории, и преимущество гибрида превращается в рост скорости генерации данных для RL-обучения на 20–100% при фиксированном бюджете GPU.
256K без дообучения: state composition
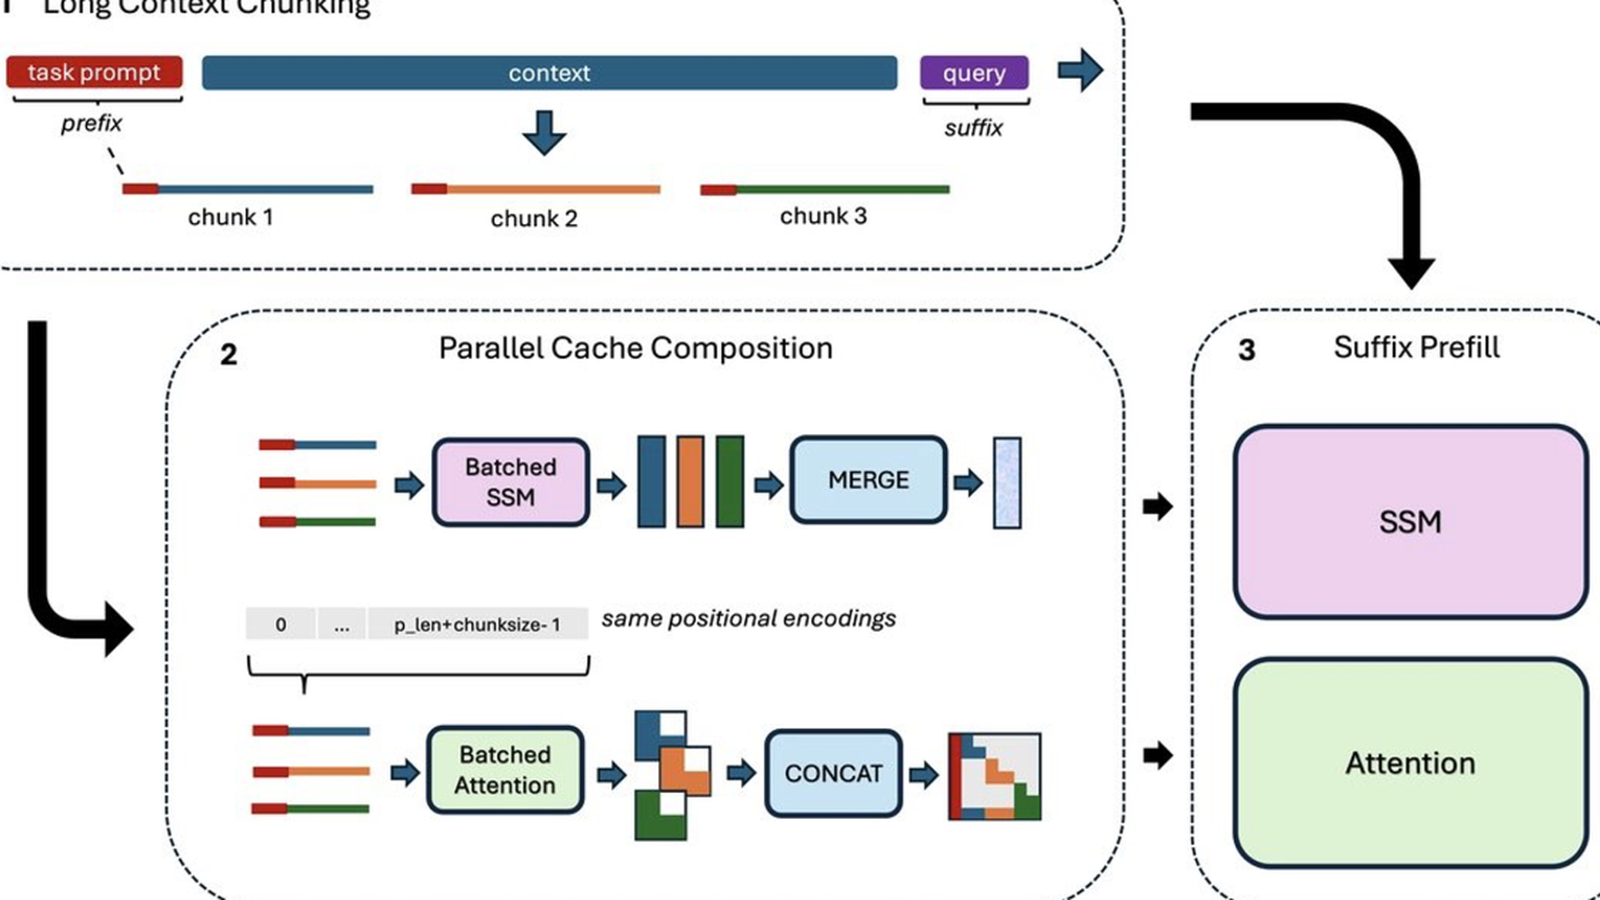
Гибриды на priming нативно поддерживают 128 000 токенов, но агентные сессии, кодовые базы и длинные юридические документы регулярно выходят за эту границу. Обычно расширение контекста требует ещё одного раунда продолжающего претрейна на подобранных данных; авторы задались вопросом, может ли сама гибридная архитектура обобщиться на более длинные контексты без дополнительного обучения. Существующие методы без обучения делятся на два класса: для чистых Transformer (масштабирование позиционных эмбеддингов вроде YaRN) и для чистых SSM — например, их PICASO, представленный годом ранее на ICLR; ни один из них не решает гибридный случай, где KV-кэши и рекуррентные состояния нужно согласовывать совместно.
Процедура, названная state composition, состоит из трёх шагов: длинный вход делится на части короче нативного контекста, к каждой части добавляется общий префикс, части обрабатываются независимо и параллельно, затем KV-кэши конкатенируются, а состояния SSM объединяются взвешенным усреднением — тем самым приёмом, который авторы предложили в статье о PICASO. Это позволило расширить контекст гибридов с 128K до 256K токенов, сохранив существенную точность и на поиске (RULER NIAH), и на рассуждении (BABILong) — на длинах, на которых модель никогда не обучалась. В экспериментах state composition сохраняет иерархию выразительности SSM: GKA > GDN > Mamba-2.
Что выложено и чего это не отменяет
Все артефакты статьи выложены под лицензией Apache 2.0 в Hybrid Model Factory на GitHub и в модельном зоопарке на Hugging Face. Это коллекция primed-гибридов для длинноконтекстного рассуждения и следования инструкциям на 8 и 32 млрд параметров, код обучения priming, алгоритмы point-to-point sequence parallelism для слоёв SSM (до 2,3 раза быстрее альтернатив на all-to-all при обучении на нескольких узлах), универсальный sequence parallelism для прототипирования новых слоёв на длинных последовательностях без кастомных ядер и распараллеленной экспертизы, оптимизированные ядра Triton для декодирования и обучения GKA, а также плагин для vLLM, поддерживающий primed-гибридные архитектуры с непрерывным батчингом, разбитым префиллом и тензорным параллелизмом.
Границы результата авторы очерчивают сами. Сравнение типов слоёв проводится при фиксированных данных, бюджете и доле гибридности, то есть выводы о превосходстве GKA относятся к этим условиям, а не к произвольным конфигурациям. Замеры ускорения привязаны к конкретным длинам контекста, уровню параллелизма и числу итераций решателя, а выигрыш по времени ответа измерен на AIME 2025 против исходной Qwen3-32B по тому же рецепту рассуждений. Расширение до 256K — это метод инференса без обучения, и качество на этих длинах измеряется на двух конкретных наборах задач — поиске и рассуждении. Наконец, сама работа выложена на arXiv как 2605.08301, а разбор результатов и объявление артефактов даны в блоге Amazon Science от 12 октября 2026 года.