Технологии
Спектр кастомизации GenAI на AWS: восемь шагов от промпта до своей модели
AWS предлагает не выбирать сразу между промптом, RAG, дообучением и обучением с нуля, а двигаться по лестнице из восьми шагов: сначала использовать готовую модель как есть, затем добавлять данные и инструменты вокруг неё и только потом менять веса. Правило авторов разбора — начинать с самого простого подхода и углубляться лишь тогда, когда предыдущий шаг перестаёт проходить по точности, задержке или доменным требованиям.
Почему выбор подхода дороже доступа к моделям
Через Amazon Bedrock доступны фундаментальные модели Anthropic, Meta, Mistral и Amazon, а вместе с ними — инфраструктура для чат-ботов, код-ассистентов, обработчиков документов и автономных агентов.
Сами модели поэтому перестали быть узким местом: наличие Claude, Amazon Nova или Llama не отвечает на вопрос, писать ли более удачный промпт, подключать документы через Retrieval Augmented Generation (RAG), дообучать модель или обучать что-то с нуля.
Количество вариантов создаёт паралич решений, а ошибка обходится дорого: одни команды сразу уходят в fine-tuning там, где хватило бы хорошо структурированного промпта, другие неделями остаются на промпт-инжиниринге при явной потребности в доменных данных.
Обе ошибки стоят денег на вычислениях, времени на задержке запуска и доверия, когда результат модели не совпадает с ожиданиями заказчиков.
Поэтому разбор предлагает восьмишаговый фреймворк принятия решений — спектр кастомизации генеративного ИИ на AWS.
Что такое спектр кастомизации
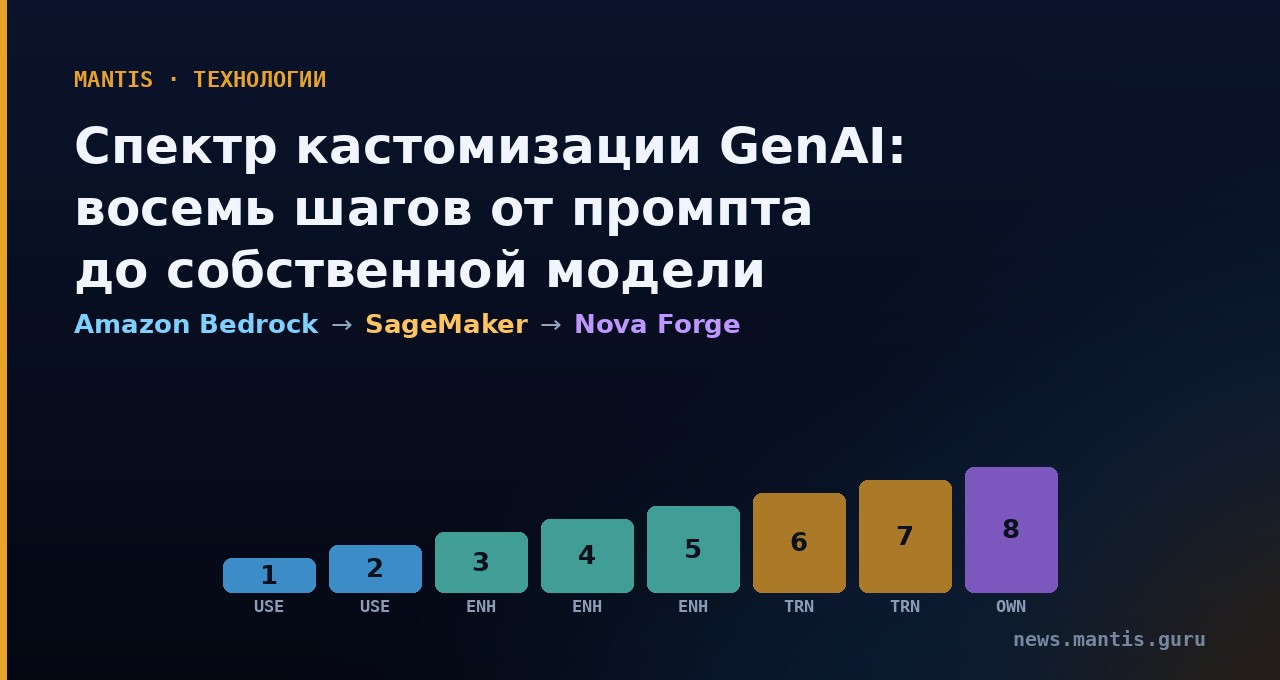
Спектр описан как лестница: каждый следующий шаг увеличивает усилия, стоимость и требования к данным, но добавляет контроль и доменную специфичность.
Первая категория — USE: модель не трогают, меняется только способ обращения к ней, и это шаги с первого по второй.
Вторая категория — ENHANCE, использование модели как инструмента: вокруг неё добавляются данные, инструменты и оптимизации, а веса остаются замороженными; это шаги с третьего по пятый.
Именно такой приём в индустрии называют «harnessing» модели — обвязка из внешних инструментов, источников данных и оптимизаций при неизменных весах.
Карта сервисов распределена по ступеням: Amazon Bedrock покрывает шаги с первого по седьмой, Amazon SageMaker — с шестого по восьмой, а Amazon Nova Forge задействован на восьмом шаге.
Шаги 1–2: готовая модель и работа с промптом
Первый шаг — использовать существующую модель как есть, без каких-либо изменений.
Второй — улучшать инструкции: системные промпты, few-shot примеры и рассуждения по цепочке chain-of-thought, по-прежнему без изменения весов.
Когда промптов становится сотни в продуктовых сценариях, добавляется задача оценки промптов: их качество измеряют метриками точности и устойчивости.
Оптимизация промптов автоматически переписывает их так, чтобы они лучше работали на выбранной модели, и убирает ручной перебор вариантов из процесса.
Шаги 3–5: данные и оптимизации вокруг модели
Retrieval-augmented generation (RAG) на третьем шаге нужен, когда модели требуется доступ к приватным, часто обновляемым или доменным данным — внутренним документам, политикам, каталогам товаров.
Переход выше по лестнице оправдан, если задержка поиска превышает требования, контекстное окно переполняется или модель всё равно не может корректно рассуждать над найденным содержимым.
Дистилляция на пятом шаге обучает меньшие модели повторять поведение больших.
Разбор приводит пример Goodnotes: компания перешла с самостоятельно размещённой модели на Amazon Elastic Kubernetes Service (Amazon EKS) на Anthropic Claude в Amazon Bedrock, чтобы улучшить масштабируемость и экономическую эффективность функции «Ask Goodnotes».
Шаги 6–7: когда меняют веса модели
Fine-tuning обновляет веса модели на размеченных парах вход-выход, чтобы устойчиво изменить её поведение, стиль или доменную точность; доступны parameter-efficient fine-tuning (PEFT/LoRA) для небольших наборов данных и полное дообучение для комплексных изменений.
Требования к данным различаются по методу: PEFT — несколько тысяч размеченных примеров, полное дообучение — десятки тысяч, а Direct Preference Optimization (DPO) работает с парами предпочтительных и непредпочтительных ответов.
Обычное дообучение (SFT) требует эталонных размеченных пар для каждого желаемого поведения, тогда как reinforcement fine-tuning (RFT) позволяет передать промпты и функцию оценки: Amazon Bedrock ведёт этот процесс как полностью управляемую услугу, принимая до 20 000 промптов на задание и выполняя цикл обучения с подкреплением целиком.
RFT стал доступен для моделей Amazon Nova в декабре 2025 года, а в феврале 2026 года распространился на модели с открытыми весами, включая OpenAI GPT OSS 20B и Qwen 3 32B.
Continued pre-training на седьмом шаге работает с массивным неразмеченным корпусом: для mid-training требуется более 1 млрд токенов неразмеченного доменного контента, для полного CPT — более 1 трлн токенов.
Сигналом к этому шагу служит нехватка понимания, а не поведения: если модель не понимает доменный язык и структурные паттерны даже после дообучения на представительных примерах, разрыв лежит именно в понимании, а CPT на сыром корпусе даёт базовое понимание, которого fine-tuning добавить не может.
Шаг 8: полностью своя модель на Amazon Nova Forge
Восьмой шаг нужен, когда готовые модели и все предыдущие варианты кастомизации не дают требуемой точности, а у команды есть экспертиза в машинном обучении и крупные проприетарные наборы данных.
Обычно это путь для случая, когда модель планируется монетизировать как основной продукт или услугу.
Amazon Nova Forge поддерживает обучение с подкреплением с собственными функциями награды: среда заказчика подключается напрямую как сигнал награды — химические симуляции, оценивающие молекулярные дизайны, физические движки робототехники, штрафующие столкновения, или валидаторы кода, проверяющие успешную компиляцию.
Nova Forge — полностью управляемая услуга с проработанным маршрутом, тогда как Amazon SageMaker даёт сырую инфраструктуру: GPU-кластеры, библиотеки распределённого обучения и произвольные контейнеры с полным контролем над параметрами обучения.
На практике разница между этими путями проявляется в сроках и размере команды.
В заключении отдельно названы отрасли со специальными требованиями: когда нужна полностью своя фронтирная модель, например в фармацевтике или обороне, Nova Forge позволяет собрать её из промежуточных чекпойнтов со своим смешиванием данных.
Правило движения по лестнице и типовые ошибки
Правило сформулировано прямо: начинать с первого шага и подниматься выше только тогда, когда текущий шаг не проходит по точности, задержке или доменным требованиям, а большинство нагрузок не выходит за пределы третьего шага.
Первая названная ошибка — держать в продакшене большую модель-учителя без дистилляции: если качество проверяли на большой модели во время прототипирования, перед масштабированием её следует дистиллировать в меньшую ученическую модель.
Вторая ошибка — выбирать continued pre-training потому, что данных много: объём сам по себе не оправдывает CPT.
Как устроен разбор
Материал строится вокруг выбора подхода, а не модели: сначала определяется, какой шаг лестницы закрывает задачу, и уже под него подбираются сервисы — от Amazon Bedrock до Amazon SageMaker и Amazon Nova Forge.
Каждый шаг разобран по одной схеме: что он делает, когда его применять и какой сигнал говорит о необходимости перейти на ступень выше.
Авторы материала — Bhavya Sruthi Sode, технический менеджер по аккаунтам Amazon Web Services в области AI/ML, и Nitin Eusebius, главный архитектор решений и технический лидер по генеративному ИИ в AWS.