Технологии
AWS предложила искать корневую ошибку AI-агента по отдельным ходам
Agent Evaluation Metric раскладывает корректность на правдивость и полноту, оценивает ответы и вызовы инструментов по ходам и отделяет исходный сбой от ошибок, которые лишь унаследовали его последствия.
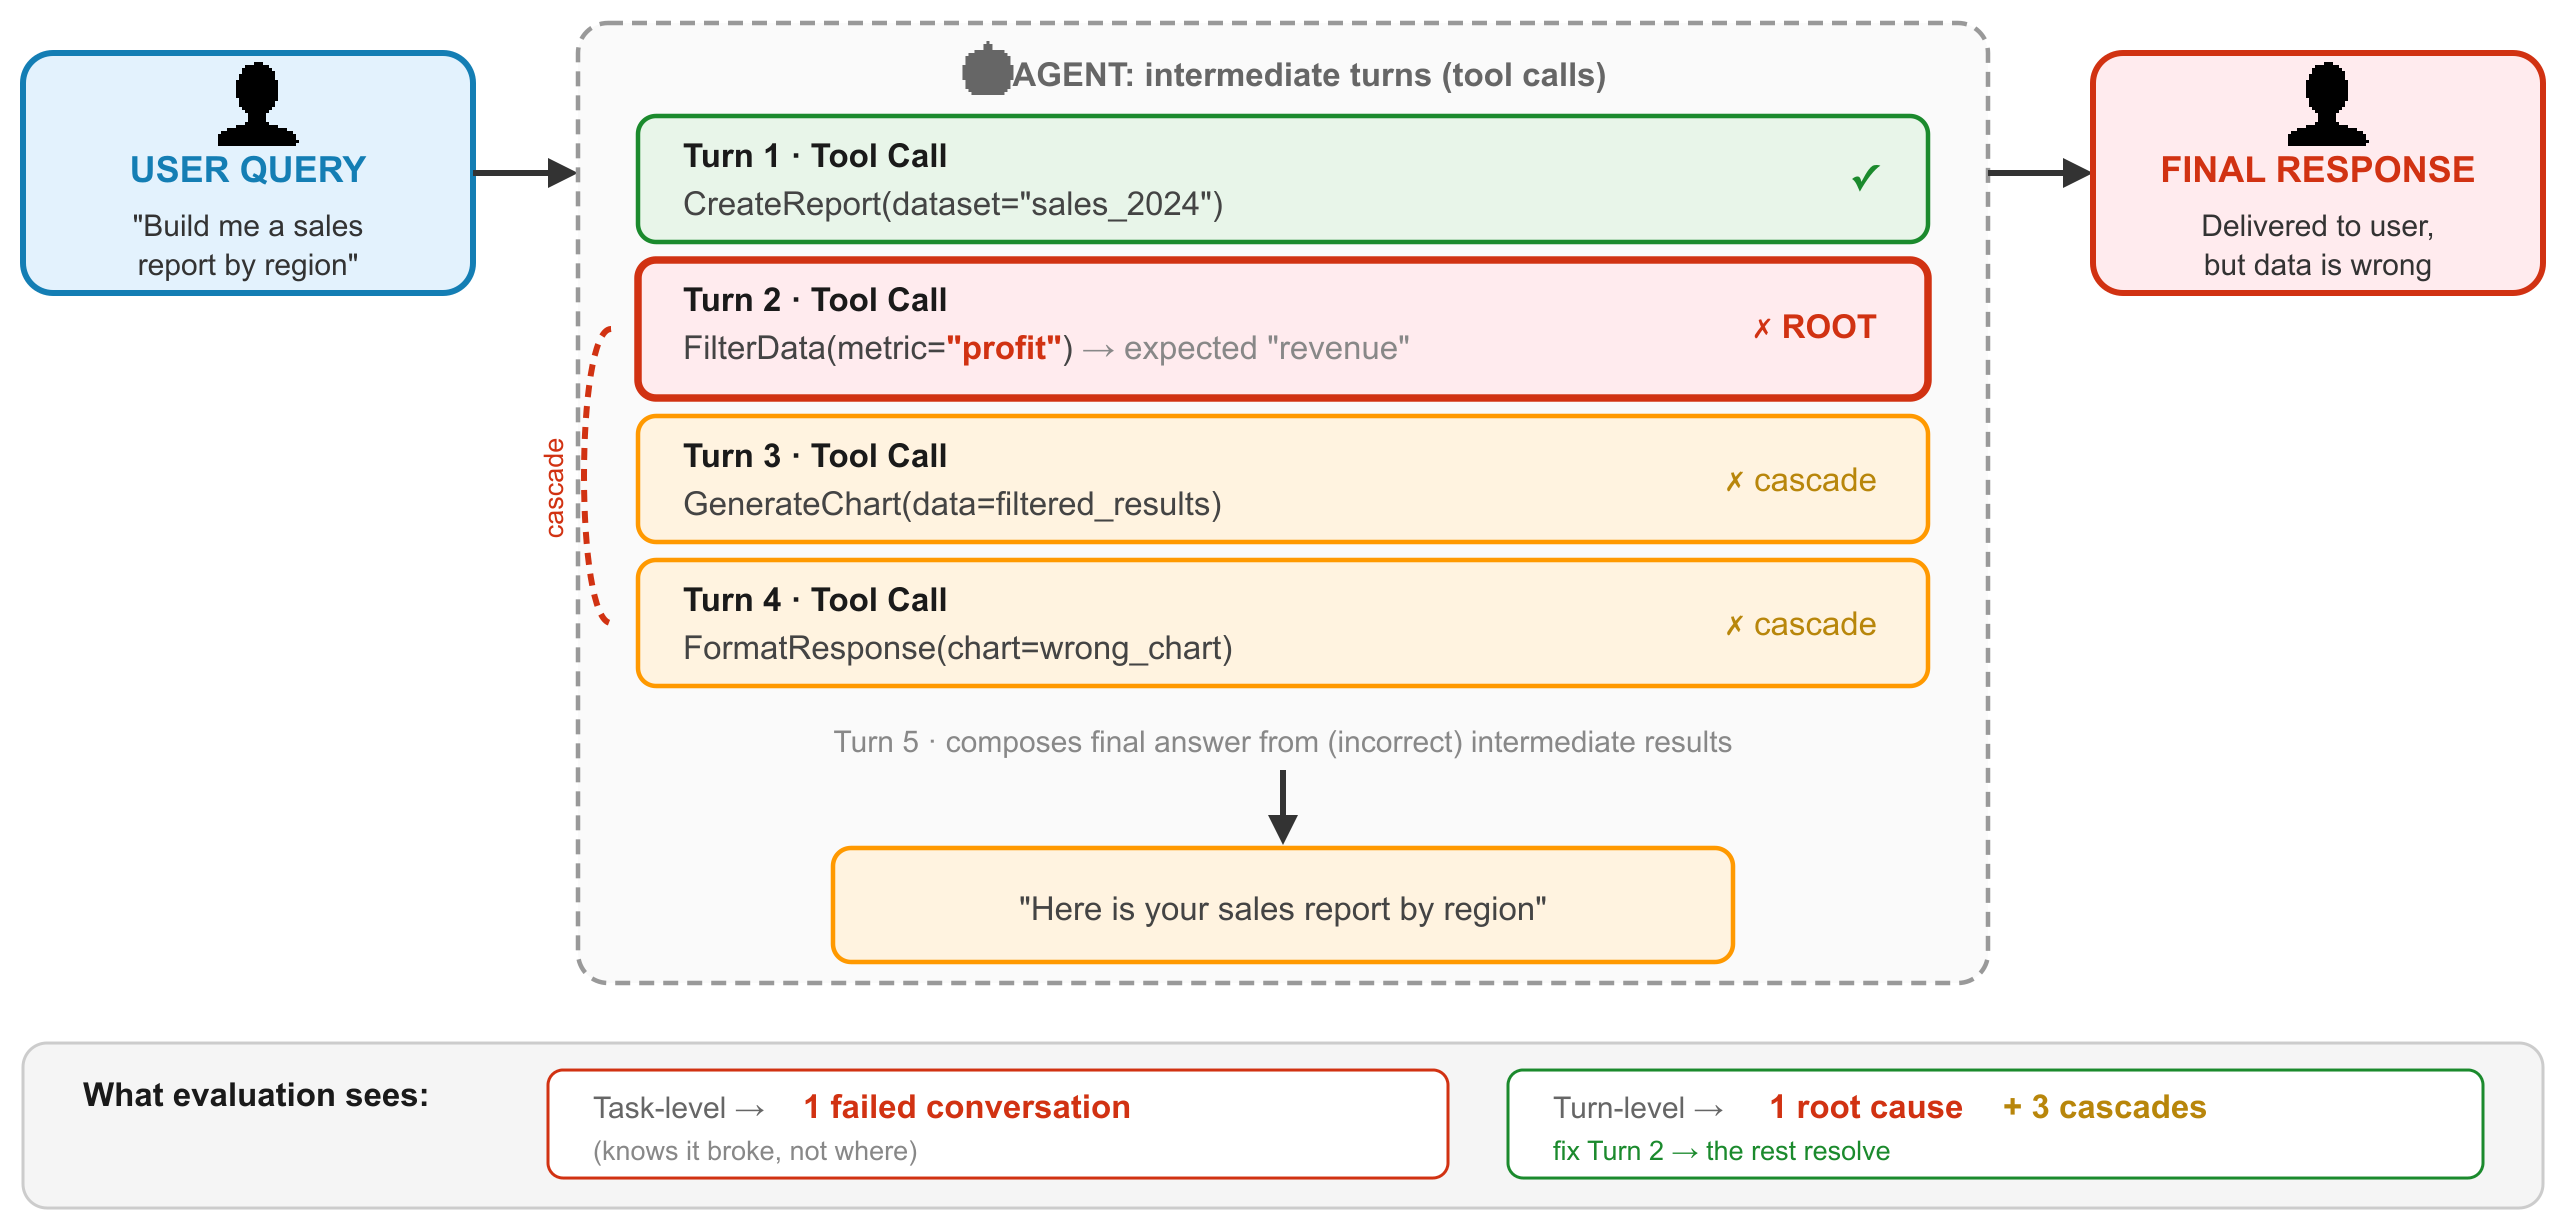
Один неверный параметр может испортить весь диалог
AWS представила Agent Evaluation Metric, или AEM, для оценки многоходовых AI-агентов. Метод нужен для ситуаций, где итоговая проверка видит только провал всей задачи, но не показывает момент возникновения проблемы. В примере компании агент на втором ходу выбирает правильное действие, однако передаёт profit вместо revenue; последующие ходы работают уже с неверным результатом и тоже оказываются ошибочными.
Обычная метрика успешности задачи в таком случае помечает весь диалог неудачным. AEM вместо этого оценивает каждый ход в контексте полной траектории и различает корневую ошибку и каскад. Для унаследованного сбоя предусмотрена отдельная причина prior_action_failed: она показывает, что текущий ход сам по себе не создал проблему, а использовал результат ранее провалившегося действия.
Это меняет порядок отладки. Вместо расследования четырёх похожих симптомов команда может начать с первого проблемного хода и проверить конкретное поле. AWS формулирует практическое правило прямо: сначала выполнить атрибуцию, затем расследовать. Исправление одной корневой причины способно устранить несколько последующих отказов, хотя это всё равно нужно подтвердить повторным прогоном.
Корректность разделена на правдивость и полноту
В первой версии AEM рассматривает корректность через две именованные составляющие. Truthfulness проверяет, согласуются ли значения параметров и утверждения в ответе с эталоном. Completeness проверяет, присутствуют ли все необходимые элементы: полный ответ для текстового хода и полный набор параметров для вызова инструмента. Структурная проверка отдельно определяет, выбраны ли правильные tool и action.
Для текстов и значений параметров AWS предлагает семантическое сравнение, а не только точное совпадение строк. Поэтому NYC и New York City могут считаться эквивалентными. Scorer может использовать embeddings или LLM-as-judge, после чего threshold превращает непрерывную оценку в бинарный результат хода. Значение 0.5 в примере названо нейтральной отправной точкой, а не универсально настроенным порогом.
Полнота аргументов проверяется структурно: отсутствующие ключи дают missing_parameters, неожиданные — extra_parameters. В taxonomy также входят tool_mismatch, action_mismatch, inconsistent_parameter_values, inconsistent_response и incomplete_response. Такой результат полезнее общего балла, потому что указывает тип хода, нарушенную составляющую и конкретную причину сбоя.
Итоговый балл остаётся настраиваемым
В базовом варианте AEM score — доля успешно пройденных ходов. Но функция композиции не зафиксирована навсегда: AWS допускает взвешенное среднее для более дорогих ошибок, gating rules, при которых критический сбой ограничивает весь результат, и отдельные пороги для разных sub-metrics. Декомпозиция остаётся общей, а правила агрегации можно приспособить к риску конкретного процесса.
Для оценки нужен golden dataset с ожидаемыми ответами и вызовами инструментов. Каждый ход содержит gold output и фактический predicted output. Эталон обычно размечают люди либо проверяют после первоначальной разметки более сильной моделью. Для действий, которые допустимо выполнять в разном порядке, предлагаются order-invariant tags, чтобы корректная альтернативная последовательность не считалась ошибкой.
В опубликованном демонстрационном результате пятиходовый диалог получил success_rate 0.2: первая корневая ошибка обнаружена на втором ходу, а три следующих сбоя отнесены к каскадным. Это иллюстрация формата результата, а не benchmark конкретной модели. Статья не публикует сравнительную таблицу систем и не доказывает, что один выбранный scorer одинаково надёжен во всех предметных областях.
Метрику можно встроить в существующий evaluation pipeline
Методология заявлена как framework-agnostic, а практический пример оформлен как custom evaluator для Strands Agents evaluation SDK. AEM дополняет goal-completion и LLM-as-judge оценки: те дают целостный сигнал по траектории, а новый evaluator добавляет разложенную по ходам корректность и атрибуцию причины.
В production AWS советует отслеживать общую корректность по версиям, качество в зависимости от длины action chain, распределение причин отказов и связь с накопленной latency. Для финансовых, compliance и других дорогих ошибок автоматическую оценку предлагается сопоставлять с человеческими или gold labels, а при высоком риске включать reviewer в контур.
AEM пока раскрыта только для correctness. Следующая публикация серии должна применить тот же подход к safety, а последующие — к multilingual и multimodal evaluation. Поэтому нынешний материал разумно воспринимать как шаблон измерения и диагностики, а не готовый стандарт качества: команде всё равно предстоит собрать эталоны, настроить thresholds и проверить, насколько автоматический scorer совпадает с экспертной оценкой в её домене.