Технологии
Hugging Face научила AsyncGRPO обучать LoRA-адаптер и ускорила прогон в 3,9 раза
В TRL v1.14 асинхронный тренер синхронизирует с vLLM только LoRA-адаптер, а не веса целиком. Тренер и реплики vLLM живут в разных заданиях HF Jobs, адаптер ходит через Storage Bucket, а небольшой прокси раздаёт rollout'ы по префиксному кешу. Пять прогонов сократили 500 шагов с 3 ч 27 мин до 53 мин.
Что произошло
В TRL появилась поддержка LoRA для AsyncGRPOTrainer: асинхронный тренер теперь обучает адаптер вместо полной модели и синхронизирует с vLLM только этот адаптер. Изменение пришло с PR #7017 и вошло в TRL v1.14.
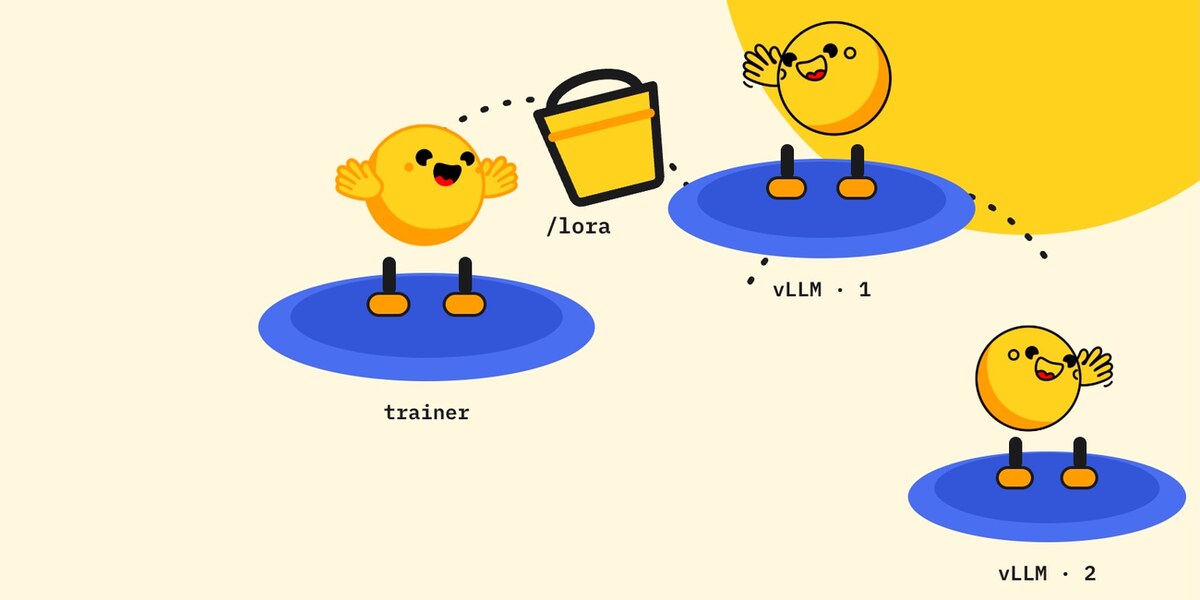
Инженерный разбор Hugging Face описывает проект, построенный поверх этой возможности, где обучение и вывод больше не делят одну машину. Тренер и реплики vLLM работают как отдельные задания Hugging Face Jobs на разных машинах.
Главный результат авторы выносят в самое начало: один и тот же рецепт проходит 500 шагов за 53 минуты вместо 3 часов 27 минут на первом прогоне.
Почему LoRA меняет схему синхронизации
LoRA хорошо подходит для RL: в блоге Thinking Machines «LoRA Without Regret» показано, что LoRA не уступает полному дообучению в policy-gradient RL даже при ранге 1. Причина в том, что функция преимущества даёт около O(1) бит информации за эпизод, и адаптеру ранга 1 хватает ёмкости, чтобы это усвоить.
У этого есть системное следствие. Адаптер ранга 1 для модели на 1,5 млрд параметров занимает несколько мегабайт, тогда как полная модель — около 3 ГБ. Вместо того чтобы отправлять на инференс-воркеры полную политику после каждого обновления, можно отправлять только адаптер.
vLLM умеет держать загруженными несколько адаптеров сразу: старые rollout'ы доигрывают на той политике, с которой начались, а новые берут последнюю.
Три задания и один бакет
Ограничение HF Jobs в том, что это один контейнер на одной виртуальной машине, и одно задание не может поднять несколько узлов — максимум 8 GPU H200 на узел. Значит, тренер и парк серверов vLLM в одно задание не помещаются.
Между заданиями нет ни общей локальной файловой системы, ни общей сети: они не могут связаться друг с другом напрямую, поэтому NCCL-группу из них не собрать. При синхронизации полных весов каждый апдейт тянул бы гигабайты между машинами.
Выход нашёлся в Storage Buckets: бакет монтируется как FUSE-файловая система через hf-mount по одному и тому же абсолютному пути в каждом задании и работает как общий диск без сетевого канала между заданиями.
Схема получилась компактной: задание-тренер с AsyncGRPOTrainer и LoRA, две реплики vLLM, каждая со своей базовой моделью и последним опубликованным адаптером, один бакет, смонтированный во всех трёх, и прокси-сервер.
Механика синхронизации такая: тренер не отправляет тензоры в vLLM. Раз в несколько шагов оптимизатора он сохраняет адаптер в <output_dir>/.vllm_lora/trl-policy-v{N}, публикует каталог атомарным переименованием и передаёт путь в эндпоинт /v1/load_lora_adapter; vLLM читает файлы с диска, после чего rollout-воркер запрашивает model="trl-policy-v{N}".
Число версий адаптера считается из max_staleness. Сэмпл, сгенерированный под trl-policy-v3, ещё может уйти в обучение, когда тренер уже на v7, поэтому vLLM обязан в любой момент обслуживать текущую политику и четыре предыдущих. Отсюда max_staleness + 1 зарегистрированных адаптеров, а с учётом слота на подмену — флаг --max-loras 6. С пятью vLLM молча вытеснял бы политику, у которой ещё есть rollout'ы в полёте.
Имена версий, а не одно постоянное имя, выбраны намеренно: vLLM ключует префиксный кеш по имени адаптера, и при одном имени префикс мог бы быть посчитан одной версией политики, а декодирование достаться следующей.
Прокси, который экономит префикс
Прокси на 127.0.0.1:8000 нужен по двум причинам. Открытые порты заданий HF Jobs требуют заголовка Authorization в каждом запросе, и именно прокси его добавляет, чтобы TRL ничего не знал про токен. Кроме того, прокси раскидывает rollout'ы по репликам и рассылает изменяющие состояние запросы — загрузку адаптеров, pause и resume — сразу во все реплики, чтобы имя политики означало одно и то же везде.
Маршрутизация опирается на префиксный кеш. vLLM хранит его блоками по 16 токенов, а GRPO отправляет G запросов с одним и тем же промптом — в этом прогоне G=8. Если все восемь попадут на одну реплику, prefill посчитается один раз, а остальные семь запросов переиспользуют результат; при round-robin половина ушла бы на реплику без кеша и заново считала бы prefill.
Роутер отслеживает, какая реплика видела какой хеш блока. Хеши цепочечные: хеш третьего блока представляет блоки с первого по третий, как и причинно-следственное внимание. Цепочка засевается именем адаптера, потому что префикс, закешированный для политики v3, для политики v4 бесполезен.
За прогон через прокси прошло 64 728 rollout'ов, и счётчики в конце показали 84,5 % попаданий в аффинность, 14,2 % запросов без совпадения при теоретическом минимуме 12,5 % и 1,3 % вытеснений.
Погоня за узким местом
Для проверки авторы взяли датасет sail/Sanity-Test-R1D-1.5B из работы «Defeating the Training-Inference Mismatch via FP16» (Qi и соавторы, 2025). В нём 40 ответов на каждую задачу MATH, сгенерированных моделью DeepSeek-R1-Distill-Qwen-1.5B, из которых оставлены задачи с долей успеха от 20 % до 80 % — всего 1 460 вопросов.
Гиперпараметры тоже взяты из статьи: Qwen2.5-Math-1.5B, LoRA ранга 1 с alpha 2, скорость обучения 4e-5, 8 сэмплов на промпт, 128 комплишенов на шаг, до 3 000 генерируемых токенов и контекст 4 096 токенов. Тренер занимает задание h200x2, каждая из двух реплик vLLM — по одному h200, все три вместе стоят около $20 в час.
Первый прогон показал, что узкое место — тренер, а не генерация: медианный шаг 22,9 с при forward и backward 21,9 с, MFU 3,9 %, очередь rollout'ов держится на 476 из 512. За 500 шагов награда выросла с 0,145 до 0,438, а метрика ratio оставалась около 1,000 на всех 126 синхронизациях: политика в vLLM всегда совпадала с той, которой тренер оценивал rollout. Средняя устарелость составила 1,5 версии при максимуме 4.
Второй прогон менял не размер батча, а раскладку данных на GPU: батчирование по token_budget с token_budget=16384 и gradient_accumulation_steps=6 упаковало сэмплы в строки без паддинга. Сэмплов на строку стало 12,7 вместо 1, микро-батчей 6 вместо 64, шаг упал с 23 до 5,9 с, MFU выросла до 19 %, а генерация — с 4,6 тыс. до 25 тыс. токенов в секунду при неизменной стороне vLLM.
Третий прогон убрал gradient_checkpointing. По умолчанию AsyncGRPOConfig держит его включённым, и каждый микро-батч пересчитывает forward во время backward — именно поэтому строка на 16 тыс. токенов занимала всего 25 ГБ на 141-гигабайтной H200. С gradient_checkpointing=False forward и backward упали с 5,6 до 4,6 с, MFU достигла 23 %, а очередь опустела: узкое место переехало на генерацию.
Четвёртый прогон добавил третью реплику и почти ничего не дал, потому что rollout/inflight показывал 128 в каждом прогоне: max_inflight_tasks ограничивает конкурентность всего rollout-воркера, а не отдельной реплики, и лимит стоял на стороне клиента, а не vLLM.
Пятый прогон поднял max_inflight_tasks до 384 и queue_maxsize до 768. 500 шагов прошли за 53 минуты, медианный шаг стал 4,8 с, MFU — 23,5 %, обучено 84 078 сэмплов вместо 64 000, награда выросла с 0,145 до 0,416, а средняя устарелость — до 2,0 версий, всё ещё ниже максимума 4.
Что это меняет и чего не доказывает
Практический вывод авторов в том, что асинхронный RL — это конвейер между обучением и генерацией, и ускорение одной стороны ничего не даёт, пока вторая не успевает. Метрики AsyncGRPOTrainer показывают, где именно стоит узкое место: полная очередь при нулевом ожидании rollout'ов означает медленный тренер, пустая очередь с растущим ожиданием — медленную генерацию.
Итог пяти прогонов: тот же рецепт и та же кривая награды, но в 3,9 раза быстрее и на 31 % больше обученных сэмплов. Разницу дали упаковка строк, отключение checkpointing и поднятый лимит запросов в полёте — в каждом случае дашборд показывал проблему в первые десять минут.
Ограничения здесь тоже стоит назвать прямо. Публикация описывает один рецепт — модель на 1,5 млрд параметров и один валидационный датасет; прогоны со второго по четвёртый останавливали рано, как только дашборд отвечал на поставленный вопрос, поэтому их итоговые метрики неполные. Как эта схема поведёт себя на моделях большего размера и на других задачах, из материала не следует.
Код воспроизведения авторы выложили в репозитории github.com/AmineDiro/hfjobs-lora-buckets: смоук-тест на 20 шагов занимает около 15 минут и сам выключает серверы после завершения.