Технологии
ARCHsloth исправила две строки AutoRound и снизила расхождение Q4_K_M с bf16 на 54 %
Файлы ARCHsloth и unsloth для Qwen3-4B совпадают по размеру и карте тензоров до байта, а отличаются только тем, до какого целого округлён вес. Разбор команды показывает, что в сборке была указана не та схема AutoRound, поиск округления по знаковым градиентам не был включён, а калибровочный корпус выбирает направление округления и стоит на корейском 29,6 %.
Что произошло
Команда, публикующая GGUF-квантования под именем ARCHsloth, разобрала в блоге Hugging Face разницу между своими файлами и файлами того же имени от unsloth; запись вышла 14 сентября 2026 года.
Файлы неразличимы по структуре: оба занимают 2 497 280 800 байт, содержат по 216 тензоров Q4_K, 37 — Q6_K и 145 — F32, а карта типов совпадает полностью. Отличается только целое число, до которого округлён каждый вес.
Мерой сравнения выбрана KL-дивергенция от исходной bf16-модели: она показывает, насколько распределение выходов квантованной модели ушло от той, из которой она сделана, и меньше здесь значит лучше.
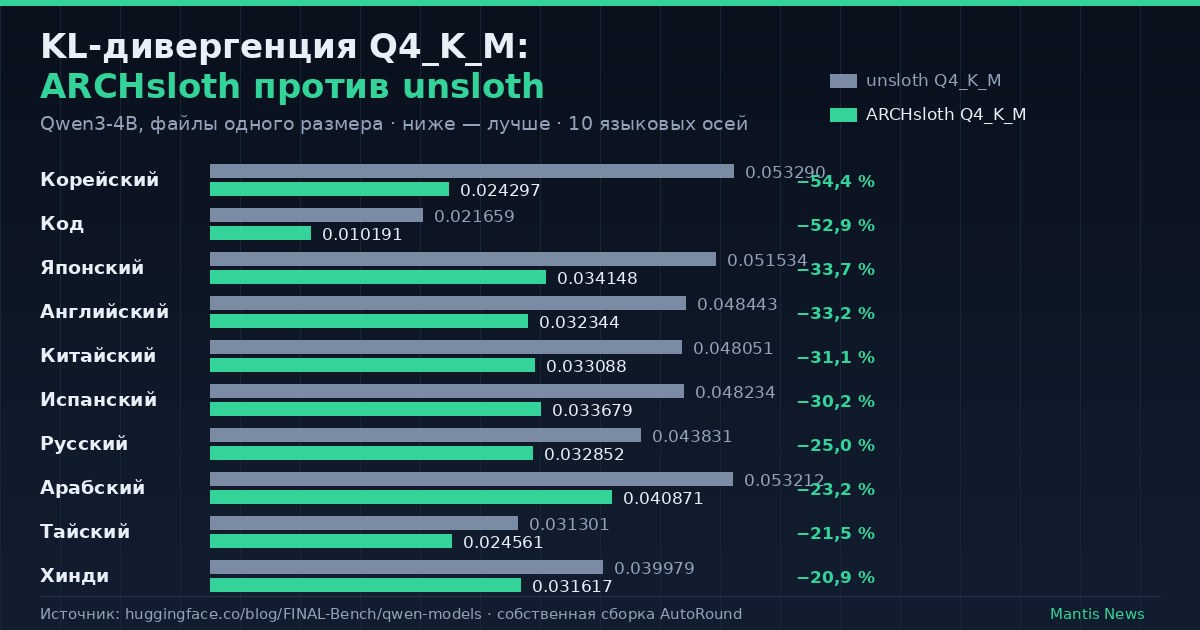
На Qwen3-4B в кванте Q4_K_M разрыв получился 54,4 % на корейском (0,024297 против 0,053290), 52,9 % на исходном коде (0,010191 против 0,021659), 33,7 % на японском и 33,2 % на английском (0,032344 против 0,048443).
Всего измерено десять осей и семь письменностей: расстояние между колонками идёт от 3,8 σ на хинди до 20,4 σ на корейском. В калибровочный набор попали только три оси — корейский, английский и код; остальные семь нужны как проверка, потому что сборка, выигрывающая один язык за счёт другого, проявилась бы именно на хинди и тайском.
Первая ошибка: оптимизировался не тот квантователь
AutoRound принимает флаг --scheme, и в команде сборки стоял W4A16 — схема 4-битных весов и 16-битных активаций, рассчитанная на тензорные ядра GPU, — тогда как экспорт шёл с --format gguf:q4_k_m. Это разные квантователи: W4A16 и Q4_K_M иначе группируют веса, иначе считают масштабы и иначе размещают нулевую точку.
Поиск округления в такой конфигурации минимизировал ошибку для квантователя, который при экспорте не использовался, а экспорт заново выводил все параметры и большую часть поиска выбрасывал. Поймать это трудно, потому что ничего не падает: GGUF получается валидным, кривая ошибки в логе идёт вниз, а файл при этом просто не лучше того, что даёт llama-quantize.
Вторая ошибка: выключенный --enable_alg_ext
--enable_alg_ext включает поиск округления по знаковым градиентам — SignRoundV2, описанный в arXiv:2512.04746. По умолчанию он выключен и стоит примерно в 1,7 раза больше времени настройки: одиннадцать минут вместо шести на одной H100.
Две эти строки в команде сборки и составляют всю разницу между колонками в первом сравнении.
Калибровочный текст выбирает направление округления
Для матрицы важности (imatrix) в llama.cpp известно, что язык калибровки почти не влияет на результат, и именно поэтому текст для калибровки обычно считают формальностью. К AutoRound это не переносится, и причина механическая: imatrix перевзвешивает веса внутри собственного поиска масштабов llama.cpp и ограничена этим поиском, а поиск округления AutoRound сам этот поиск заменяет — для каждого веса он решает «вверх или вниз», минимизируя ошибку реконструкции на калибровочных активациях.
Контрольная пара на Qwen3.5-9B подтверждает вывод: при одинаковых модели, коде, флагах, битности и размере файла корейский Mean KLD равен 0,019255 на корпусе «корейский + английский» с чередованием по образцам и 0,027336 на чисто английском — то есть 29,6 % только за счёт текста. На 27B на том же уровне Q4 та же пара даёт 31,9 %. Для сравнения, распределение бит по слоям поверх этого рецепта принесло от 0 σ до 10 % хуже.
Ещё одна деталь: чередование важнее пропорции — строгое чередование на уровне образцов при том же составе улучшило английский на 11,4 %. Добавление исходного кода сдвинуло ось кода на 52,9 %, но стоило 3,4 % корейского и 5,3 % английского, и авторы называют это сделкой, а не выигрышем.
Что не получилось и что не публикуется
27B в Q4_K_M не опубликован: он берёт корейский на 12,8 %, но отдаёт английский на 15,8 %, а уровень, на котором команда не выигрывает, она не выпускает.
Q5_K_M нет ни в одной модели коллекции: инструментарий отдаёт Q5_K с отклонением 5–6 % между оптимизированными весами и упакованным тензором, и такой файл проигрывает собственному Q4_K_M. Нашли это проверкой монотонности — файл, который становится хуже при добавлении бит, авторы считают дефектом.
Скорость совпадает: pp512 12 167 против 12 227 токенов в секунду, tg128 306,0 против 305,2 на одной H100 при трёх повторах и чередовании порядка запусков.
Перечислены и ходы, которые не сработали: четырёхкратный набор калибровочных сэмплов не дал движения при четырёхкратной стоимости, сэмплы на 4096 токенов вместо 2048 дали −2 % корейского и +23 % английского, дообучение с учётом квантования поверх поиска округления — +57 %. Общий вывод авторов такой: выравнивание, распределение бит и смешанная точность помогают при простом RTN (от −6 % до −37 %) и вредят, когда поиск округления включён (от +9 % до +57 %), поэтому рычаг нужно оценивать и с включённым поиском тоже.
Почему перплексия этого не показывает
На корейской оси при одном и том же bf16-учителе перплексия равна 8,605807 у оригинала, 8,694627 у ARCHsloth Q4_K_M и 8,948656 у unsloth Q4_K_M, то есть разрыв между двумя квантами всего 2,8 %, тогда как их KL-дивергенция различается на 54,4 %.
Разница в вопросе: перплексия спрашивает, уверена ли модель, а KL-дивергенция — уверена ли она в том же самом, и для квантования важен второй вопрос.
Все три модели лежат в одной коллекции Archsloth MODELs и собраны из оригинальных весов на стоковом llama.cpp под лицензией Apache-2.0. Карточка Qwen3-4B-GGUF содержит измерения по десяти осям, а сравнение шло против скачанных файлов из репозитория unsloth. Девять точек на кривой «размер против KL-дивергенции» — это реальные файлы, шесть скачанных и три собранных здесь.
Первоисточники
- Hugging Face — Same bytes, closer to the original: two lines of AutoRound we had wrong (ARCHsloth / FINAL-Bench, 14 сентября 2026)
- Hugging Face — Archsloth/Qwen3-4B-GGUF: модель, калибровочный корпус и сырые логи прогонов
- arXiv:2512.04746 — SignRoundV2
- Hugging Face — unsloth/Qwen3-4B-GGUF: сравнительные файлы Q4_K_M, Q6_K, Q8_0
- Hugging Face — коллекция Archsloth MODELs