Технологии
«2 500 → 30 000 слияний в день»: Anthropic построила Scion и за пять месяцев ушла с git
13 октября 2026 года инженеры Anthropic опубликовали в блоге Anthropic Engineering разбор Scion — собственной системы контроля версий, на которую за пять месяцев полностью перевели монорепозиторий компании. По данным публикации, написание кода перестало быть узким местом: в мае 2026 года Anthropic сливала в среднем около 2 500 изменений в день, а к сентябрю — более 30 000 в день, и узкое место переехало в инфраструктуру разработки, рассчитанную на человеческий масштаб.
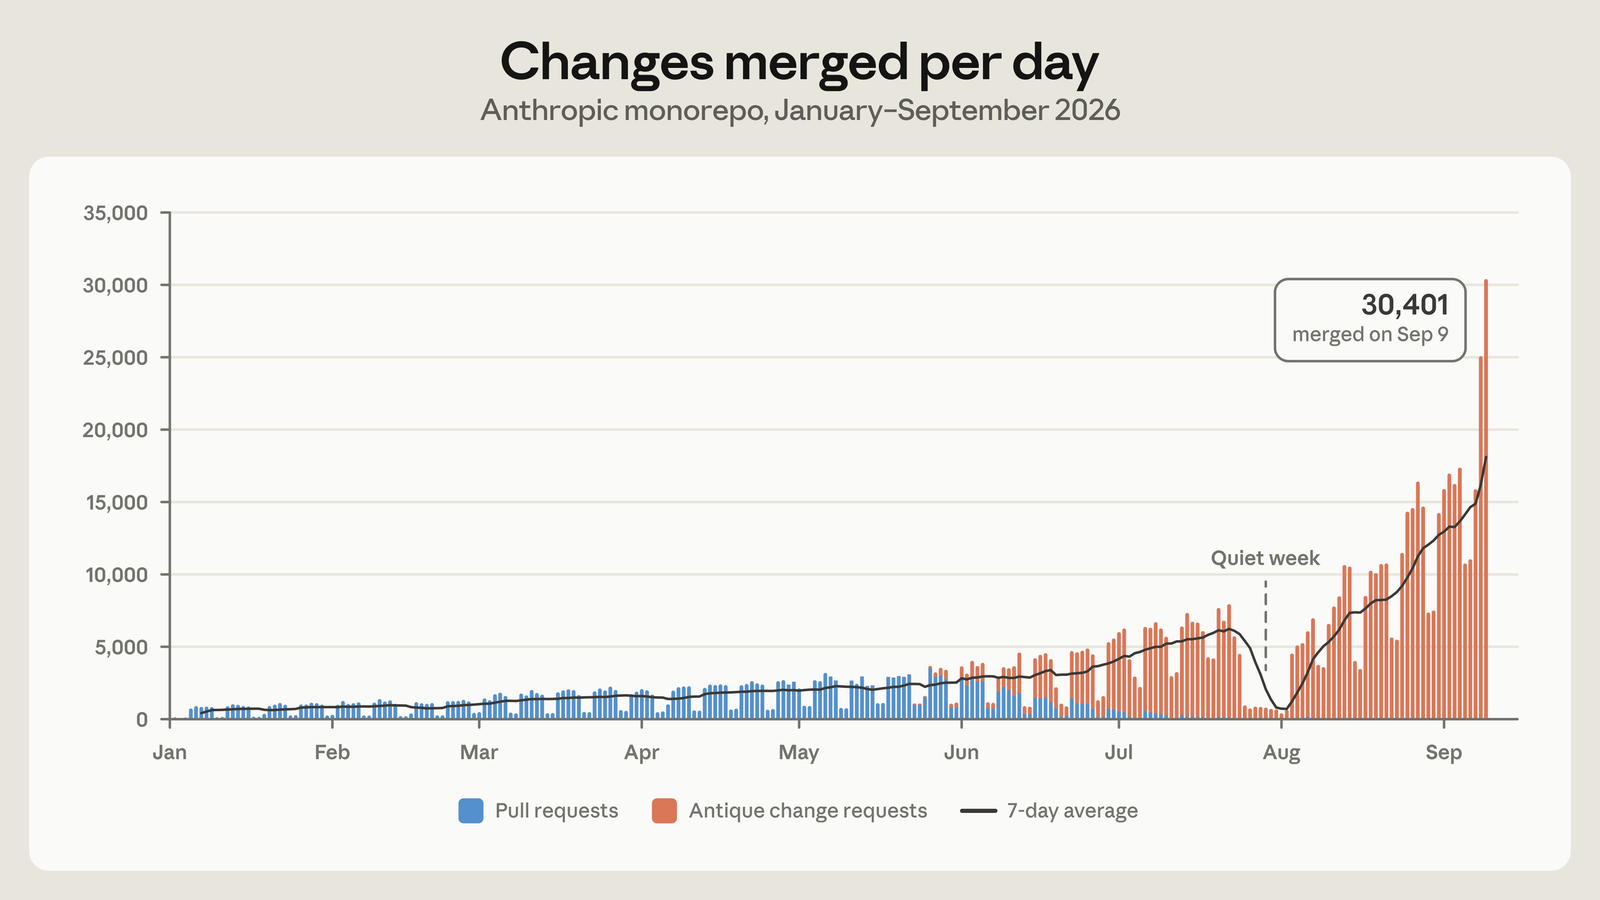
Кодинг перестал быть узким местом
По заявлению Anthropic, писать код в компании больше не узкое место: Claude автономно крутит исследовательские циклы, микрооптимизирует сложные программы и создаёт новые сервисы с нуля со скоростью и в масштабе, которых прежде не было. Узким местом стала вся инфраструктура разработки, построенная под человеческий масштаб: контроль версий, сборки и CI.
Масштаб роста в публикации измеряется слияниями: в мае 2026 года Anthropic сливала в среднем около 2 500 изменений кода в день, а по состоянию на сентябрь — более 30 000 в день. Компания не ждёт замедления и формулирует причину прямо: латентный спрос на слияния кода практически бесконечен, и каждый снятый барьер немедленно ведёт к дальнейшему росту объёма производимого кода.
Почему git перестал укладываться в свой же дизайн
git децентрализован: каждый клон — полный самодостаточный репозиторий, который умеет считать диффы, читать историю и blame и выкатывать любую ревизию полностью офлайн, и для подавляющего большинства репозиториев это правильный дизайн, во многом объясняющий, почему git стал стандартом. Монорепозиторий Anthropic в этот дизайн всё хуже помещается: только история основной ветки — почти 100 ГБ, а сжатая рабочая копия — больше 25 ГБ. Выкаток кода для CI выполняется порядка 25 млн в день, ещё до сред разработчиков, песочниц агентов и исследовательских задач, а наивная загрузка дала бы более 600 ПБ git-трафика в сутки.
Стандартные обходные пути компания перепробовала все: shallow-клоны, sparse-выкатки и promisor-ремоуты, внутренние git-зеркала и снапшоты репозитория (seeds) в блоб-хранилище. На пике работало несколько сотен внутренних git-зеркал, и это покупало время, но с ростом частоты слияний становилось всё труднее в эксплуатации: seeds всё сильнее отставали от вершины основной ветки между обновлениями, а поддерживать diff и blame на частичных клонах требовало всё больше аккуратности.
Ключевое наблюдение оказалось простым: git использовали как централизованную систему с одной авторитетной копией, но почти все клиенты — агенты и задачи, которые по определению онлайн. Свойства, делающие git превосходным для распределённой офлайн-работы, начали активно мешать масштабированию по мере роста репозитория. Отсюда вопрос, который поставила перед собой команда: как выглядел бы контроль версий, если бы его с самого начала проектировали исходя из того, что агенты всегда онлайн. Передний край здесь уже существует — Google Piper и Meta Sapling, — так что Scion строили с учётом их выстраданных уроков.
Принципы Scion
Первый принцип — клиенты всегда онлайн: git предполагает работу офлайн и полную копию репозитория, а раз почти все клиенты Anthropic — агенты и задачи, клиент и протоколы Scion проектировались вокруг всегда доступного сервера, у которого данные запрашиваются по необходимости. Второй — клиент-серверная асимметрия: в git каждый клиент способен быть полноценным сервером, а в Scion сервер отвечает на вопросы об истории и blame, создаёт коммиты, выполняет мержи и ребейзы, тогда как клиент держит ограниченный локальный кэш объектов, раскладывает рабочую копию на диске, следит за изменениями файловой системы и сам умеет считать очень немного — зато требует куда меньше данных локально.
Третий принцип — полноценный сервис контроля версий питает новые приложения: все запросы, которыми пользуется клиент, доступны по API, поэтому CI-задачам и инструментам часто вообще не нужен локальный репозиторий, и без такого дешёвого программного доступа внутренние конвейеры автоматического bisect и откатов не были бы практичными в масштабе. Четвёртый — всё должно горизонтально масштабироваться: на пике в Anthropic работало несколько сотен git-зеркал, что сильно упиралось в ёмкость и перестало масштабироваться, когда репозиторий перерос диски и лимиты памяти зеркал; в Scion данные репозитория распределены, каждый компонент масштабируется независимо, полностью материализованной копии репозитория нет нигде, даже на сервере, а аналога packfiles нет — значит, нет и обслуживания репозитория.
Пятый принцип — коммиты обязаны быть дешёвыми, инкрементальными и без блокировок: в git коммит делается локально и затем пушится, а в Scion каждый коммит, ребейз или мерж происходит на сервере, поэтому пушить нечего, но стоимость создания коммита и обновления его нижележащих структур данных должна расти с размером изменения, а не с общим размером репозитория. Жизненный цикл в Scion не поощряет ссылки (refs) — указатели на коммиты вроде веток и тегов — кроме основной ветки и релизных, потому что глобальное состояние, о котором обязаны договориться все серверы, это зреющая проблема масштабирования. Шестой принцип — рабочая копия необязательна и разрежена по дизайну: протокол Scion построен вокруг sparse-выкаток, содержащих только запрошенные каталоги, и виртуализированных выкаток, материализующих файлы по требованию, поэтому задача платит только за то, что реально читает.
Как устроен Scion
Единица работы в Scion — changeset, запись в журнале упреждающей записи (write-ahead log). В отличие от коммита git, который хранит указатель на дерево, changeset хранит список файлов, изменённых относительно первого родителя, вместе с content-addressed указателями на сжатое содержимое в блоб-хранилище. Changeset создаётся на стороне сервера и мгновенно доступен везде, и именно эта структура позволяет принимать изменения с очень высокой пропускной способностью: нет packfiles, нет блокировок и межсерверной координации, не нужно двигать ссылки. Ссылки Scion технически поддерживает, но поскольку ни создание, ни получение коммитов их не задействуют, перемещение ссылки — это compare-and-swap по одной строке Spanner, происходящий отдельно от создания changeset.
Поскольку changeset фиксирует только изменения, сам по себе он не может быстро ответить, кто последним правил строку или какие коммиты затронули файл. Поэтому Scion строит дополнительные структуры: отдельные для blame и истории путей и skip-списки для графа коммитов. Всё, что не является непосредственно частью changeset, называется производными данными (derived data) и вычисляется одним общим механизмом, где значение для каждого changeset рекурсивно считается из значений его родителей. Это даёт три выгоды: новый тип производных данных легко добавить, для каждого типа можно выбирать между немедленным и отложенным вычислением, а внутренности структур можно оптимизировать, не меняя клиент — за время роста системы новые типы производных данных добавлялись многократно, например новые индексы для обнаружения копирований и поиска файлов по пути.
Флот серверов Scion отдаёт API для любой операции, нужной клиенту: получение changeset, вычисление диффов, поиск базы слияния, загрузка блобов. Все данные контролируются по содержимому (content-addressed), поэтому однажды сохранённый объект никогда не меняется и любой сервер может кэшировать его, не сверяясь с остальными: серверы горизонтально масштабируемы и почти не требуют координации, по сути это большие кэши, которые умеют вычислять производные данные на лету и записывать результат обратно в Spanner.
Клиент scn отклоняется от протоколов загрузки git принципиально: согласование не сообщает серверу, что у клиента уже есть, а работает исключительно с деревьями и блобами, которые клиент хочет получить. Начиная с корневого дерева, клиент проверяет локальное хранилище на отсутствующие деревья и запрашивает их рекурсивно, затем повторяет процесс для блобов. Каждый запрос — за конкретным неизменяемым объектом, поэтому ответить на него может любой кэш, и архитектура близко напоминает традиционные многоуровневые кэши; процесс эффективен и возобновляем, потому что в ответе нет единственного многогигабайтного packfile, а разреженные и даже виртуализированные выкатки не требуют специальной поддержки — клиент просто не запрашивает ненужные деревья.
Внутри узла клиент общается по сокету с демоном scion-daemon, который хранит объекты для всего узла. Каждый демон стартует с периодически обновляемого снапшота и говорит только с региональными кэш-серверами scion-cache, которые стримят объекты прямо из памяти в том дисковом формате, который потребит демон, не тратя время на вычисление отсутствующих объектов и дельта-сжатие. Когда объекта нет и в кэше, тот обращается к авторитетным scion-servers, читающим из Spanner или облачного хранилища по необходимости. Демон, кэш и сервер отвечают на идентичные RPC, поэтому клиенту не нужно знать топологию кэшей, но уровни жёстко разделены, чтобы сбой регионального кэша не перегрузил вышестоящие серверы и не уронил всю систему.
Что это дало на практике
Каждый уровень системы держит долю попаданий в кэш выше 99% и не требует долгоживущего состояния, поэтому масштабировать его при необходимости просто. Инфраструктурный след Scion теперь в 200 раз меньше, чем у прежней инфраструктуры git-зеркал, по требованиям к CPU и памяти. CI и исследовательские задачи выкатывают код на два порядка быстрее — секунды вместо минут, — что высвобождает заметный объём мощностей: только CI дал выигрыш в 25% CPU-ёмкости. Ни клиентам, ни кэшам не нужно выполнять обслуживание репозитория, что упрощает управление жизненным циклом задач.
Чему Anthropic научилась на Scion
Строить Scion начали примерно тогда же, когда внутри компании появились Claude Mythos Preview и Claude Tag, и оба релиза одновременно усилили потребность в системе и заметно ускорили её создание. Самый показательный пример: первую версию конвейера загрузки из git в Scion в основном написали руками как прототип, а на раннем внутреннем снапшоте Claude Mythos Preview попросили переписать его целиком — без дополнительных указаний модель выдала версию, которая потребляет в 20 раз меньше памяти и работает в 4 раза быстрее, сохранив все неявные инварианты вокруг порядка загрузки и структур данных.
Команда из семи человек построила и Scion, и инструмент код-ревью Antique, и ещё полдюжины связанных систем, и полностью перевела компанию на них за пять месяцев — при росте объёма слияний за день в 10 раз. Раньше разработка и внедрение подобной системы контроля версий заняли бы у компании годы итеративной миграции и куда больше инженеров, и Anthropic ждёт, что быстрые и гибкие миграции станут встречаться чаще.
Роль инженеров при этом не обесценивается, а меняется: все, кто работал над системой, теперь оценили бы Claude как лучшего автора кода, чем они сами, но именно инженеры давали понимание высокоуровневых межсистемных компонентов и компромиссов дизайна — какие задачи решать и какого масштаба достигать. Очень часто роль инженера сводилась к тому, чтобы сказать Claude «нет»: агенты нарушают ключевые ограничения системы, чтобы удовлетворить шаблону, который вообще не следовало допускать. Например, несколько систем пытались грубой силой выяснять, когда изменение влилось в основную ветку, линейно читая лог коммитов вместо обращения к инструменту код-ревью; состязательное ревью, будучи очень эффективным, бывает близоруким, и инженерам приходилось уводить модель от переусложнения — один такой разбор был чрезмерно недоверчив к другому внутреннему сервису, что привело к избыточной валидации и сложности. Каждый запрос на изменение для этой системы команда по-прежнему ревьюит, но теперь изучает замысел изменения, а не читает каждую строку кода.
Качество и оптимизацию удалось заметно улучшить: благодаря способности Claude писать огромные объёмы кода быстрее людей Scion стала одной из самых протестированных и защищённых кодовых баз, над которыми работала компания, — включая герметичные симуляции всех нетривиальных взаимодействий инфраструктуры и контроля версий, фаззинг и сложное ограничение скорости. Попутно Claude находил значимые оптимизации, например алгоритмическую оптимизацию запросов о происхождении изменений, где был пропущен один из индексов, — работа, которая у эксперта заняла бы дни или недели анализа.
Отдельно Anthropic пересматривает привычки, рассчитанные на человеческий масштаб: полноценная очередь слияний на агентском масштабе теряет смысл, а вопрос ставится прямо — что вообще значит CI, когда сотни и даже тысячи изменений успевают влиться, пока идут тесты. Отраслевой стандарт глобальной блокировки репозитория на очереди слияний воспроизвести не удалось, поэтому компания инвестирует в пост-мерж- и пре-деплой-тестирование: конкурентные изменения могут конфликтовать, но Claude обычно правит такие конфликты быстрее, чем люди успевают их опознать. Для наблюдаемости команда завела «суперфанатов» — каналы в Slack, где Claude одержимо следит за здоровьем одного конкретного компонента: есть scion-daemon superfan, scion-cache superfan, Antique merge queue superfan и другие, у каждого доступ к телеметрии и логам.
Границы своего решения Anthropic оговаривает прямо: Scion ни в коем случае не замена git общего назначения, и описанные концепции осмысленны только для действительно огромных монорепозиториев, где код пишут десятки тысяч инженеров или рои агентов, а сама компания уникальна тем, что может тратить на внутренние нужды больше токенов, чем любой другой бизнес счёл бы разумным. Предложить Scion в широко полезном виде тоже трудно: она сильно расходится с git, требует собственного код-ревью, поиска по коду и CI, а внутренние версии этих компонентов глубоко специфичны. Поэтому самый полезный шаг, по мнению компании, — делиться своими соображениями: серверу git не обязательно работать так же, как клиенту, платформы могут предоставлять полноценные серверные RPC, возможно даже стандартизованные между форжами, а протокол согласования не обязан выглядеть как сегодня. Anthropic отдельно отмечает, что сообщество git почти два десятилетия масштабировало платформу для миллионов разработчиков, а её собственный вклад куда уже — ранний взгляд на то, как агентская разработка взаимодействует с этими системами, чтобы вместе с GitHub, GitLab и сообществом открытого кода поддержать меняющиеся нужды разработчиков.