Безопасность
OpenAI описала Defense Factory — непрерывный конвейер киберзащиты с AI-агентами
Архитектура связывает инвентаризацию, поиск, воспроизведение, назначение владельца, исправление и повторную проверку. В собственном security sprint OpenAI задействовала более 250 человек, но автоматизацию наращивала только после ручной проверки результатов.
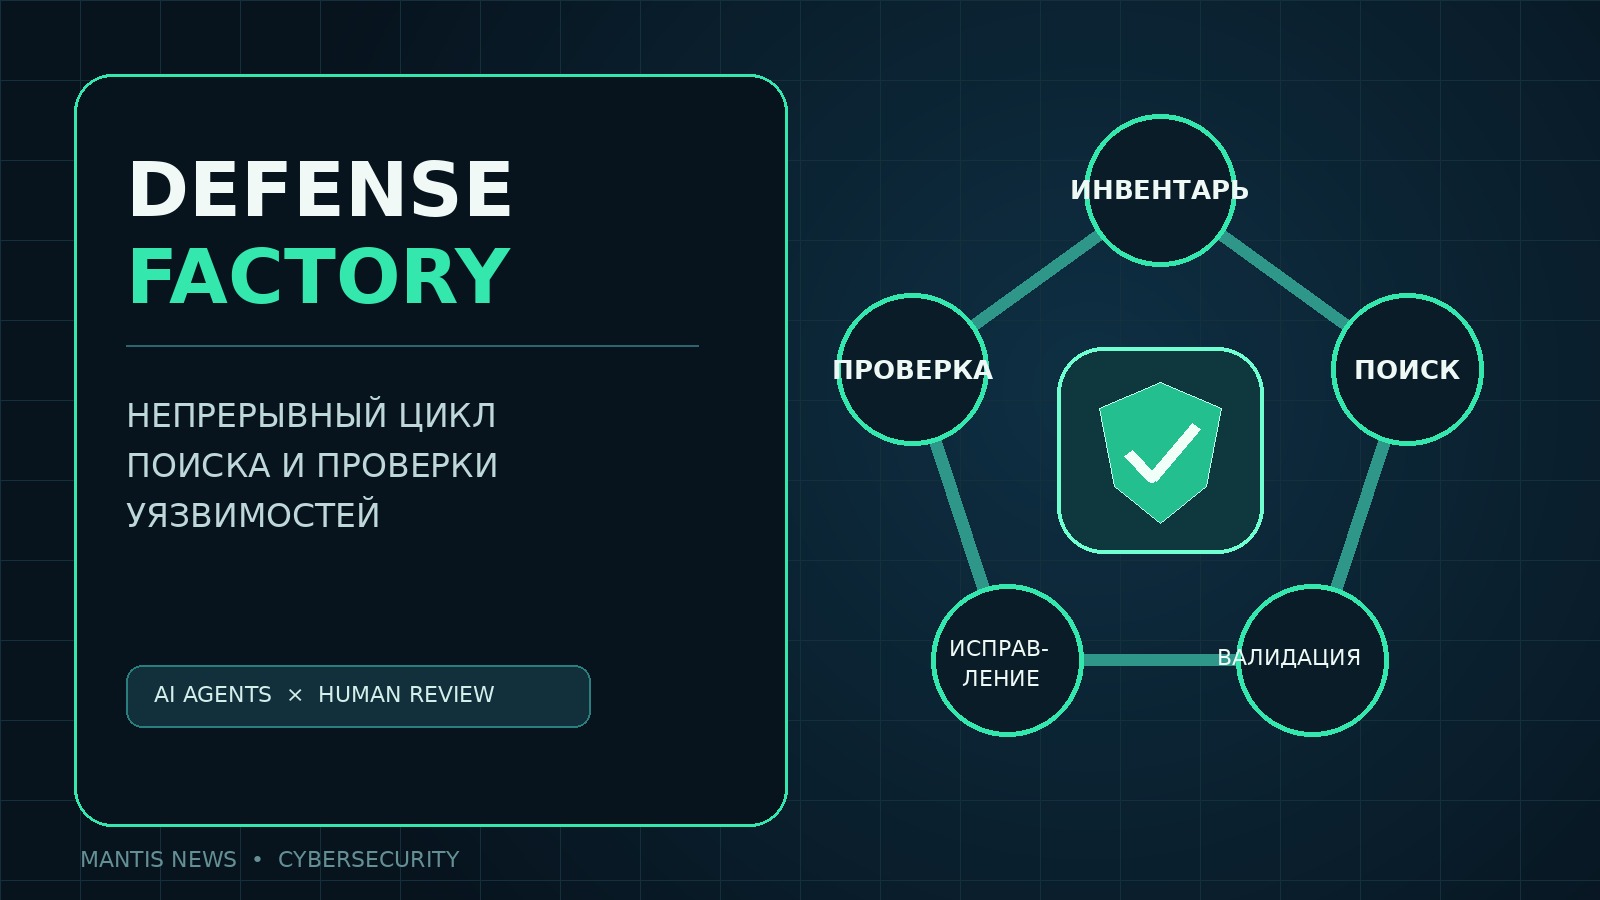
Defense Factory превращает разовые проверки в постоянный процесс
OpenAI представила Defense Factory как непрерывную agent-first операцию для поиска и исправления уязвимостей. Вместо периодического аудита она связывает существующие security-инструменты, инженерные системы и AI-агентов в повторяемый цикл: новые сигналы автоматически исследуются, подтверждаются в изолированной среде, получают владельца, превращаются в проверенный patch и после deployment тестируются ещё раз.
Компания объясняет срочность изменением возможностей атакующих. По её оценке, долгоживущие агенты уже способны сохранять знания между сессиями, связывать несколько слабых мест в цепочку эксплуатации и работать флотами. Защитникам OpenAI приписывает два временных преимущества: прямой доступ к собственному коду и возможность применять frontier models раньше, чем сопоставимые возможности широко распространятся в open-weight моделях.
Это не отдельный сканер и не замена всему действующему security stack. В опубликованной схеме исходными системами остаются GitHub или GitLab, Snyk, Semgrep и Tenable, а также Jira, Linear или ServiceNow. Defense Factory выступает связующим слоем: агенты обращаются к инструментам через MCP, CLI или API, а reusable skills задают конкретные рабочие процедуры.
Цикл начинается с инвентаризации и заканчивается независимой проверкой
OpenAI разделяет защитный цикл на пять стадий. Сначала организация сопоставляет облачные ресурсы, конфигурацию deployment, код и владельцев сервисов. Затем агенты ищут или импортируют находки, воспроизводят потенциальную уязвимость, проверяют её реальную эксплуатируемость, назначают ответственного и готовят исправление. Финальный этап включает deployment и отдельную проверку того, что дефект действительно устранён.
Общий контекст предлагается хранить в SECURITY.md. Это не ещё один шаг конвейера, а накопительная карта системы: сведения об архитектуре, владельцах, прошлых расследованиях и тестах переходят в следующий проход. Благодаря этому агенту не приходится каждый раз начинать анализ с нуля, а команда может сосредоточиться на изменениях и нерешённых рисках.
Автоматизация при этом не означает автономное изменение production без контроля. В описании OpenAI люди проверяют существенные изменения и независимо подтверждают deployed fixes. Практический критерий зрелости здесь — не число запущенных агентов, а сокращение времени от находки до воспроизводимого и проверенного исправления при сохранении границ доступа.
Изолированные воспроизводимые среды стали обязательной частью архитектуры
Агентам нужны среды, где можно запустить сервис, воспроизвести уязвимость и проверить patch без риска для production. OpenAI называет такие environments основой автономного защитного цикла: они должны автоматически создаваться в нужном масштабе, содержать необходимые зависимости и конфигурацию, быть эфемерными и удаляться вместе с состоянием после каждого запуска.
В референсной архитектуре control plane отвечает за orchestration, применение политик и credential proxy, а data plane содержит development environments, их identities и host monitoring. Отдельный надзорный слой охватывает host activity, инфраструктурную безопасность и audit действий агентов. Такое разделение важно, потому что агент, который исследует эксплуатацию, сам получает доступ к чувствительному коду, секретам и исполняемым средам.
OpenAI перечисляет в агентном слое Codex Desktop, Codex CLI и Codex Security CLI, а среди моделей — Astra, Sol, Terra, Luna, Daybreak Blue и Daybreak Red. Но опубликованная схема не делает конкретный набор обязательным для каждой компании: её основной переносимый принцип — изоляция, воспроизводимость, контролируемые credentials и проверяемый workflow вокруг уже существующих инструментов.
Собственный sprint показал масштаб, но также необходимость ручного контроля
В недавнем security sprint OpenAI задействовала более 250 человек и применила свои новые cyber models для поиска, подтверждения и исправления уязвимостей в сотнях систем. Работу организовали с интенсивностью incident response, а срочные и high-priority проблемы начали устранять ещё до завершения полной инвентаризации. По данным компании, в первый день были закрыты 53 такие проблемы.
Автоматизацию наращивали небольшими партиями. Раннее назначение владельцев зависело от ручного поиска команды; после превращения сведений о сервисах и ownership в reusable inputs доля принятых назначений достигла 90,6%. При triage команда версионировала severity rubric и prompts, добавляла повторяемые evaluations и human spot-checks; 37% находок в этом процессе были определены как дубликаты.
Runtime validation воспроизвела 19,5% находок, а заявленная доля false positives после динамической проверки составила 0,81%. Исправления генерировались с помощью Codex, но последующие проверки обнаружили разрыв между merged patch и фактическим deployment по всему fleet. Поэтому OpenAI расширила повторную верификацию, сохранив автоматическое переоткрытие проблем выключенным до проработки задержек deployment.
Начинать предлагается с одного workflow, а не с полной автономии
Главный организационный вывод OpenAI — разделять то, что агент технически умеет сделать, и то, что ему уже разрешено менять. Компания начинала с ручных шагов и небольших проверяемых batches, затем убирала повторяющиеся handoffs только после накопления доверия к результатам. Люди постепенно переходили к настройке границ, обработке исключений и проверке итогов.
Для внедрения OpenAI предлагает сначала согласовать один защитный workflow, затем получить доступ к cyber models и запустить skills из Codex Security plugin для поиска, валидации и подготовки исправлений. Подход рассчитан на постепенное расширение, а не на одновременную автономизацию всего контура безопасности.
Опубликованные проценты и результаты относятся к внутреннему опыту OpenAI и не являются независимым benchmark для других организаций. Их ценность — в описании контрольных точек: воспроизводимость, дедупликация, подтверждённая эксплуатируемость, явный владелец, tested patch и повторная проверка после deployment. Без этих связей множество автономных сканирований способно лишь увеличить очередь непроверенных сигналов.