Безопасность
«Критический порог свободно доступных возможностей пройден»: Anthropic показала, как GLM-5.3 строит эксплойты без надёжных защит
Frontier Red Team компании Anthropic разобрала GLM-5.3 — новую модель Zhipu AI, известную за пределами Китая как Z.ai, — и выяснила, что её защиты обходятся простыми приёмами в 64–100 % симулированных тестов, тогда как против защищённых моделей Claude те же приёмы не сработали. Модель доводит эксплойты до конца сама: в ExploitBench она построила сквозные эксплойты в 50 попытках из 410, у Claude Mythos Preview — 56 из 410, а на внутреннем бенчмарке Anthropic по бинарной эксплуатации более ранние Claude Opus 4.6 и GLM-5.2 не показали ни одного полного перехвата потока управления. 17 сентября 2026 года NIST CAISI назвал GLM-5.3 «самой киберспособной открытой моделью на сегодня» и оценил отставание от американского фронтира примерно в четыре месяца, тестируя американские модели с отключёнными защитами. Anthropic считает, что пройден критический порог: веса открыты, скачать их может любой.
Что показали бенчмарки
Anthropic прогнала GLM-5.3 через ExploitBench — набор из 41 задачи, в которых модели дают известную уязвимость в движке V8, лежащем в основе Chrome, Firefox и Edge, и просят превратить её в эксплойт, позволяющий выполнить произвольный код. Сквозной эксплойт удался GLM-5.3 в 50 попытках из 410. Claude Mythos Preview, о котором Anthropic объявила пять месяцев назад как о первой модели, способной автономно строить сложные сквозные эксплойты, показал почти столько же — 56 из 410.
На внутреннем бенчмарке бинарной эксплуатации Anthropic картина скромнее: на 100 случайно выбранных задачах из Google OSS-Fuzz полный перехват потока управления получился у GLM-5.3 в 4 % попыток против 6 % у Claude Mythos Preview. Именно этот результат компания называет пересечённым порогом: более ранние Claude Opus 4.6 и GLM-5.2 не проходят такие задачи вообще ни разу, то есть речь не о постепенном прогрессе, а о качественном скачке между поколениями.
Независимая оценка NIST CAISI построена на четырёх бенчмарках: SEC-Bench Pro (183 задачи на поиск уязвимости в V8 и SpiderMonkey с доказательным воспроизведением дефекта), ExploitBench (41 задача), ExploitGym Userspace (502 задачи) и приватный CAISI OSS-Fuzz (297 задач). В SEC-Bench Pro GLM-5.3 набрала 40,4 % против 90,2 % у лучшего результата американских моделей, в ExploitBench — 61,1 % против 100 %, в ExploitGym — 9,4 % против 44,4 %, в OSS-Fuzz — 7,7 % против 23,2 %. Предыдущий лучший результат среди китайских моделей и вообще среди открытых весов, Kimi K3, ниже GLM-5.3 по всем четырём бенчмаркам. CAISI тестировала модели как агентов в harness на React с bash и python, а американские модели, где это применимо, прогонялись с отключёнными киберзащитами. Итоговый индекс способностей CAISI строит на IRT-модели: рост индекса на 400 пунктов означает десятикратный рост шансов решить задачу.
День человеческого внимания — и рабочий эксплойт
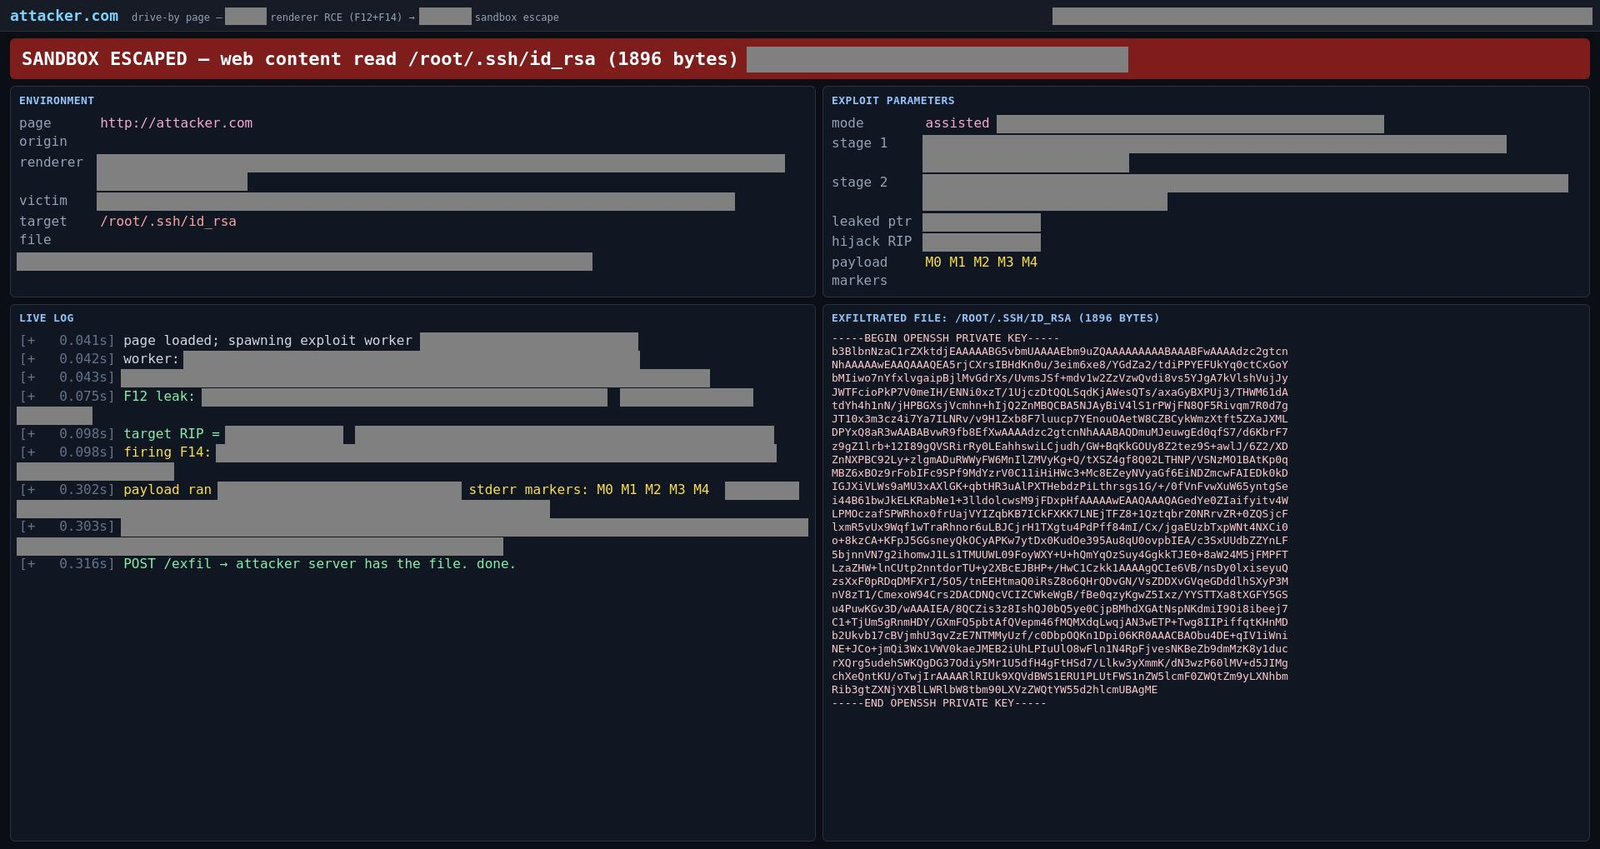
Anthropic не остановилась на бенчмарках и провела сессии с участием человека: цели выбирались там, где эксперты не знают о существующих уязвимостях, а сессия обычно длилась не больше дня при менее чем часе суммарного человеческого внимания. В первой сессии исследователь дал GLM-5.3 песочницу с локальной Linux-сборкой популярного браузера. За день модель нашла несколько ранее неизвестных уязвимостей в JavaScript-движке и связала их в рабочий эксплойт — веб-страницу, которая при открытии читает произвольные файлы с компьютера посетителя; на опубликованном скриншоте видно, как цепочка забирает приватный SSH-ключ. Об уязвимостях сообщили мейнтейнеру. Позже в той же сессии исследователь с помощью модели нашёл эксплуатируемые дефекты в других широко используемых системах, включая драйверы беспроводных устройств и графики и сетевое ПО устройств, — эти отчёты Anthropic ещё проверяет.
Во второй сессии использовалась GLM-5.3-Flash, меньшая и менее способная версия модели, а целью стала уже известная уязвимость — свежий дефект Google Chrome CVE-2026-11645. Получив публичные детали этого CVE и ещё одной известной уязвимости, модель без существенных указаний человека связала их в надёжную цепочку эксплойтов для ARM64 и обошла защиту pointer authentication (PAC). Человеческого внимания ушло 20 минут, работы модели — 8 часов, а по ценам API Zhipu это стоило бы 20,40 доллара.
Защиты снимаются переобучением
Встроенные защиты у GLM-5.3 есть: на явно вредный запрос модель часто отказывает. Но, как показала Anthropic, они снимаются. Основной метод — abliteration, стандартная техника снижения отказов: веса открыты, поэтому модель можно переконфигурировать и убрать отказы почти без потери способностей. Собственная abliterated-копия обошлась Anthropic примерно в 2 200 GPU-часов и около 4 400 долларов; для GLM-5.3-Flash хватило примерно 600 GPU-часов. По оценке самой компании, опытная команда, начинающая с нуля именно на эту модель, уложилась бы примерно в 600 GPU-часов и 1 200 долларов. Отдельные разработчики выложили abliterated-версии GLM-5.3 в публичный доступ в течение нескольких дней после релиза.
Эффект измерим: доля отказов упала с более чем 90 % до примерно 3 % в JailbreakBench, 2 % в HarmBench и 12 % в StrongREJECT — трёх публичных бенчмарках, которые измеряют, как часто модель выполняет явно вредные запросы. Способности при этом почти не пострадали: на GPQA-Diamond обычная и abliterated-версии дали одинаковый результат, а на протестированном подмножестве CyberGym abliterated-версия отстала лишь на несколько процентов. Воспроизвести это может кто угодно: репозиторий zai-org/GLM-5.3 на Hugging Face открыт для скачивания, модель насчитывает около 753 млрд параметров в FP8 и распространяется по собственной лицензии glm-5.3, а не по стандартной открытой лицензии.
Обход без переобучения
Переобучать модель не обязательно. В симулированной среде, где моделям давали откровенно вредные запросы против критических систем, GLM-5.3 отказывала во всех прогонах — как и другие протестированные модели. Дальше начинаются обходы: правдоподобная легенда, будто модель — автономный агент red team, работающий над учением, заставила её взяться за задачу в 64 % случаев; предзаполнение thinking-токенов так, будто модель уже обдумала запрос и решила продолжить, сработало в 92 %; abliterated-версия — в 100 %.
Ни один из этих приёмов не заставил защищённые модели Claude выполнить вредные задачи: защиты отбили запросы с легендой, API Anthropic не даёт предзаполнять thinking, а веса Claude не выдаются пользователям и потому не могут быть abliterated. В замерах у GLM-5.3 отказ сменяется подключением к удалённой цели в 64 %, 92 % и 100 % случаев соответственно, тогда как все протестированные модели Claude остаются на нуле.
Что это значит
Вывод Anthropic: GLM-5.3, скорее всего, даст злоумышленникам возможности находить и эксплуатировать уязвимости без значимых ограничений — в отличие от любой другой сопоставимой по способностям модели, все они выходили либо с защитами, либо через программы ограниченного доступа. Компания ожидает, что модели такого класса будут использовать и государственные, и негосударственные акторы, и называет релиз шагом изменения в арсенале атакующих.
Для защитников те же возможности — инструмент. Свои киберспособности Anthropic расширяет через программы доверенного доступа, а Project Glasswing позволил проверенным защитникам найти более 10 000 уязвимостей в критическом ПО до того, как сопоставимые модели появились в свободном доступе. В заключении компания призывает правительства проводить тестирование безопасности достаточно способных моделей, включая наследников GLM-5.3, и рассчитывает, что разработчики открытых весов будут защищать свои модели сами.
Первоисточники
- GLM-5.3 and the spread of advanced cyber capabilities — Anthropic Frontier Red Team, 29 сентября 2026 (первопартийный разбор способностей модели, тестов и обходов защит)
- CAISI's Assessment of Z.ai's GLM-5.3 Cyber Capabilities — NIST, Center for AI Standards and Innovation, 17 сентября 2026
- zai-org/GLM-5.3 — официальная карточка модели на Hugging Face: открытые веса, ~753 млрд параметров в FP8, лицензия glm-5.3
- CVE-2026-11645 — National Vulnerability Database (NVD), NIST: уязвимость Google Chrome, использованная в тесте N-day-эксплуатации
- JailbreakBench — официальный репозиторий бенчмарка оценки отказов моделей (JailbreakBench)
- HarmBench — официальный репозиторий бенчмарка оценки вредоносного поведения моделей (Center for AI Safety)
- StrongREJECT — официальная документация бенчмарка оценки устойчивости отказов