Безопасность
«Сколько этой ручной работы можно отдать LLM-агенту»: GitHub Security Lab выпустила автономный фаззинг-конвейер для C/C++
24 сентября GitHub Security Lab опубликовала разбор Fuzzing Taskflow — автономного конвейера фаззинга для проектов на C/C++, который строится поверх фреймворка Taskflow Agent и запускается из Codespace одной командой. Материал написал Antonio Morales из GitHub Security Lab. Отправная точка автора: непрерывный фаззинг не решает всех проблем — даже проекты, годами участвующие в OSS-Fuzz, продолжают скрывать критические баги, и причина почти всегда одна: кто-то должен следить за покрытием, писать новые харнессы для недостижимого кода и разбирать краши.
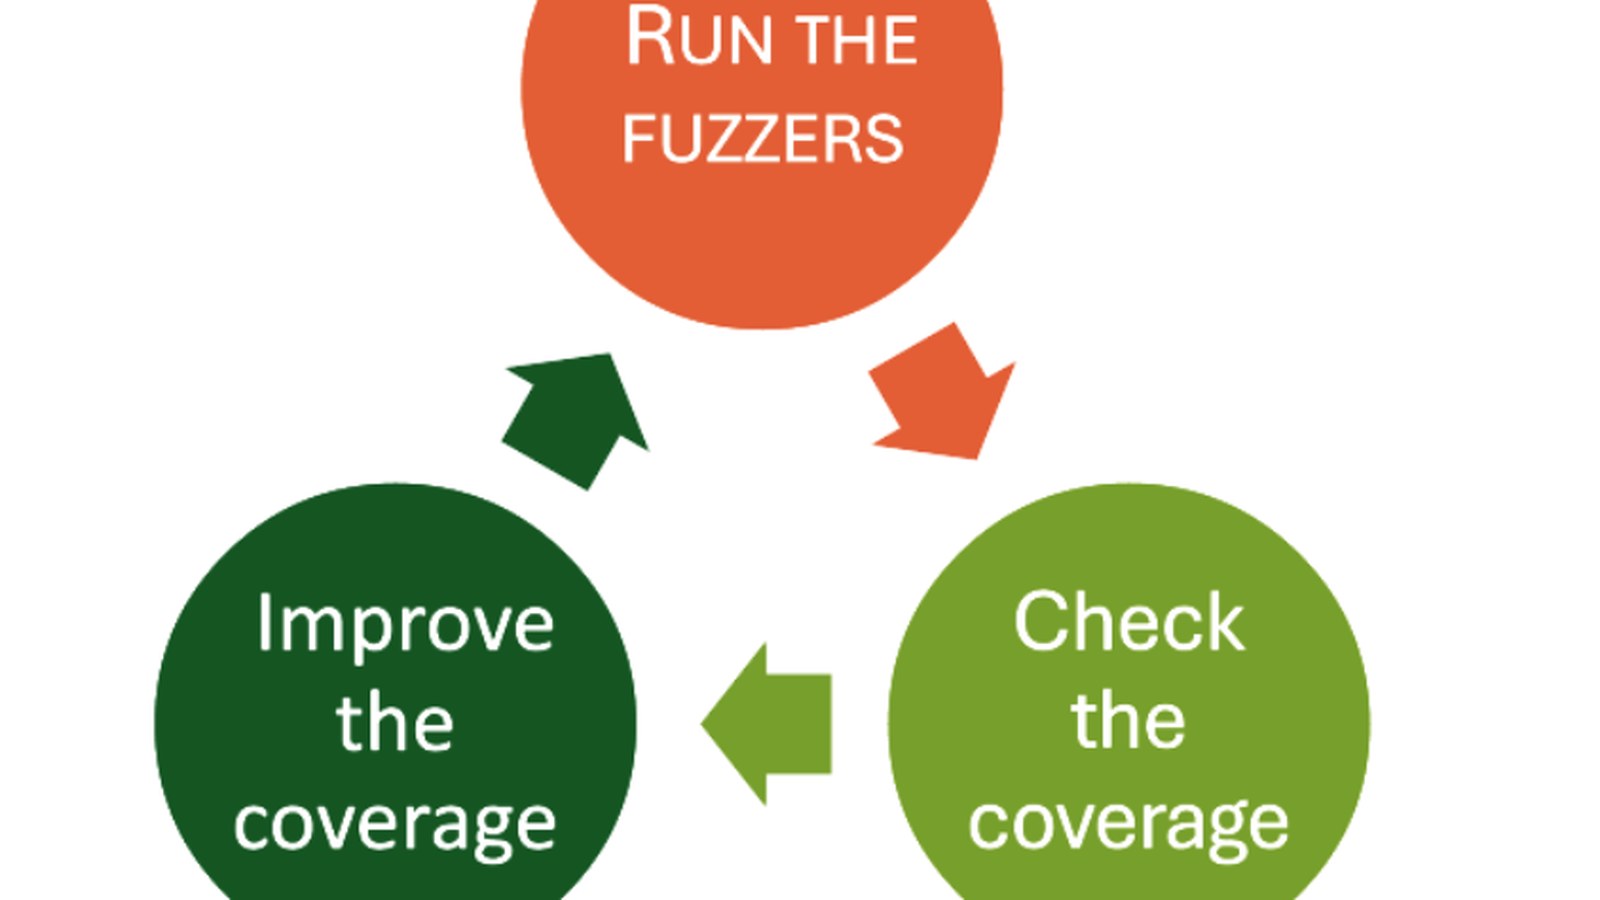
Даже проекты, которые годами участвуют в OSS-Fuzz, всё ещё скрывают критические баги, и причина почти всегда одна: кто-то должен следить за покрытием, писать харнессы для кода, до которого никто не доходит, и разбирать краши, которые выходят на другом конце, — то есть фаззингу по-прежнему нужен человек в цикле. Отсюда вопрос, который автор задавал себе: сколько именно этой ручной работы можно отдать LLM-агенту.
Ответ — Fuzzing Taskflow, автономный конвейер фаззинга для проектов на C/C++, которому достаточно указать GitHub-репозиторий. Дальше он делает всё сам: находит подходящие точки входа, разбирает систему сборки, пишет харнессы, запускает AFL++, читает отчёты о покрытии, улучшает харнессы, разбирает каждый краш и пишет отчёт об уязвимости для каждого уникального бага — без человека рядом. Конвейер построен поверх GitHub Security Lab Taskflow Agent, фреймворка для LLM-автоматизации в безопасности; сам фреймворк описан как MCP-ориентированный мультиагентный каркас для декларативных, YAML-описанных агентных сценариев, собранный на OpenAI Agents SDK.
Запуск: Codespace, одна команда и предупреждение
Проще всего запустить конвейер прямо из репозитория GitHubSecurityLab/seclab-taskflows-fuzzing: открыть Codespace и выполнить скрипт./scripts/fuzzing/run_fuzzing.sh, передав ему слаг владельца и репозитория — например tukaani-project/xz. Для быстрой проверки перед длинной кампанией автор советует указать что-нибудь небольшое, вроде DaveGamble/cJSON. Аргумент — это просто GitHub owner/repo, а всю предварительную работу агент берёт на себя: ставит AFL, клонирует репозиторий, определяет наиболее релевантные функции в коде и создаёт под них фаззинг-цели.
Перед запуском автор предупреждает: конвейер выполняет afl-fuzz, clang и произвольные команды сборки, выбранные LLM, прямо на хосте, без контейнера между ними. Агент, в промпт которого внедрили инструкцию, мог бы в принципе сделать всё, что может пользователь, поэтому запускать это стоит только в одноразовой среде — Codespace или временной виртуалке — и без повышенных привилегий.
Модель тоже выбирается осознанно: по умолчанию в конвейере используется Claude Sonnet 5, потому что она прошла все внутренние тесты без замечаний, а сменить модель можно в файле src/seclab_taskflows_fuzzing/configs/model_config.yaml.
Три слоя и жёсткое разделение ответственности
Архитектурно конвейер состоит из трёх слоёв: shell-драйвер run_fuzzing.sh, который связывает стадии между собой; набор taskflow-YAML, по одному на стадию, и это по сути промпты, говорящие агенту, что делать на каждом шаге; и набор MCP-инструментов, которые агент вызывает, чтобы реально выполнить работу — запустить AFL, скомпилировать харнесс, сохранить краш, прочитать отчёт о покрытии.
Главное проектное правило — чистое разделение ролей: решения принимает LLM-агент, а исполнение остаётся за MCP-инструментами. Агент решает, что фаззить, какой харнесс написать и за каким пробелом в покрытии гнаться; инструменты дают только примитивы вроде run_afl_for или compile_harness, и агент никогда не вызывает AFL или clang напрямую. Всё состояние живёт в базе SQLite fuzz_context.db, поэтому стадии никогда не передают данные друг другу в памяти — только через базу.
Ещё одна деталь: каждый харнесс собирается дважды. Инструментирование рёбер AFL хорошо ведёт фаззер, но бесполезно для читаемых человеком отчётов о покрытии. Поэтому каждый харнесс превращается и в.afl-бинарник (сборка через afl-clang-lto -fsanitize=address,undefined), и в.cov-бинарник (clang -fprofile-instr-generate -fcoverage-mapping): первый фаззит, а второй позже проигрывает очередь AFL, чтобы получить настоящие данные о покрытии по строкам исходников и ветвям.
Цикл обратной связи по покрытию: от 30 секунд до 32 минут
Сердце конвейера — цикл обратной связи, и именно он автоматизирует работу, которую раньше делал человек: «проверить покрытие» означало вручную читать LCOV-отчёт в поисках непокрытых ветвей, а «улучшить покрытие» — писать новый харнесс или придумывать новый вход.
На каждой итерации для каждого харнесса агент гоняет AFL в течение заданного бюджета времени, проигрывает очередь против.cov-бинарника, чтобы получить реальный отчёт о покрытии, и читает список непокрытых ветвей. По результатам он выбирает одно из нескольких действий: добавляет новый сид, сконструированный под непокрытую ветвь; правит исходник харнесса, чтобы вызвать дополнительный API; автоматически пополняет словарь AFL магическими константами, с которыми сравнивается защитная проверка; или просто пропускает пробел, если это холодный путь ошибки либо вендорный код, за которым не стоит гнаться.
Бюджеты времени удваиваются каждую итерацию: 30 секунд, минута, две, четыре, восемь и шестнадцать — примерно 32 минуты на цель. Логика такая: дешёвые короткие раунды в начале, когда много легкодоступного покрытия, и длинные позже, когда фаззеру нужно больше времени, чтобы пробить сложную проверку. Остановка формализована через детекцию плато: как только две итерации подряд приносят меньше задаваемого порога — по умолчанию 1 % абсолютного построчного покрытия — цикл решает, что отдача падает, и двигается дальше, чтобы не жечь часы вычислений ради последних десятых процента.
Четыре механизма для структурированных входов
Стандартные байтовые мутаторы AFL (перевороты битов, арифметика, сращивание блоков) хорошо работают на бинарных форматах, но плохо справляются со структурированными текстовыми входами, а классическое решение — руками писать кастомный мутатор под каждый формат — работа скучная. Поэтому конвейер несёт четыре взаимодополняющих механизма для получения структурированных входов. В README репозитория они описаны как мутаторы и словари под конкретные форматы, структурно-осознанное сращивание токенов и улучшение харнессов на основе покрытия.
Первый — готовые словари и кастомные мутаторы под распознанные форматы: JSON, XML, регулярные выражения, PNG и бинарный TLV с префиксом длины. Мутатор JSON делает сращивание токенов и дублирование сбалансированных скобок, XML знает о тегах, сущностях и токенах billion-laughs, а мутатор регулярных выражений несёт реальные ReDoS-паттерны; при этом каждый мутатор отдаёт половину мутаций обратно стандартному байтовому мутатору AFL, чтобы не воевать с рандомизацией движка.
Второй — словарь на уровне исходников: для форматов, которые конвейер не распознал, он генерирует кастомный мутатор на лету, сканируя собственные.c- и.h-файлы цели, вытаскивает строковые литералы и 32-битные числовые константы из #define, case и enum, отфильтровывает шум и использует их как токены для сращивания. Интуиция простая: самые интересные магические значения, которые проверяет парсер, обычно где-то в его же исходниках и записаны.
Третий — динамически пополняемый словарь AFL с обогащением по покрытию: тот же набор токенов выгружается как классический словарь ещё до первой итерации, причём числовые константы в обоих порядках байтов, чтобы фаззер мог удовлетворить сравнение четырёх байтов независимо от порядка. После каждого шага по покрытию конвейер смотрит на проверки рядом с непокрытыми строками — strncmp, memcmp, case 0xN, == 'X' — и дописывает найденные токены, так что словарь буквально растёт в сторону кода, до которого фаззер пока не дотягивается. Четвёртый механизм — оператор сращивания корпуса: умный мутатор умеет загружать файлы из каталога корпуса и вставлять случайные подрегионы из них во вход, что плохо даётся стандартному режиму havoc.
Корпус, который переживает кампании
Одна из вещей, которая тихо убивает эффективность фаззинга, — выбрасывание прогресса: если каждый прогон начинается с исходных сидов, вы снова и снова платите за переоткрытие одних и тех же путей. Поэтому у каждого харнесса есть стабильный каталог корпуса, который переживает итерации и целые кампании. В конце каждой итерации очередь AFL вливается в этот каталог и прогоняется через afl-cmin, чтобы размер оставался ограниченным. Эффект в том, что вчерашние интересные входы переходят в сегодняшний прогон, а найденное в кампании прошлой недели — в текущую: если остановить кампанию и запустить её заново, не теряется ничего.
От краша до отчёта с вердиктом
Найти краш — половина дела: разбор первопричины, как знает каждый, кто этим занимался, обычно самая утомительная часть всего процесса, и это второе место, где выигрывает агент. После завершения цикла фаззинга автоматически идут три стадии. Сначала каждый краш минимизируется через afl-tmin, проигрывается под ASan для получения стектрейса и дедуплицируется по хешу вершины стека: верхние нормализованные кадры сравниваются со снятыми шаблонами, инлайн-пространствами имён и LTO-суффиксами, чтобы семантически одинаковые краши схлопывались вместе. Затем ранее известные краши проигрываются против текущего бинарника, чтобы понять, снял ли их апстримный фикс. Наконец, агент читает исходник харнесса и падающую функцию, проходит цепочку вызовов назад от публичного API и пишет markdown-отчёт по каждому крашу.
Каждому отчёту присваивается один из вердиктов: vulnerability, library_hardening, harness_bug, OOM, timeout, assertion_failure, duplicate. Разница между настоящей уязвимостью — достижимой и эксплуатируемой через публичный API — и просто багом в собственном харнессе как раз того рода, для которого раньше приходилось руками трассировать код. В каждый отчёт входят анализ первопричины со ссылками file:line, аргумент достижимости, оценка эксплуатируемости, предложенное исправление в виде unified diff и набросок регрессионного теста.
Оговорка от автора: предложенные патчи помечены как «требуется ревью» не случайно — анализ агента ограничен тем, как модель понимает целевой код, и ошибается она тоже умеет; вердикты стоит воспринимать как очень хорошо подготовленную отправную точку для человека, а не как финальный результат.
Дашборд и приглашение попробовать
Чтобы автономная кампания не была чёрным ящиком, конвейер публикует всё на живой HTML-дашборд, который сам поднимается в фоне сразу после запуска кампании на порту 8765; в Codespace этот порт пробрасывается автоматически, так что прогресс можно смотреть в браузере в реальном времени. Среди прочего страница показывает пульс «работает» по каждому харнессу, таблицу трендов покрытия со встроенными спарклайнами, тепловую карту крашей и таймлайн итераций.
В заключении автор объясняет мотивацию: фаззинг работает, но не масштабируется без человеческого внимания, а это внимание и есть узкое место. Fuzzing Taskflow — попытка сдвинуть это узкое место, отдав рутинные части (написание харнессов, чтение покрытия, погоню за пробелами, разбор крашей) LLM-агенту, сохраняя чистое разделение между суждениями агента и инструментами, которые делают реальную работу. Мейнтейнерам проектов на C/C++ автор предлагает попробовать: если проект никогда не фаззился, инструмент поможет быстро начать, а если фаззился — может помочь найти новые баги за счёт роста покрытия; исходный код открыт, и автор ждёт issues и contributions. Тем, кто только знакомится с фаззингом, GitHub Security Lab предлагает курс Fuzzing 101.
Первоисточники
- GitHub Blog — «AI-powered fuzzing with the GitHub Security Lab Taskflow Agent» (Antonio Morales, 24 сентября 2026)
- GitHub — GitHubSecurityLab/seclab-taskflows-fuzzing: официальный репозиторий Fuzzing Taskflow
- GitHub — GitHubSecurityLab/seclab-taskflow-agent: официальный репозиторий фреймворка Taskflow Agent