Исследования
ARTPARK-IISc разметила 106 892 шумовых события в индийской речи с точностью до миллисекунд
Команда ARTPARK-IISc опубликовала на Hugging Face слой аннотаций поверх корпуса Project Vaani: шум записывался вместе с речью, а не подмешивался синтетически, и у каждого события есть точные границы. Текущий релиз — 90 637 сегментов и 58 индийских языков; статья и карточка датасета описывают объём по-разному, и расхождение объясняется составом наборов.
Что опубликовано
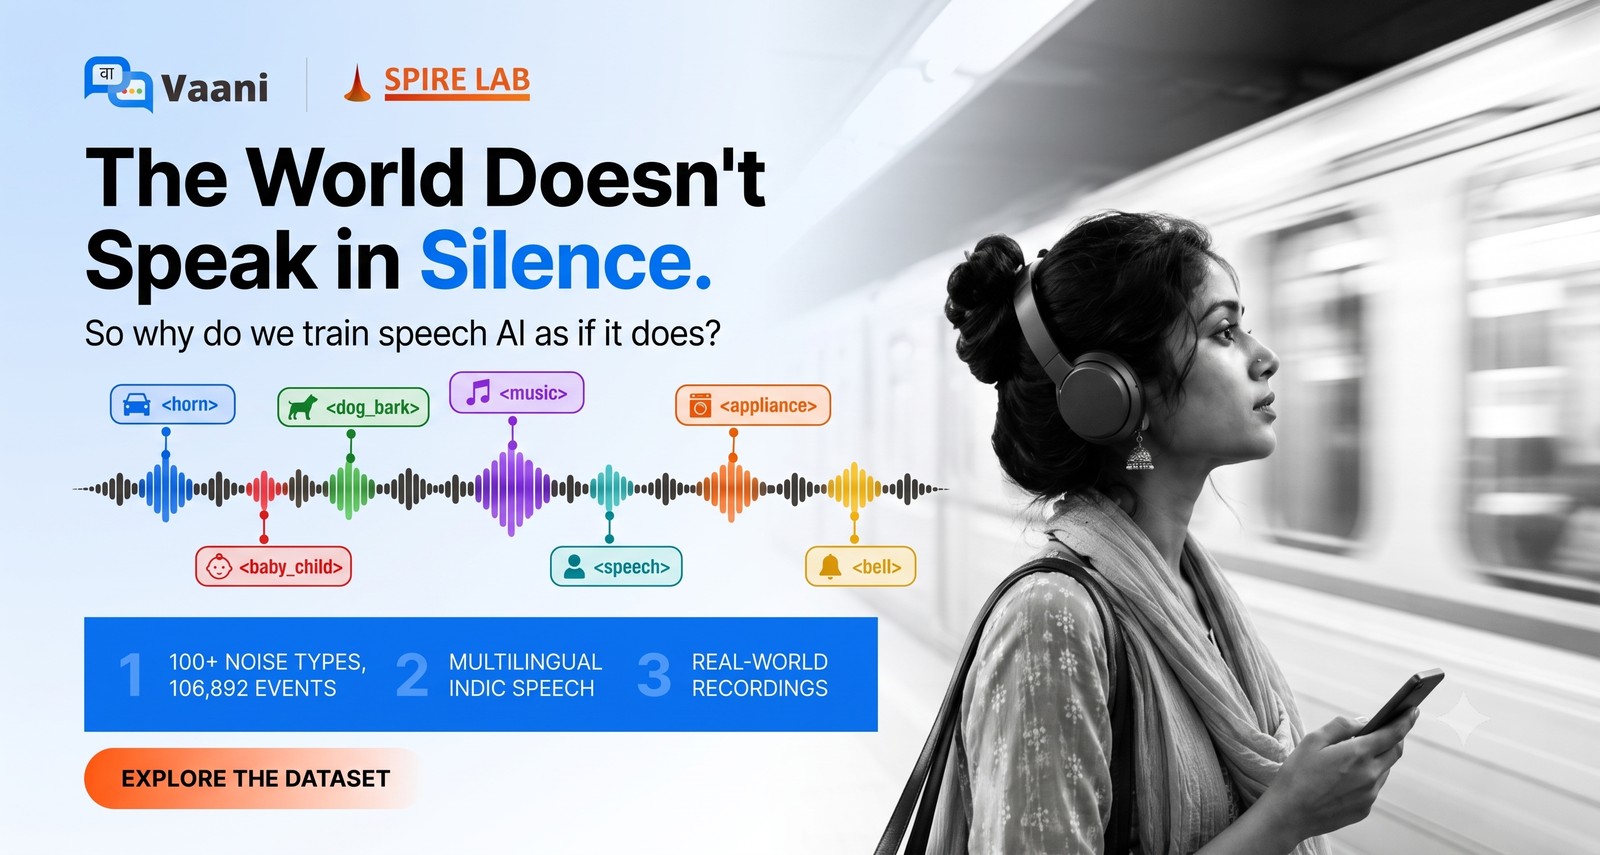
Команда ARTPARK-IISc выпустила Vaani Noise Event Timestamp Dataset — слой аннотаций поверх Project Vaani, инициативы IISc Bangalore и ARTPARK по многоязычной индийской речи. Это производный набор с разметкой шумовых событий: каждая запись указывает категорию фонового шума и точные время начала и конца внутри аудио. В сопровождающей статье приводится объём проделанной работы — 106 892 реальных шумовых события, размеченных до миллисекунд.
Мотивация сформулирована как разрыв между лабораторией и реальностью. По утверждению авторов, большинство речевых наборов записаны в студийных или близких к чистым условиях, поэтому обученные на них модели молча предполагают, что мир тихий.
Почему синтетический шум не закрывает задачу
Обычное решение — синтетическое микширование, когда поверх чистой речи накладывается отдельный шумовой клип. Такой звук становится шумным на слух, но теряет главное — когда именно шум возникает относительно произносимых слов. Синтетический шум ведёт себя неестественно: соотношение сигнал/шум выставляется вручную, шум начинается и обрывается резко, а пересечение с речью сконструировано, а не реально. Даже индийские наборы вроде Kathbath-Noisy дают шумную речь для оценки устойчивости ASR, но не размечают ни тип шума, ни его положение в аудио.
Как устроена разметка
В Vaani речь и шум записаны вместе — в одном месте, в одно время, на обычные мобильные телефоны в полевых условиях, без синтетической вставки шума и постобработки. Аннотаторы отмечали каждое фоновое событие точным временем начала и конца, вплоть до миллисекунд. Поскольку записи реальные, шумы перекрываются с речью и друг с другом, как в настоящем разговоре: собака может залаять посреди фразы, под гулом транспорта, а сверху зазвонит телефон.
Технически метки лежат в поле NoiseSubCategoryTimeStamp: для каждого события указаны категория, встроенный в транскрипт тег вида <horn>, начало и конец в секундах от старта клипа. В примере из карточки датасета сигнал horn из записи, сделанной в Аруначал-Прадеше, длится с 0,013 до 1,399 секунды, а категория указана как vehicle_traffic. Один клип может содержать несколько перекрывающихся шумовых событий из разных категорий.
Семь категорий и структура шума
Шумы разложены по семи верхнеуровневым категориям с таймстемпами подкатегорий: животные, транспорт, младенцы и дети, пение и музыка, сигналы телефона и будильников, бытовая техника и механизмы, а также неречевые человеческие звуки. Речевые записи охватывают 58 индийских языков, 30 штатов и 162 района.
Распределение шума оказалось неравномерным, и именно границы событий делают это заметным. Неречевые человеческие звуки — кашель, смех, причмокивание — самый частый тип: они встречаются примерно в 38 % сегментов, но длятся в среднем меньше половины секунды. Животные и транспорт встречаются реже, зато звучат дольше и вместе дают наибольшую долю общего времени шума в наборе. Авторы подчёркивают, что разделение «часто и коротко против редко и долго» становится видимым только тогда, когда у каждого события есть начало и конец.
Покрытие языков намеренно широкое: от хинди и телугу до малоресурсных чакма, гаро и мизо. Хинди доминирует — почти 84 часа, но длинный хвост языков сохранён специально, чтобы исследования устойчивости к шуму не смещались в сторону только самых распространённых языков.
Две публикации — две разные цифры объёма
Статья и карточка датасета описывают объём по-разному, и расхождение стоит показать явно. В статье указаны 122 с лишним часа аудио, 72 756 речевых сегментов, 38 541 диктор, 58 языков и покрытие 30 штатов и 162 районов. Карточка датасета описывает текущий релиз иначе: 90 637 сегментов общим объёмом около 154,6 часа, из которых verified_timestamps — 11 111 сегментов (примерно 21,8 часа), unverified_timestamps — 61 642 сегмента (примерно 100,3 часа), а no_timestamps — 17 884 сегмента (примерно 32,4 часа).
Разница объясняется составом наборов. Два размеченных по времени набора вместе дают примерно 21,8 + 100,3 ≈ 122,1 часа и 11 111 + 61 642 = 72 753 сегмента, что совпадает с числами статьи. Иначе говоря, статья описывает подмножество с таймстемпами, тогда как релиз дополнительно включает около 32,4 часа записей, где категория шума размечена, но границ событий нет. Отдельно 10 часов verified_timestamps вынесены в отложенный набор для оценки, не пересекающийся по дикторам, и в этот релиз не входят.
Контроль качества и границы применимости
Каждый таймстемп проходит многоступенчатый человеческий контроль: аннотирование фрилансерами, проверку на здравость, внутреннюю перепроверку и случайный независимый аудит 10 % перед выпуском. Порог намеренно жёсткий — если аудит не проходит хотя бы один таймстемп, вся партия переделывается. Наборы разделены на два явно помеченных уровня: verified_timestamps, где границы подтверждены согласием нескольких аннотаторов, и unverified_timestamps, где согласие между аннотаторами не проверялось.
Авторы сравнили Vaani с девятью крупными существующими наборами, включая WHAM!, AudioSet, MUSAN, CHiME-6 и FSD50K, и утверждают, что ни один из них не соединяет реальный совпадающий по времени шум, миллисекундные таймстемпы и естественную многоязычную индийскую речь. Индийские iNoise и Kathbath-Noisy существуют, но не соединяют шум с естественной совпадающей речью. Практический аргумент — стресс-тест систем, которые реально работают в индийских домах, на улицах и в полях: линия IVR, голосовой ассистент, агро-консультант.
Датасет опубликован на Hugging Face под лицензией cc-by-4.0 с доступом после принятия условий; общий размер файлов — 17,7 ГБ. Карточка ссылается на статью VAANI (arXiv 2603.28714) и перечисляет задачи, для которых предназначен набор: детекция звуковых событий, классификация аудио, распознавание речи, устойчивое к шуму, и подавление шума.