Исследования
«Первые токены несут общий смысл клипа, детали приходят позже»: Stability AI представила SemanTok — видео-токенизатор, который обходит модель в 3,4 раза крупнее
7 октября 2026 года Stability AI опубликовала исследование SemanTok — видео-токенизатора переменной длины для авторегрессионной генерации видео. Метод подаёт в кодировщик замороженные признаки DINO и добавляет лёгкие головы, которые восстанавливают их из каждого сохранённого префикса токенов. Авторегрессионная модель всего на 201 млн параметров догоняет или обходит VideoFlexTok, которая в 3,4 раза крупнее.
Что предложила Stability AI
SemanTok — это видео-токенизатор, то есть та часть системы генерации видео, которая превращает клип в последовательность токенов и обратно. Ставка в исследовании сделана на выбор токенизатора: именно он определяет, насколько хорошо видео-модель одновременно держит визуальную верность и смысл сцены.
Речь идёт о классе моделей, которые Stability AI описывает как «world models» на видео: они соединяют масштабируемость авторегрессионного (AR) предсказания с визуальным качеством диффузионных моделей. В такой схеме AR-модель предсказывает токены клипа по времени и от грубого к детальному, а декодер превращает полученный префикс токенов в видео.
Проблема, которую формулируют авторы, — в существующих гибких токенизаторах переменной длины. Идея грубо-детальной последовательности работает: первые грубые токены несут глобальную семантику клипа, а более поздние уточняют детали. Но существующие гибкие токенизаторы применяют выравнивание представлений (REPA-лосс) только к ранним скрытым состояниям декодера — цель, которую декодер может частично закрыть собственным зашумлённым входом.
Как устроен SemanTok
SemanTok берёт рецепт VideoFlexTok и меняет вход кодировщика: в него попадают замороженные признаки DINO, а лёгкие головы учатся восстанавливать их из каждого сохранённого префикса токенов по отдельности. Иными словами, семантический сигнал встроен в обучение токенизатора, а не добавляется поверх готового декодера.
Архитектурно схема выглядит так: замороженный VAE VidTok переводит клип в латенты, патчи каждого кадра проецируются и упаковываются вместе с обучаемыми register-токенами и чередуются по времени. Причинно-временной кодировщик обрабатывает эту последовательность и отдаёт в FSQ только выходы register-токенов; nested dropout формирует оставленный префикс токенов, который затем подаётся в причинно-временной декодер, восстанавливающий латенты под flow-matching.
К базовой ветке авторы добавляют семантическое наблюдение от замороженного учителя: признаки учителя попадают в кодировщик, и каждый сохранённый префикс обучается их предсказывать — за это отвечают головы Dense DINO и Class DINO.
Что показывают замеры
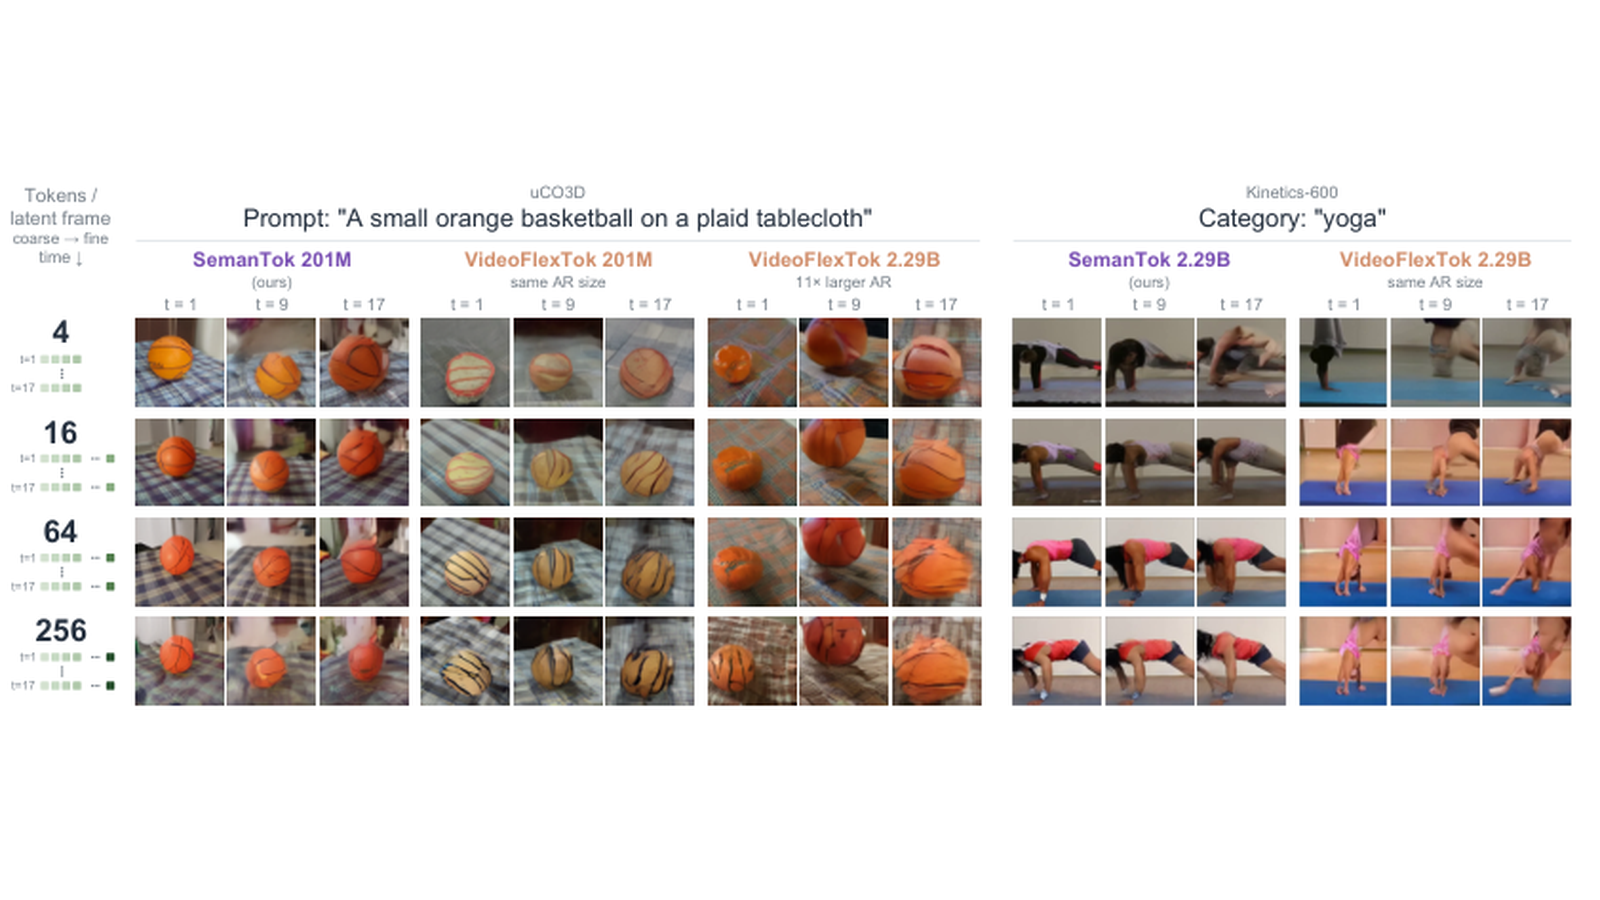
Главное сравнение, которое Stability AI выносит в первый пример: на запрос про «оранжевый баскетбольный мяч» токенизатор SemanTok позволяет авторегрессионной модели на 201 млн параметров сгенерировать видео, где форма и внешний вид мяча сохраняются на всём облёте, при бюджете всего в k=4 токена на латентный кадр. У VideoFlexTok при том же размере модели мяч семантически рассогласован, и даже в 11 раз более крупная AR-модель (2,29 млрд параметров) не удерживает его форму вплоть до k=64. То есть меньшая и более быстрая модель на токенах SemanTok догоняет или обходит крупную модель на токенах VideoFlexTok.
Авторы подчёркивают закономерность, которая повторяется при любом размере AR-модели: SemanTok даёт высокое семантическое согласование и верность видео, а крупные модели на его токенах ещё улучшают верность. При этом разрыв в семантическом согласовании между двумя подходами не закрывается с ростом модели — он закрывается медленнее, чем разрыв в верности.
Замеры идут на двух наборах: Kinetics-600 и uCO3D. SemanTok улучшает генерацию при каждом вычислительном бюджете на обоих, а его огибающая лучшего результата при заданных вычислениях лучше на большей части диапазона — при том что каждая кривая перебирает бюджет токенов k от 1 до 256 на кадр.
Почему это важно на практике
Ключевая практическая выгода — в коротком префиксе. Короткие префиксы токенов дешевле предсказывать, и именно они дают лучшую верность генерации, а пиксельные детали отложены на более поздние токены. Для видео это означает, что грубая, но уже осмысленная версия клипа появляется раньше и стоит меньше вычислений.
Отдельно авторы отмечают устойчивость семантического согласования: модель сохраняет его на классах вне распределения обучения и даёт декодеру более высокое согласование на каждом уровне шума, включая чистый шум.
Рамка
Это публикация самой Stability AI о собственном исследовании: все приведённые числа — замеры авторов, независимой проверки извне у них нет, а сравнения сделаны на выборках и метриках, которые выбрали сами авторы.
Отчёт подписали Михаил Деревянных (Mikhail Dereviannykh), Викрам Волетти (Vikram Voleti), Саймон Донн (Simon Donne), Малликарджун Байрасандра Рамалинга Редди (Mallikarjun Byrasandra Ramalinga Reddy), Шимон Вайнер (Shimon Vainer) и Марк Босс (Mark Boss). Технический отчёт подан на arXiv 30 сентября 2026 года, страница исследования на сайте Stability AI датирована 7 октября 2026 года.