Исследования
Одна песочница на попытку: как лаборатории обучают агентов в 2026 году
Разбор Hugging Face сопоставил пятнадцать отчётов тринадцати лабораторий и показывает, что среда обучения перестала быть симулятором внутри тренировочного цикла и стала отдельной машиной: контейнер поднимается под одну попытку, а на масштабе счёт идёт на сотни тысяч одновременных песочниц.
Что именно разобрали
Статья Sergio Paniego в блоге Hugging Face вышла 11 сентября 2026 года и закрывает серию разборов о подготовке агентных моделей: до неё были материалы о дистилляции и об обучении по результату. Материал сопровождает четвёртое занятие серии Training Agents, где обучение кодирующих агентов показывали на TRL и OpenEnv.
Основа разбора — пятнадцать отчётов и релизных постов от тринадцати лабораторий, опубликованных с октября 2025 по сентябрь 2026 года: GLM-5 и GLM-5.3, Kimi K3, MiniMax, Nemotron 3 Ultra, OLMo 3, DeepSeek, Qwen3.8, Inkling, LFM2.5, MAI-Thinking-1, GPT-5.6 и GPT-6 Astra, а также Composer от Cursor и Code World Model от Meta. Автор отдельно оговаривает, что считал только то, на чём лаборатория заявляет обучение, а не то, на чём она лишь проводит замеры.
Одна машина на одну попытку
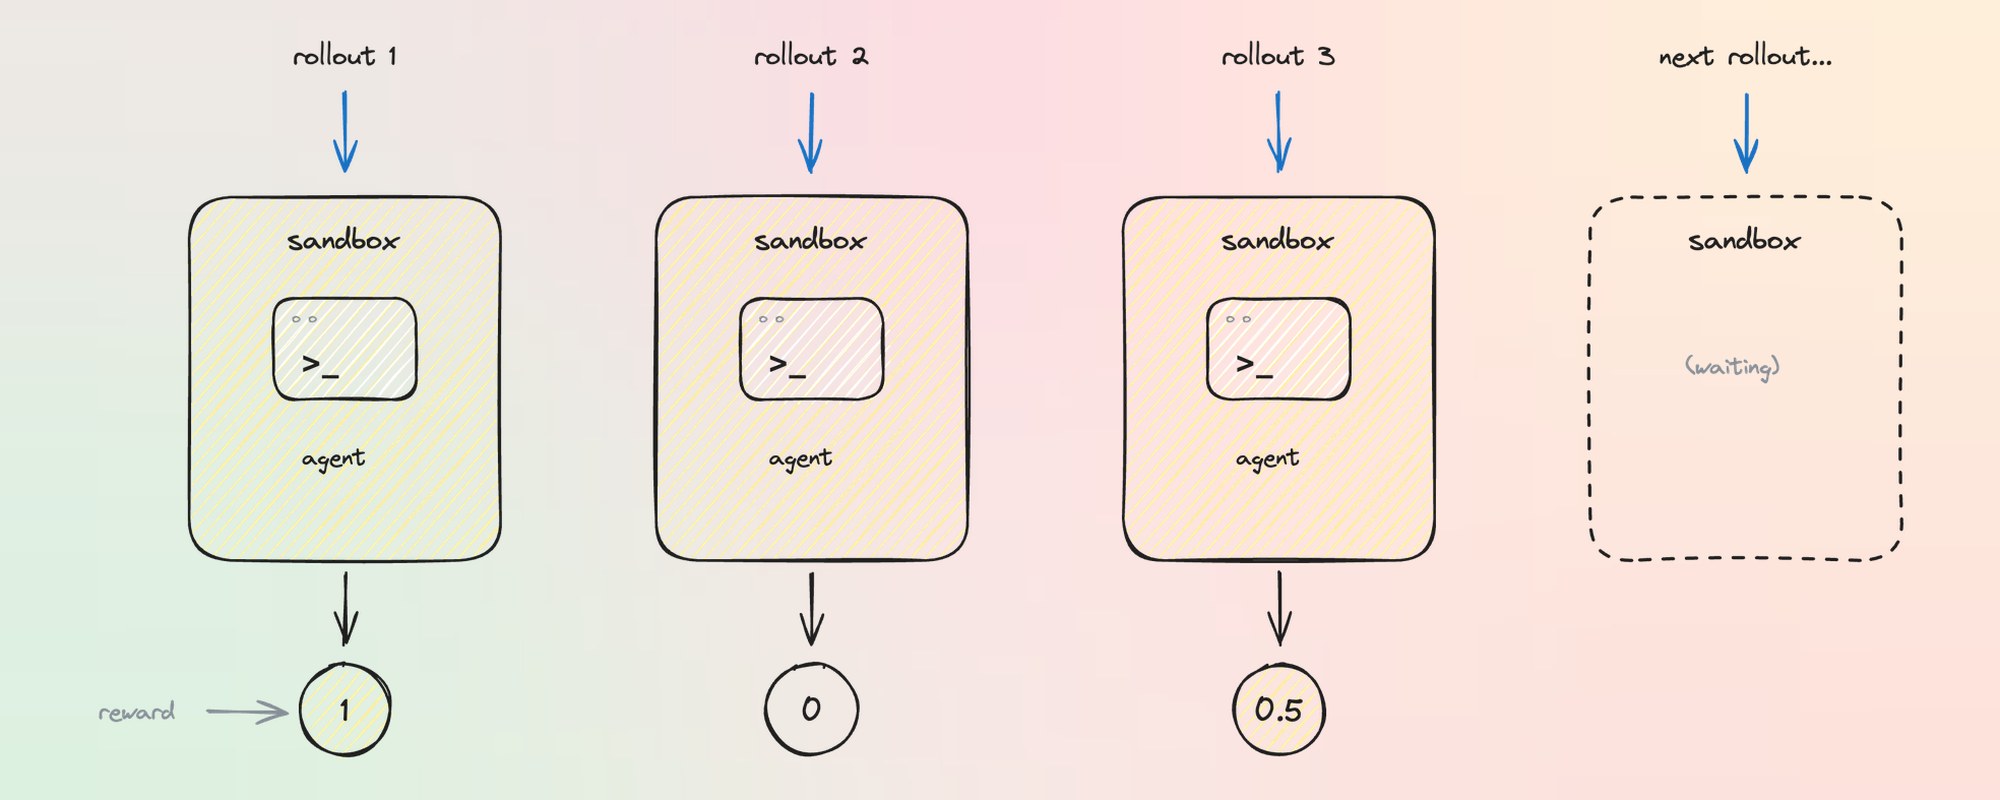
В классическом обучении с подкреплением среда была симулятором внутри тренировочного процесса: вызов reset начинал попытку, step двигал её дальше, всё происходило в памяти, а новая попытка стоила почти ничего. Такая схема масштабировалась запуском тысяч копий одного симулятора в одном процессе.
Для агента это не работает: чтобы модель ставила пакет, прогоняла тесты или правила репозиторий, среде нужно быть настоящим компьютером с файловой системой, оболочкой и процессами, которые живут между вызовами. В итоге среда перестала быть объектом в памяти тренера и стала машиной, состояние которой принадлежит одной попытке: её загружают, используют один раз и уничтожают. Именно эта попытка от промпта до награды и называется rollout.
Формулировки лабораторий почти совпадают. Liquid AI для модели LFM2.5-2.6B пишет прямо: задача сэмплируется, к ней случайно подбирается harness, и каждая попытка идёт в отдельной песочнице со своей средой исполнения. В отчёте Microsoft по MAI-Thinking-1 сказано ещё буквальнее: слой песочниц создаёт свежий контейнер под каждую агентную задачу и уничтожает его по её завершении.
Масштаб у верхней границы тоже назван числами. Cursor описывает обучение своей модели Composer так: на их масштабе обучение эффективному вызову инструментов требует сотен тысяч одновременных песочниц с кодирующими средами в облаке. Ради этой нагрузки компания переписала планировщик виртуальных машин, приспособив инфраструктуру, которую уже построила для Background Agents.
Длинные задачи требуют противоположного поведения. Kimi K3 заявляет среди ключевых возможностей агентное обучение с подкреплением на миллион токенов с сохраняемым состоянием rollout и песочниц, а в отчёте речь идёт о возобновляемых microVM, которые удерживают долгоживущее состояние модели и среды.
Что складывают внутрь песочниц
По содержимому среды разбор выделяет три повторяющихся типа, и лидирует код. GLM-5 даёт самую наглядную цифру: свыше 10 тысяч проверяемых сред в тысячах репозиториев на девяти языках программирования. MiniMax строит конвейер, превращающий реальные сценарии программирования в набор проверяемых терминальных задач.
Почти так же часто встречается поиск: Kimi K3 обучается на многошаговом исследовании, где модель планирует разбор, пошагово собирает доказательства в вебе и выдаёт проверяемый ответ. Третий тип — обычная офисная работа: MiniMax организует среды вокруг глубокого поиска и веб-исследования, задач знания-работника, финансового анализа и операций с таблицами, а также генерации слайдов, а Kimi доходит до реалистичных макетов Gmail, Notion, Slack и Canvas для практики агента.
Отдельная деталь, которой нет больше ни у кого: Kimi добавляет набор задач по GPU-ядрам — от одиночных операторов до слитых мега-ядер.
Harness сам становится средой
Следующий слой — контракт, через который агент действует. У Kimi среда может поднимать мейнстримные harness'ы: Kimi Code, Claude Code, Codex, OpenClaw и Hermes, то есть модель обучается внутри реконструкций тех же агентов, которыми пользуются люди, — это называется white-box. Liquid приходит к тому же с другой стороны: прокси позволяет считать агентные harness'ы чёрными ящиками без изменений и при этом прозрачно снимать токенные траектории, нужные для воспроизведения и проверки обучающих примеров.
Исследовательская работа Microsoft Agent Lightning называет этот приём harnessed agentic RL: цикл взаимодействия со средой принадлежит harness'у, а не тренировочному движку. Тот же механизм на масштабе описан в Polar — harness остаётся чёрным ящиком, а траектории восстанавливаются с точностью до токенов. Inkling, первая открытая модель Thinking Machines, обучалась работе внутри разных кодирующих и агентных harness'ов, причём набор инструментов и схема рандомизировались во время обучения, чтобы модель меньше зависела от конкретного варианта.
Среды, которые строят агенты
Самый свежий паттерн — синтез сред агентами. Z.ai описывает конвейеры, которые собирают окружения целиком: исследовательские агенты превращают закономерности реальной работы в запускаемые долгосрочные среды со скрытым состоянием, судья-агент пробует каждую задачу на решаемость, а верификатор выпускается только после проверок на эталонное решение, пустое действие и нерешённое состояние.
Zhipu прямо называет предел подхода: такие конвейеры всё ещё требуют заметного объёма работы человека в цикле. Именно там же сформулирован общий сдвиг: по мере роста агентных способностей значительная часть сложности масштабирования пост-обучения переезжает с модели на среду.
Прозрачность распределена неравномерно. Открытые лаборатории — Kimi, GLM, MiniMax, NVIDIA — описывают среды подробно: Ai2 в отчёте по OLMo 3 доходит до счёта в 17,2 млн сгенерированных примеров кода, проверенных в параллельных изолированных средах. OpenAI, Anthropic и Google об обучении внутри сред почти не публикуют: в системной карте GPT-5.6 перечислены среды, но все они относятся к оценке, а про обучение с подкреплением сказана одна общая фраза, и системная карта GPT-6 Astra повторяет тот же шаблон одним предложением. DeepSeek и Qwen занимают промежуточное положение: DeepSeek описывает платформу песочниц вплоть до сотен тысяч песочниц на кластер, а Qwen3.8 заявляет обучение с подкреплением, масштабированное на среды с миллионом агентов, не называя, что именно внутри работает.
У каждой лаборатории свой стек
В алгоритмах и дистилляции лаборатории сходятся на общих рецептах, а вот инфраструктуру окружений каждая описывающая её лаборатория собирала сама. GLM-5 обучается на slime, где асинхронная схема разделяет генерацию и обучение: генерация идёт своими движками в своём темпе, обучение потребляет результат, и ни одна сторона не ждёт другую. Позже GLM-5.3 показала, что это дало: среды подключаются к slime как генерация данных, а не как изменения тренировочного цикла, что позволило добавлять окружения без пересборки всего стека.
У MiniMax для длинных агентных траекторий построен Forge, который принимает в одном цикле обучения и white-box, и black-box агентов. Nemotron 3 Ultra от NVIDIA заявляет multi-environment RLVR — проверяемые награды, посчитанные сразу по нескольким средам за один прогон. Inkling дообучалась крупномасштабным обучением с подкреплением более чем на 30 млн попыток.
Обобщая, разбор сводит всё к четырём частям: задача со встроенным верификатором, контракт взаимодействия (всё чаще сам harness), песочница для запуска и тренер, который потребляет попытки, не дожидаясь самой медленной. Вывод SemiAnalysis, на который ссылается автор, звучит так: обучение с подкреплением — в такой же степени инфраструктурная задача, как и алгоритмическая.
Что из этого стека уже открыто
Часть стека публична: slime и verl — открытый код, а закрытыми остаются сами среды, данные задач и вычисления на сотни тысяч песочниц. Остальные слои собираются заново как публичные артефакты. Для задач — Environments Hub от Prime Intellect поверх библиотеки verifiers, Harbor с разделением задачи, harness'а и песочницы, а также Repo2RLEnv, превращающий любой репозиторий на GitHub в проверяемые задания.
Роль стандарта для самих сред играет OpenEnv: он стандартизирует контракт в стиле Gymnasium — reset, step, state — поверх HTTP, чтобы среды поставлялись как артефакты на Hub; на момент публикации более 4 тысяч Space'ов на Hub несут тег openenv. Под песочницами Moonshot открыла AgentENV — распределённую систему для запуска агентных сред на масштабе, а Hugging Face Sandboxes остаются экспериментальным вариантом для упаковки множества лёгких CPU-песочниц на общих хостах.
На стороне тренера TRL подключается к среде одним аргументом через GRPOTrainer, а экспериментальный AsyncGRPOTrainer разводит генерацию попыток и обучение — тот же приём, который GLM-5 приписывает slime.